
1. ACL 2026 학회 개요
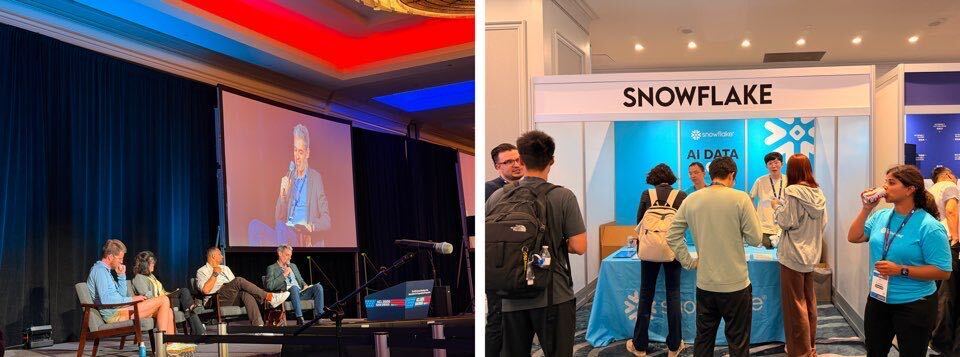
ACL(Association for Computational Linguistics)은 자연어 처리(NLP)와 전산언어학 분야에서 세계 최고 권위를 인정받는 최상위 국제 학술대회입니다. 전 세계의 연구진과 산업계 전문가들이 모여 초거대 언어 모델, 기계 번역, 음성 인식 등 최신 연구 성과를 공유하며, 엄격한 피어 리뷰를 통과한 논문들이 구두 및 포스터 발표 세션을 통해 집중적으로 공개됩니다. 또한, AI 윤리, 환각 현상 극복, 차세대 언어 지능 등 학계의 핵심 쟁점과 향후 연구 방향을 두고 석학들이 치열하게 의견을 나누는 패널 토론이 마련되어 연구 트렌드를 한눈에 조망할 수 있습니다.
학술적 논의를 넘어 산업계와의 실질적인 연결 고리 역할도 수행합니다. 글로벌 빅테크 기업과 유망 AI 스타트업들이 대거 참여하는 기업 부스에서는 자사의 최신 상용화 기술 시연과 제품 홍보뿐만 아니라 석·박사급 핵심 인재 영입을 위한 현장 리크루팅이 활발히 진행됩니다. 이와 함께 환영 리셉션, 소셜 디너, 멘토링 세션 등 다양한 네트워킹 프로그램을 통해 참가자들은 소속과 국경을 넘어 공동 연구 기회를 모색하고 지속 가능한 학술적 협력 관계를 구축합니다.
2. 발표논문 소개
2-1. CURaTE: Continual Unlearning in Real Time with Ensured Preservation of LLM Knowledge
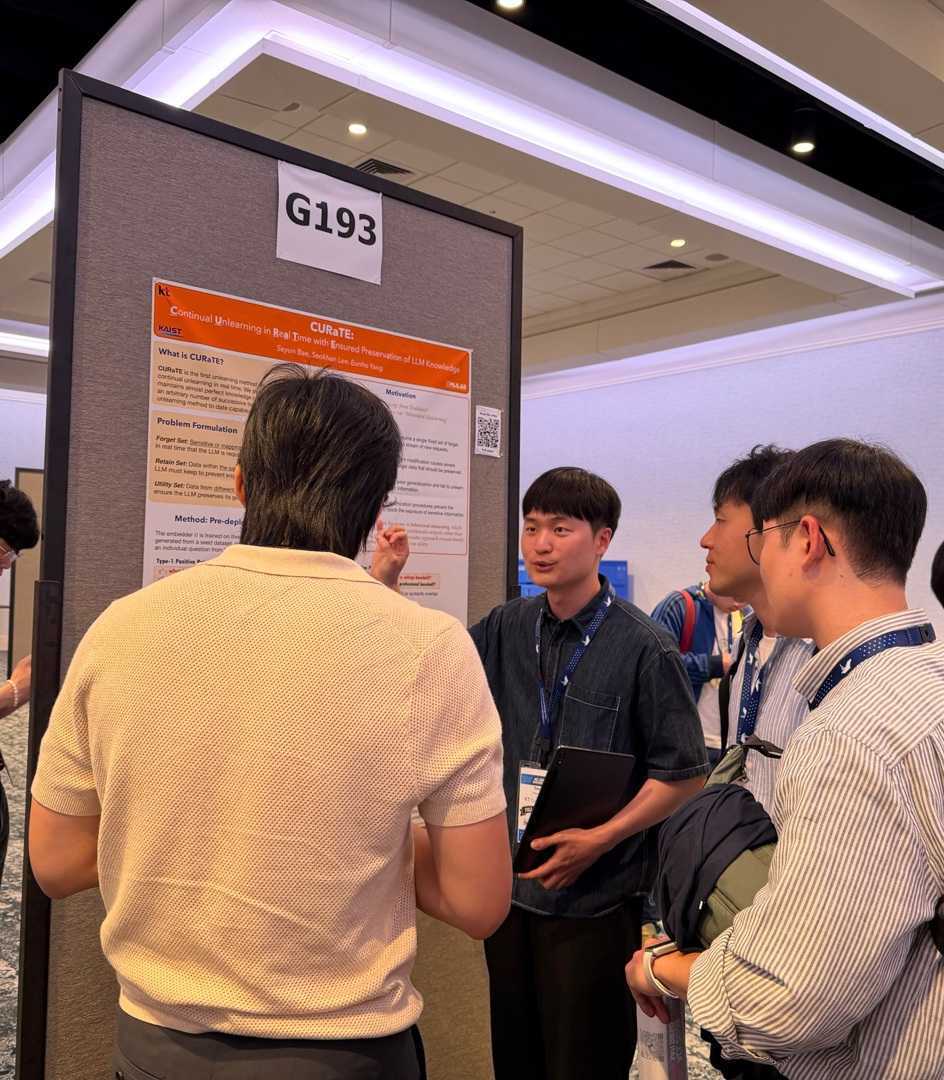
인공지능이 이미 학습한 특정 정보를 지우는 기술은 개인정보 보호와 잘못된 정보 삭제를 위해 중요하지만, 기존 방법은 모델의 내부 값을 직접 수정하기 때문에 삭제하려는 정보 뿐 아니라 정상적인 지식까지 함께 손상될 수 있다는 문제가 있습니다. 이 논문은 이러한 문제를 해결하기 위해 CURaTE라는 새로운 방법을 제안합니다.
CURaTE는 인공지능의 내부 지식을 직접 바꾸지 않고, LLM의 앞에서 가드레일과 같은 형샹으로 작동합니다. 사용자의 질문이 지워야 할 정보와 관련이 있는 지를 먼저 판단한 뒤 답변 여부를 결정합니다. 이를 위해 문장의 의미를 비교하는 별도의 임베딩 모델을 학습시킵니다. 이 모델은 같은 의미를 다른 말로 표현한 문장과 단어는 비슷하지만 의미가 다른 문장을 구분할 수 있도록 훈련됩니다. 실제 사용 중에 새로운 삭제 요청이 들어오면 vector DB에 해당 요청을 저장하고, 이후 사용자의 질문이 저장된 내용과 비슷하면 답변을 거부합니다. 반대로 관련이 없는 질문에는 LLM의 원래 답변으로 제공합니다. 개인정보, 가짜 작가 정보, 잘못된 정보, 과학 지식 등 네 가지 자료를 이용해 실험했습니다. 그 결과 CURaTE는 삭제해야 할 정보에 대해서는 높은 비율로 답변을 거부하면서도 삭제 대상이 아닌 일반 지식은 거의 그대로 유지했습니다. 기존 방법들은 정보를 여러 차례 삭제할수록 모델의 전체 성능이 떨어지는 경향을 보였지만, CURaTE는 열 차례에 걸쳐 삭제 요청을 처리한 뒤에도 성능 저하가 거의 나타나지 않았습니다. 또한 한 번의 삭제 요청을 처리하는 데 약 0.04초가 걸렸고, 사용자의 질문과 삭제 요청의 관련성을 판단하는 데 추가로 약 0.01초만 필요해 실시간 처리에도 적합한 것으로 나타났습니다.
이 방법의 가장 큰 장점은 대규모 언어 모델을 다시 학습시키거나 내부 구조를 수정하지 않아도 된다는 점입니다. 하지만 완벽한 정보 삭제를 보장하는 것은 아닙니다. 사용자가 질문을 교묘하게 바꾸거나 시스템을 속이는 방식으로 접근하면 삭제된 정보가 다시 노출될 가능성이 있으며, 수십만 개 이상의 삭제 요청이 쌓였을 때도 같은 성능을 유지할 수 있는지는 추가 연구가 필요합니다.
정리하면 본 논문은 인공지능의 지식을 직접 지우는 대신 질문을 분석해 답변을 제한하는 방식으로, 특정 정보는 효과적으로 숨기면서 나머지 지식은 보존할 수 있다는 가능성을 보여줍니다.
2-2. Diagnosing Latent Inefficiency in Chain-of-Thought
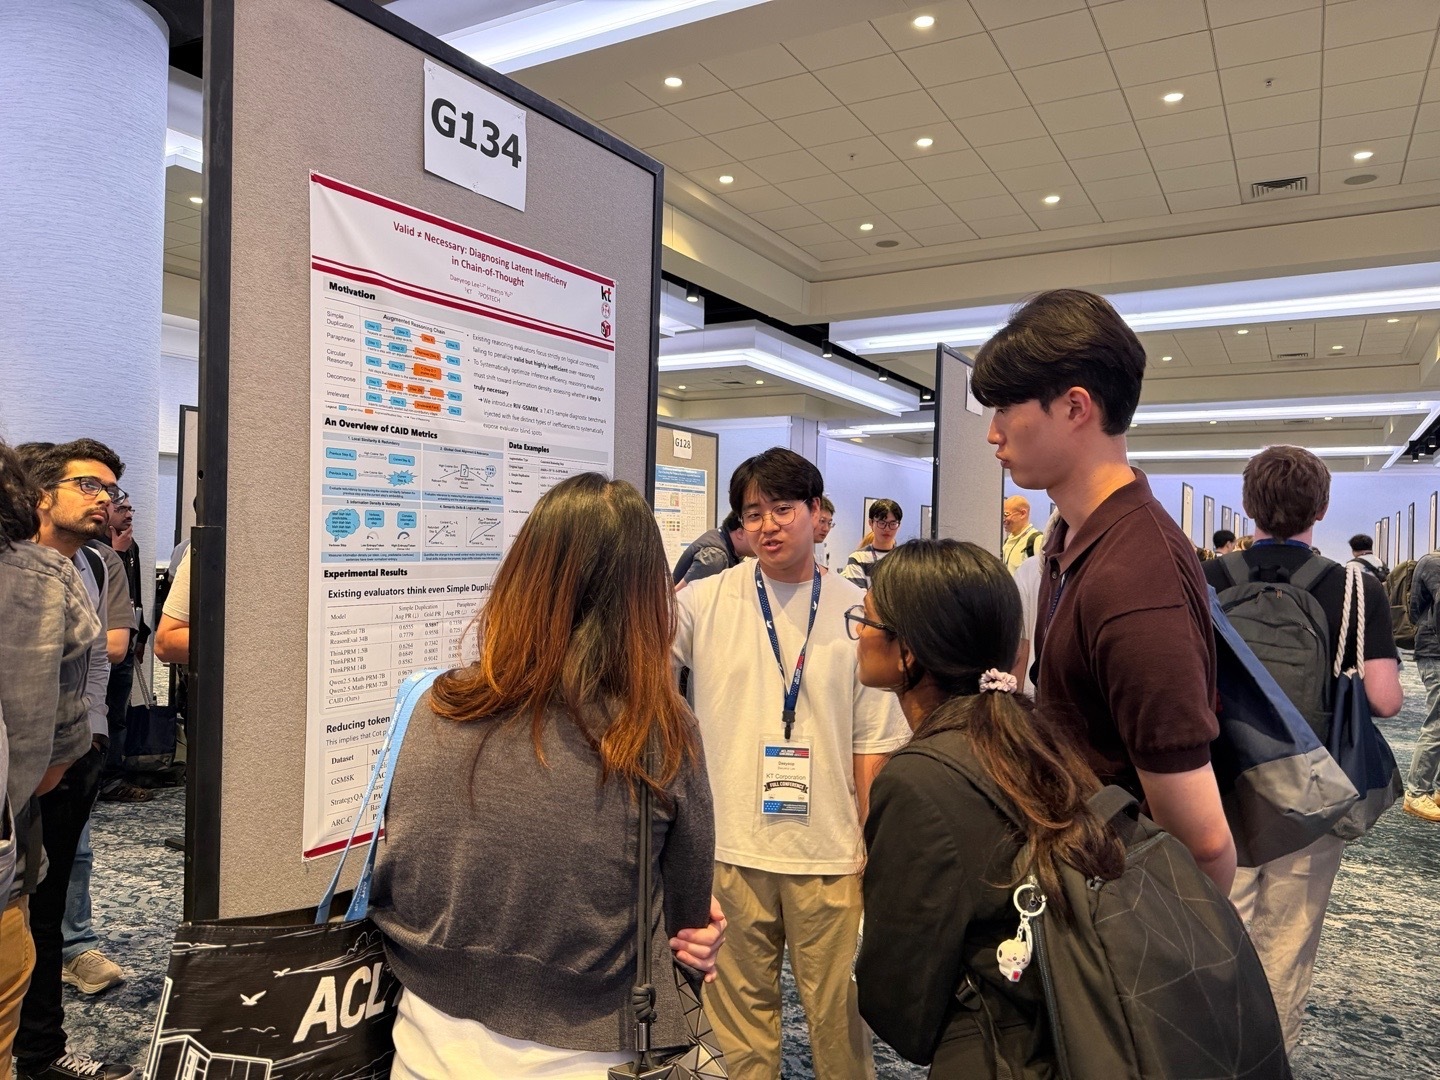
대형 언어 모델(LLM)은 생각의 사슬(Chain-of-Thought, CoT) 프롬프팅을 통해 복잡한 수학 및 논리 추론 영역에서 비약적인 성능 향상을 보여 왔습니다. 하지만 모델이 정답을 도출하는 과정에서 지나치게 장황하거나 불필요한 단계를 생성하는 '과도한 추론(over-reasoning)' 현상이 빈번하게 발생하며, 이는 막대한 연산 비용과 응답 지연을 초래합니다. 기존의 많은 연구가 최종 답변의 정답률을 높이는 데 집중해 왔으나, 실제 서빙 및 상용화 환경에서는 정확도뿐만 아니라 추론 과정의 효율성과 경제성을 함께 확보하는 것이 핵심 과제로 떠오르고 있습니다.
특히 기존의 추론 단계 평가 모델(Step-level Evaluators)들은 논리적 오류나 사실적 오류를 잡아내는 데에는 효과적이지만, 치명적인 사각지대를 가지고 있었습니다. 바로 논리적으로는 틀리지 않았으나 문제 해결에는 전혀 기여하지 않는 '타당하지만 비효율적인(valid but inefficient)' 단계를 전혀 감점하지 못한다는 점입니다. 이로 인해 모델이 불필요한 순환 논리를 반복하거나 단순 계산을 과도하게 쪼개어 토큰을 낭비하더라도 기존 평가 체계에서는 이를 '정상적인 추론'으로 간주하게 되며, 결과적으로 추론 효율이 크게 저하되는 문제가 발생합니다.
이러한 한계를 체계적으로 진단하기 위해 본 연구는 RIV-GSM8K라는 새로운 진단용 벤치마크를 제안합니다. RIV-GSM8K는 순환 추론(circular reasoning), 과도한 세부 분해(excessive decomposition) 등 대표적인 5가지 비효율 추론 유형을 주입하여 설계된 데이터셋입니다. 연구진이 최신 평가 모델들을 대상으로 실험한 결과, 기존 최고 수준(SOTA)의 평가자들조차 문제 해결에 꼭 필요한 핵심 단계와 겉보기에만 그럴듯한 잉여 단계를 제대로 구별하지 못한다는 사실을 확인하였습니다.
본 연구는 이러한 진단에 그치지 않고, 별도의 추가 학습 없이도 추론 단계의 실질적 효용성을 측정할 수 있는 CAID(Context-Aware Information Density) 지표를 제안합니다. CAID는 정보이론(Information Theory)을 기반으로 문맥 내 각 단계의 정보 밀도를 정량화하여 불필요한 저효용 단계를 정밀하게 식별해냅니다. 나아가 이를 실질적인 추론 경량화에 적용하기 위해 사후 압축 전략인 PACE를 함께 선보였습니다. GSM8K, StrategyQA, ARC-Challenge 등 다양한 벤치마크 실험 결과, PACE는 기존 PRM(Process Reward Model) 기반 압축이나 무작위 제거 방식에 비해 높은 압축률에서도 모델의 원래 정확도를 그대로 유지하면서 토큰 사용량을 31~53%까지 대폭 절감했습니다. 이는 CAID가 추론의 논리적 정합성을 해치지 않으면서 불필요한 '정보적 거품(froth)'만을 효과적으로 걷어낼 수 있음을 보여줍니다.
종합하면, 본 연구는 그동안 간과되었던 CoT의 잠재적 비효율성(타당하지만 불필요한 추론 단계)을 정밀하게 진단하고, 가벼운 무학습 평가 지표와 실용적인 압축 기법을 결합하여 해결책을 제시합니다. 이는 향후 LLM 추론 체계가 단순히 '논리적으로 타당한가(Valid)'를 넘어 '정말 필수적이고 효율적인가(Necessary)'까지 함께 고려해야 함을 보여주며, 비용 효율적인 실전형 추론 AI를 구축하는 데 매우 유의미한 가이드라인을 제공합니다.
2-3. PhaseMI: A Motivational Interviewing Dataset for Enhancing Phase Progression in LLM-based Counseling
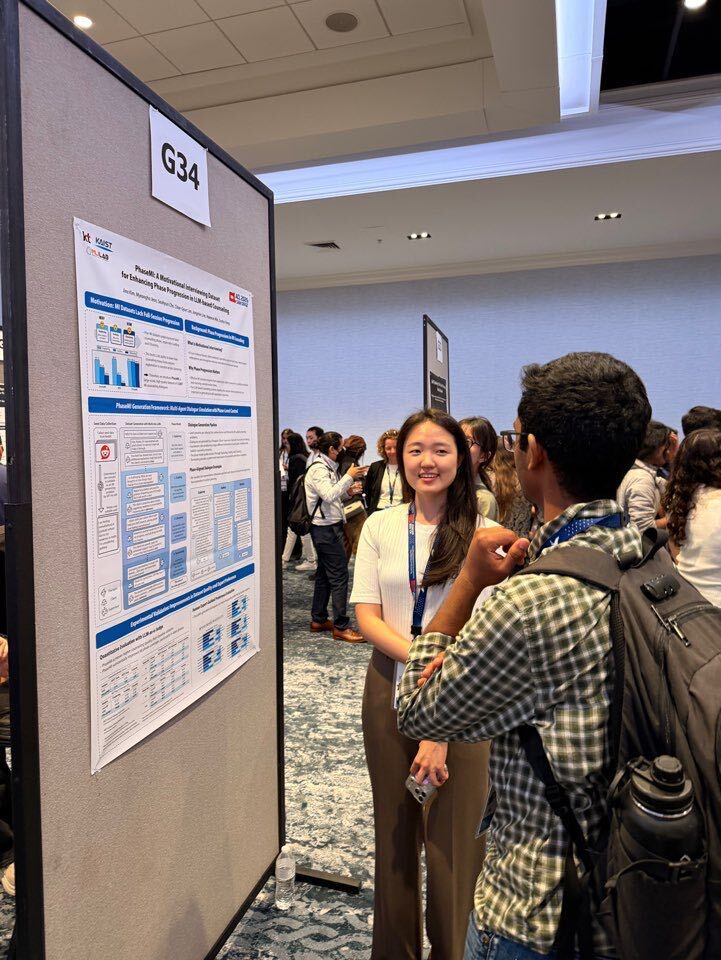
대형 언어 모델을 활용한 심리상담 연구가 활발해지면서, 상담 이론에 기반한 AI counseling system 구축의 중요성도 커지고 있습니다. 특히 Motivational Interviewing(MI)은 내담자의 ambivalence를 탐색하고 스스로 변화 동기를 형성하도록 돕는 대표적인 client-centered counseling 접근법입니다. 하지만 기존 MI 데이터셋은 개별 상담 기술이나 응답 품질에는 초점을 맞추면서도, 실제 상담이 Exploring → Guiding → Choosing으로 점진적으로 진행되는 phase progression을 충분히 반영하지 못한다는 한계가 있었습니다.
이를 해결하기 위해 본 연구에서는 PHASEMI(Phase-Structured Motivational Interviewing Dataset)를 제안하였습니다. PHASEMI는 MI의 상담 단계를 명시적으로 반영한 multi-turn counseling dataset으로, therapist, client, supervisor LLM으로 구성된 multi-role generation framework를 활용합니다. Therapist와 client가 상담을 진행하면 supervisor가 현재 phase의 목표가 충분히 달성되었는지를 판단하고, 상담을 유지하거나 다음 phase로 전환하도록 제어합니다. 이를 통해 단순히 자연스러운 대화를 생성하는 것을 넘어, MI 이론에 부합하는 상담의 전체적인 흐름을 데이터에 구조적으로 반영하였습니다.
평가 결과, 기존 MI 데이터셋은 주로 내담자의 고민을 이해하고 탐색하는 Exploring 단계에 집중되는 경향을 보인 반면, PHASEMI는 변화 동기를 형성하는 Guiding과 구체적인 행동 계획으로 연결하는 Choosing까지 보다 안정적으로 포함하였습니다. 또한 MI에 특화된 MITI와 일반적인 counseling quality를 평가하는 CTRS 기반 평가에서도 PHASEMI가 높은 상담 품질을 보였으며, PHASEMI로 fine-tuning한 모델 역시 새로운 상담 상황에서 보다 자연스럽게 후반 phase까지 진행하는 경향을 보였습니다.
본 연구의 핵심적인 의의는 AI 상담을 단순히 좋은 한 번의 응답을 생성하는 문제가 아니라, 내담자의 상태와 readiness에 따라 상담을 적절한 단계로 발전시키는 long-horizon counseling process로 바라보았다는 점입니다. PHASEMI는 LLM이 내담자의 이야기를 충분히 이해하고, 변화에 대한 동기를 이끌어낸 뒤, 실제 행동 계획으로 연결하는 상담 progression을 학습할 수 있는 structured supervision을 제공합니다. 이는 향후 phase-aware counseling model뿐 아니라 상담자의 session flow를 분석하거나 feedback을 제공하는 counselor training system 연구에도 활용될 수 있습니다.
3. 맺음말
이번 ACL 2026에서는 LLM의 성능을 단순히 높이는 것을 넘어, 실제 환경에서 보다 안전하고 효율적이며 목적에 맞게 활용하기 위한 연구가 활발하게 이루어지고 있음을 확인할 수 있었습니다. 특정 지식을 선택적으로 제한하면서 기존 지식을 보존하는 CURaTE, 불필요한 추론 과정을 진단하고 효율화하는 CAID와 PACE, 그리고 상담의 단기적인 응답 품질을 넘어 장기적인 대화 흐름과 단계적 진행을 학습하도록 설계된 PHASEMI는 서로 다른 문제를 다루고 있지만, 모두 LLM을 실제 서비스에 적용하기 위해 필요한 보다 세밀한 모델 제어와 평가의 중요성을 보여주고 있습니다.
특히 최근의 연구 흐름은 모델의 최종 성능만을 평가하는 것에서 점차 벗어나고 있습니다. 모델이 어떤 정보를 활용하고 제한해야 하는지, 어떠한 과정을 거쳐 답변을 생성하는지, 그리고 여러 차례의 상호작용 속에서 목표를 어떻게 달성하는지와 같은 과정적인 측면까지 중요한 연구 대상으로 확장되고 있습니다. 이는 향후 LLM 연구에서 정확도뿐만 아니라 지식 관리, 추론 효율성, 장기적인 상호작용 능력과 같은 요소들이 함께 고려되어야 함을 시사합니다.
ACL 2026을 통해 이러한 다양한 연구 방향을 직접 살펴보면서, LLM이 범용적인 언어 모델을 넘어 실제 문제를 안정적으로 해결할 수 있는 시스템으로 발전하기 위해서는 모델 자체의 성능뿐만 아니라 데이터 구성, 평가 방법, 추론 과정, 그리고 실제 사용 환경을 함께 고려하는 연구가 중요하다는 점을 다시 확인할 수 있었습니다. 이번 학회에서 확인한 연구 동향과 아이디어들이 앞으로 보다 신뢰할 수 있고 실용적인 AI 시스템을 연구하는 데 좋은 참고가 될 것으로 기대합니다.
발표 논문 바로가기
2-1. CURaTE: Continual Unlearning in Real Time with Ensured Preservation of LLM Knowledge [발표 논문 바로가기]
2-2. Diagnosing Latent Inefficiency in Chain-of-Thought [발표 논문 바로가기]
2-3. PhaseMI: A Motivational Interviewing Dataset for Enhancing Phase Progression in LLM-based Counseling [발표 논문 바로가기]