ECCV 2026 학회 개요
세계 최대 컴퓨터 비전 학회 중 하나인 ECCV 2026이 스웨덴 말뫼에서 열렸습니다. Frontier AI랩의 장민혁 연구원과 진석희 연구원은 이번 학회에서 각자의 연구를 발표하고 돌아왔는데요, 올해 현장은 그 어느 때보다 뜨거운 활기로 가득 차 있었습니다. 가장 크게 와닿았던 점은 비전 AI의 패러다임이 단순히 그럴듯한 2D 영상이나 그림을 만들어내는 단계를 지나, 실제 3차원 공간을 정확히 이해하고 로봇과 결합해 물리 세계를 조작하는 '월드 모델(World Model)'과 체화된 지능(Embodied AI)으로 빠르게 옮겨가고 있다는 사실이었습니다.
이번 글에서는 먼저 KT 연구진이 발표한 두 편의 연구, '단 두 장의 흔들린 사진으로 3D 공간을 복원하는 기술(CasDeblurGS)'과 '여러 텍스트 프롬프트를 결합해 시각-언어 모델의 분류 성능을 높이는 기술(Text Prompt Boosting)'을 소개합니다. 이어서 학계의 큰 주목을 받은 얀 르쿤(Yann LeCun) 교수의 키노트, 그리고 학회 현장에서 큰 인상을 남긴 Seoul World Model과 AutoSpeed 같은 최신 연구들을 통해 향후 Physical AI로의 적용 방향을 가벼운 마음으로 짚어보고, 끝으로 학회장 밖에서 만난 스웨덴 문화도 짧게 전해드리고자 합니다.
KT의 ECCV 2026 발표 이야기
저희가 발표한 두 편의 연구를 소개합니다. 장민혁 연구원이 발표한 CasDeblurGS는 워크숍 포스터 세션에서 많은 관심을 받았고, 진석희 연구원의 Text Prompt Boosting은 메인 컨퍼런스의 스포트라이트 세션에서 구두 발표로 소개되었습니다
CasDeblurGS: 두 장의 흔들린 사진으로 완성하는 3D Gaussian Splatting
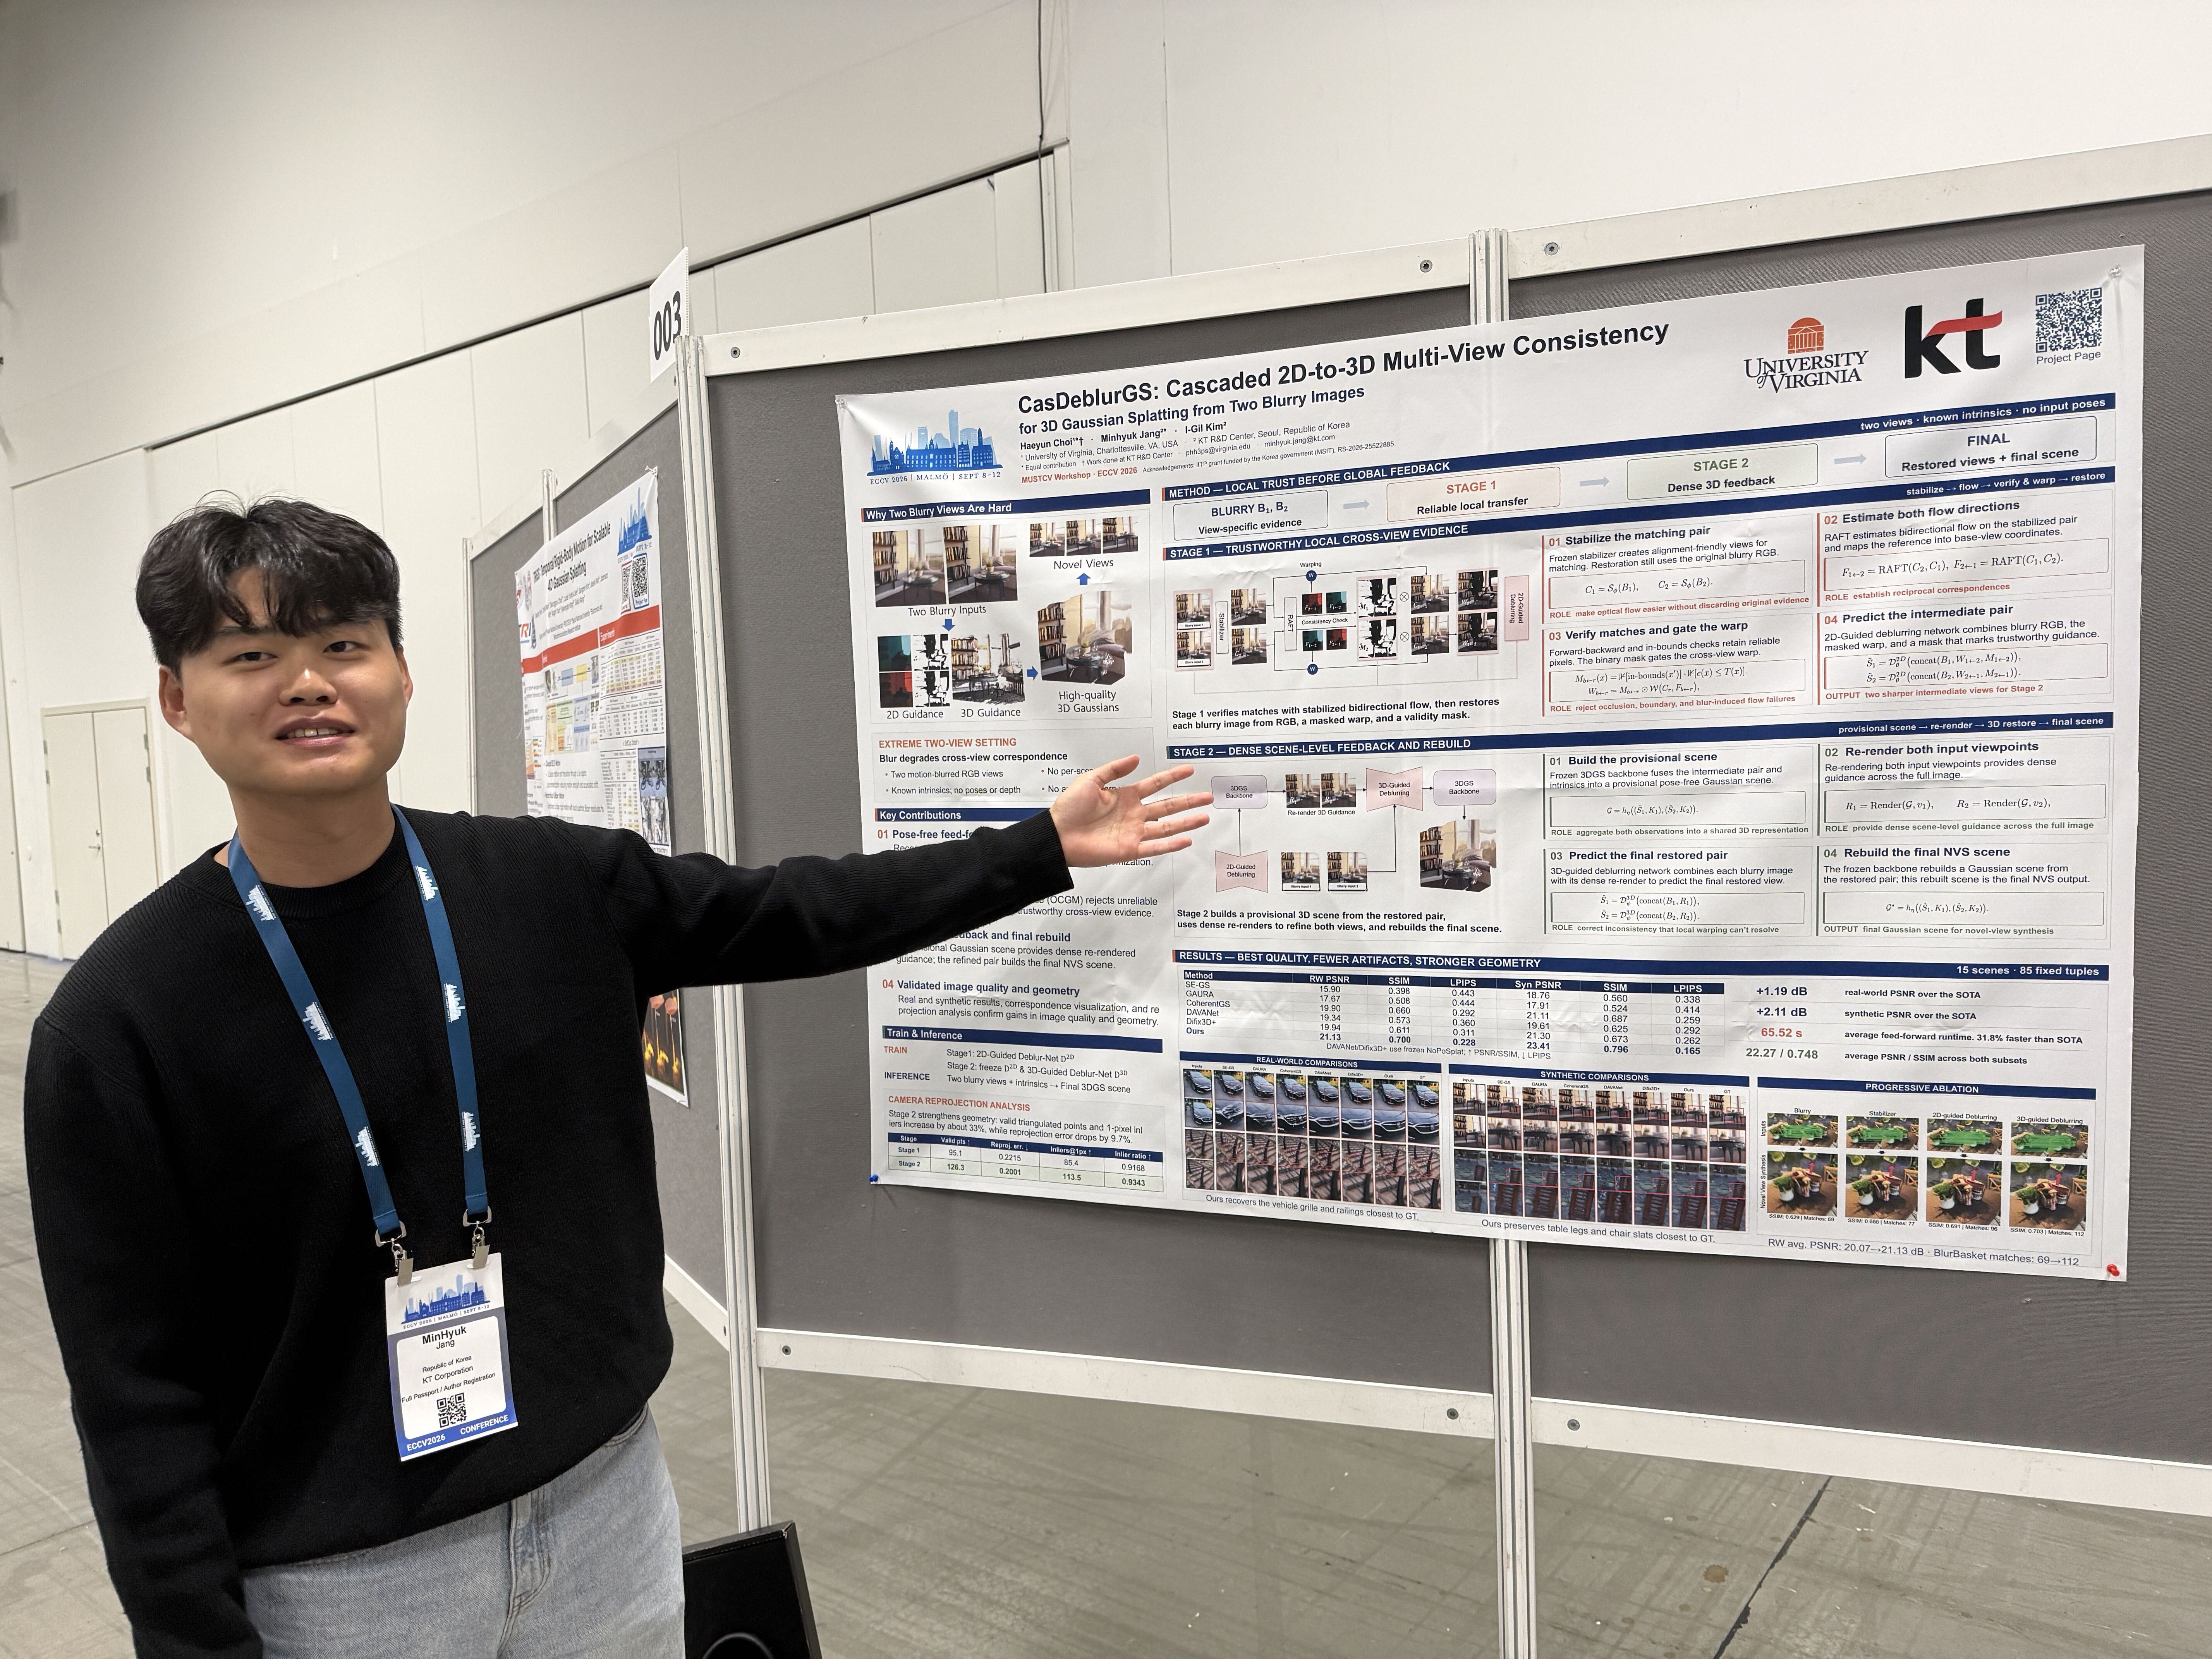
스마트폰이나 로봇 카메라로 사진을 찍다 보면 손떨림이나 빠른 이동 때문에 사진이 흔들려(Motion Blur) 망가지는 경우가 정말 흔합니다. 기존의 3D 공간 복원 기술들은 이러한 흔들림을 극복하기 위해 보통 수십 장(20~40장)의 사진을 촘촘히 찍거나, 정밀한 카메라 위치 정보, 그리고 장면당 수십 분씩 걸리는 최적화 시간을 요구했습니다. 하지만 실제 일상이나 로봇 작업 현장에서 이런 까다로운 조건을 맞추기는 거의 불가능에 가깝습니다.
그래서 장민혁 연구원은 "카메라 위치도 모르고, 깨끗한 원본도 없이, 단 두 장의 심하게 흔들린 사진만으로 즉시(Feed-forward) 3차원 공간을 깔끔하게 복원할 수 없을까?"라는 아주 가혹하지만 실용적인 질문을 던졌습니다. 이를 위해 2D와 3D 정보를 단계적으로 살려내는 2단계 캐스케이드(Cascade) 방식을 고안했습니다.
첫 번째 단계에서는 양쪽 사진 사이의 움직임 흐름(Optical Flow)을 비교해, 흔들림이나 가려짐 때문에 엉뚱하게 매칭된 부분을 똑똑하게 걸러내는 OCGM 모듈을 적용했습니다. 확실한 영역만 살짝 옮겨 붙여서 1차적으로 선명한 사진을 복원합니다. 두 번째 단계에서는 이렇게 복원된 사진들을 3D 가우시안 공간으로 올린 뒤, 원래 카메라 시점으로 다시 비춰봅니다(Re-render). 그러면 씬 전체의 입체적인 뼈대가 조밀한 글로벌 가이드로 다시 전달되어 훨씬 안정적인 최종 3D 복원이 완성됩니다.
결과적으로 Deblur-NeRF 표준 벤치마크에서 기존 최고 모델들 대비 실제 씬에서 PSNR 1.19 dB, 합성 씬에서 2.11 dB 향상이라는 유의미한 화질 개선을 달성했습니다. 포스터 세션 당시 "정말 테스트 타임 최적화 없이 바로 3D가 나오느냐"며 많은 글로벌 연구진들이 찾아와 관심을 보여주어 큰 보람을 느꼈습니다.
Text Prompt Boosting: 텍스트 프롬프트를 결합하여 시각-언어 모델의 이미지 분류 성능 높이기
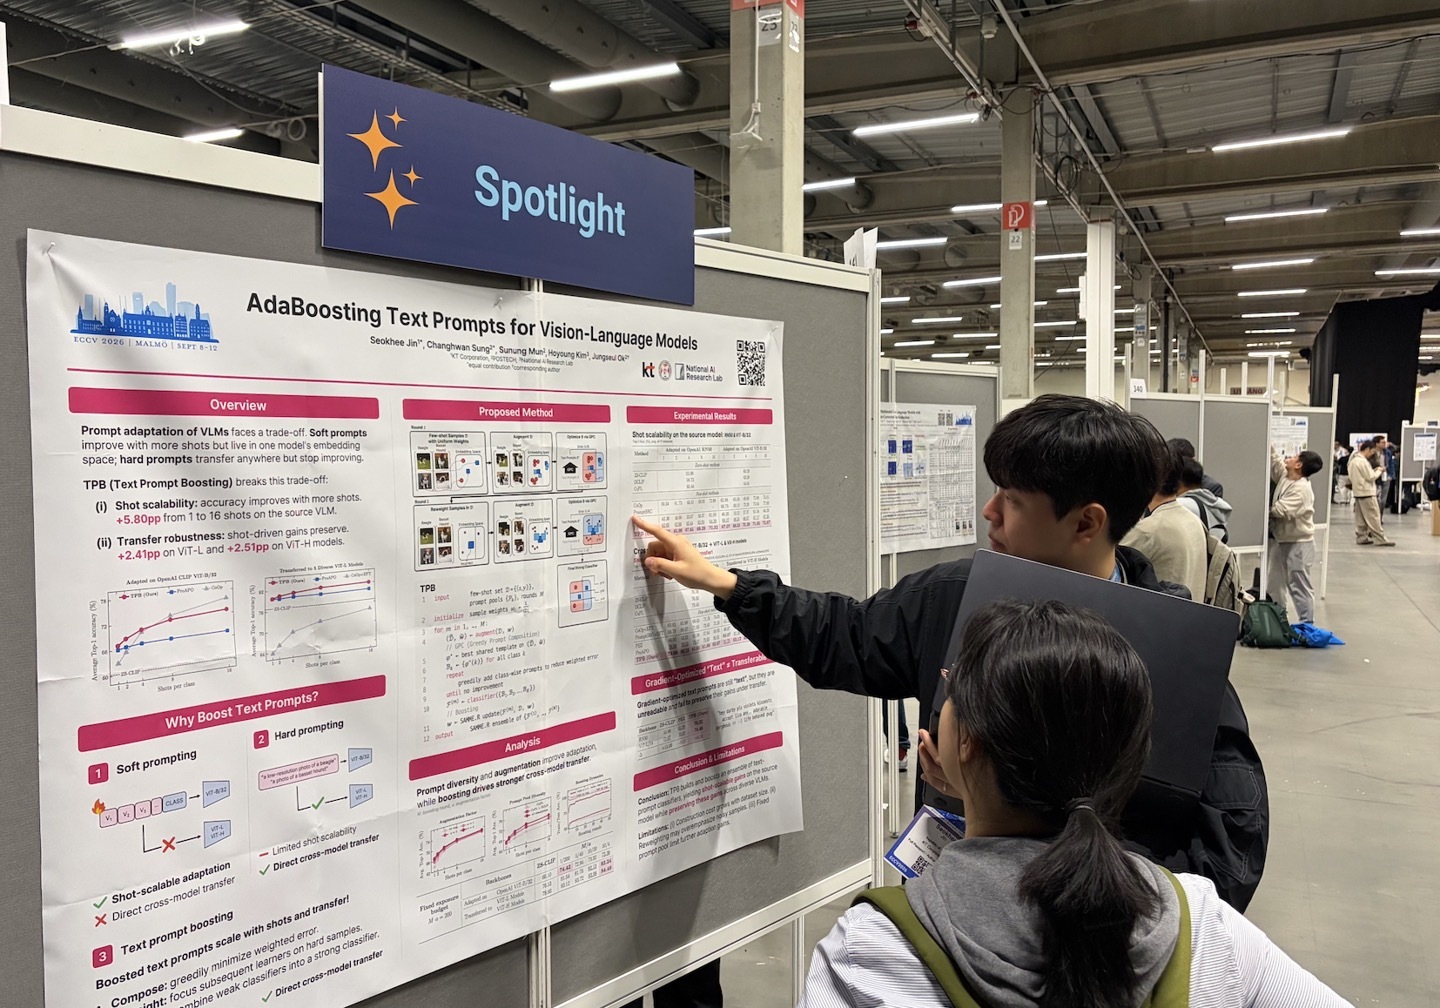
CLIP 같은 시각-언어 모델(VLM)은 "a photo of a dog" 같은 문장만으로 이미지를 분류할 수 있습니다. 이미지와 각 클래스를 설명하는 문장을 비교해서 가장 잘 맞는 문장을 정답으로 고르는 방식입니다. 그래서 어떤 문장(프롬프트)을 쓰느냐에 따라 분류 성능이 크게 달라집니다. 프롬프트를 학습 가능한 벡터로 다루는 방식은 학습 데이터가 늘수록 꾸준히 좋아지지만, 학습된 프롬프트는 특정 모델의 임베딩 공간에서만 의미를 갖는 벡터라서 다른 모델에서는 재사용할 수 없습니다. 반대로 실제 자연어로 이뤄진 텍스트 프롬프트는 한 번 찾아 두면 어떤 모델에서든 그대로 재사용할 수 있지만, 학습 데이터를 이용해 성능 좋은 자연어 문장을 찾는 것은 어려운 문제였습니다.
진석희 연구원은 이번 연구에서 "문장 하나로는 부족하다면, 서로의 약점을 보완하는 여러 문장을 결합하면 어떨까?"라는 질문을 던졌습니다. 이를 위해 약한 분류기 여러 개를 이어 붙여 강한 분류기를 만드는 고전 머신러닝 기법인 에이다부스트(AdaBoost)를 텍스트 프롬프트에 적용했습니다. 먼저 모든 이미지에 같은 가중치를 두고, 전체 오분류를 가장 줄이는 문장들을 골라 첫 번째 프롬프트 묶음을 만듭니다. 그다음 이 묶음이 여전히 틀리는 이미지에 가중치를 높여서, 다음 묶음은 그 어려운 이미지를 해결하는 문장을 고르게 합니다. 이 과정을 여러 번 반복한 뒤 모든 묶음을 결합하면, 하나의 묶음만으로는 놓치던 이미지까지 잘 분류하는 강한 분류기가 완성됩니다. 결합된 결과도 여전히 사람이 읽을 수 있는 문장이라서, 다른 모델에서도 추가 학습 없이 그대로 재사용할 수 있습니다.
11개 이미지 분류 벤치마크 평균으로 보면, CLIP ViT-B/32 모델에서 학습 이미지가 클래스당 1장뿐일 때 Text Prompt Boosting은 기존 최고 텍스트 프롬프트 기법보다 정확도가 1.0%p 높았고, 16장일 때는 그 격차가 5.5%p로 크게 벌어졌습니다. 학습 데이터가 늘어날수록 이를 더 잘 활용한다는 뜻입니다. 이렇게 ViT-B/32에서 찾은 프롬프트를 더 큰 ViT-L 모델 5종과 ViT-H 모델 4종에 그대로 적용했을 때도 같은 경향이 나타났습니다. 1장으로 학습한 프롬프트는 두 기법의 성능이 비슷했지만, 16장으로 학습한 프롬프트는 기존 기법보다 각각 2.1%p, 1.9%p 높은 정확도를 보였습니다.
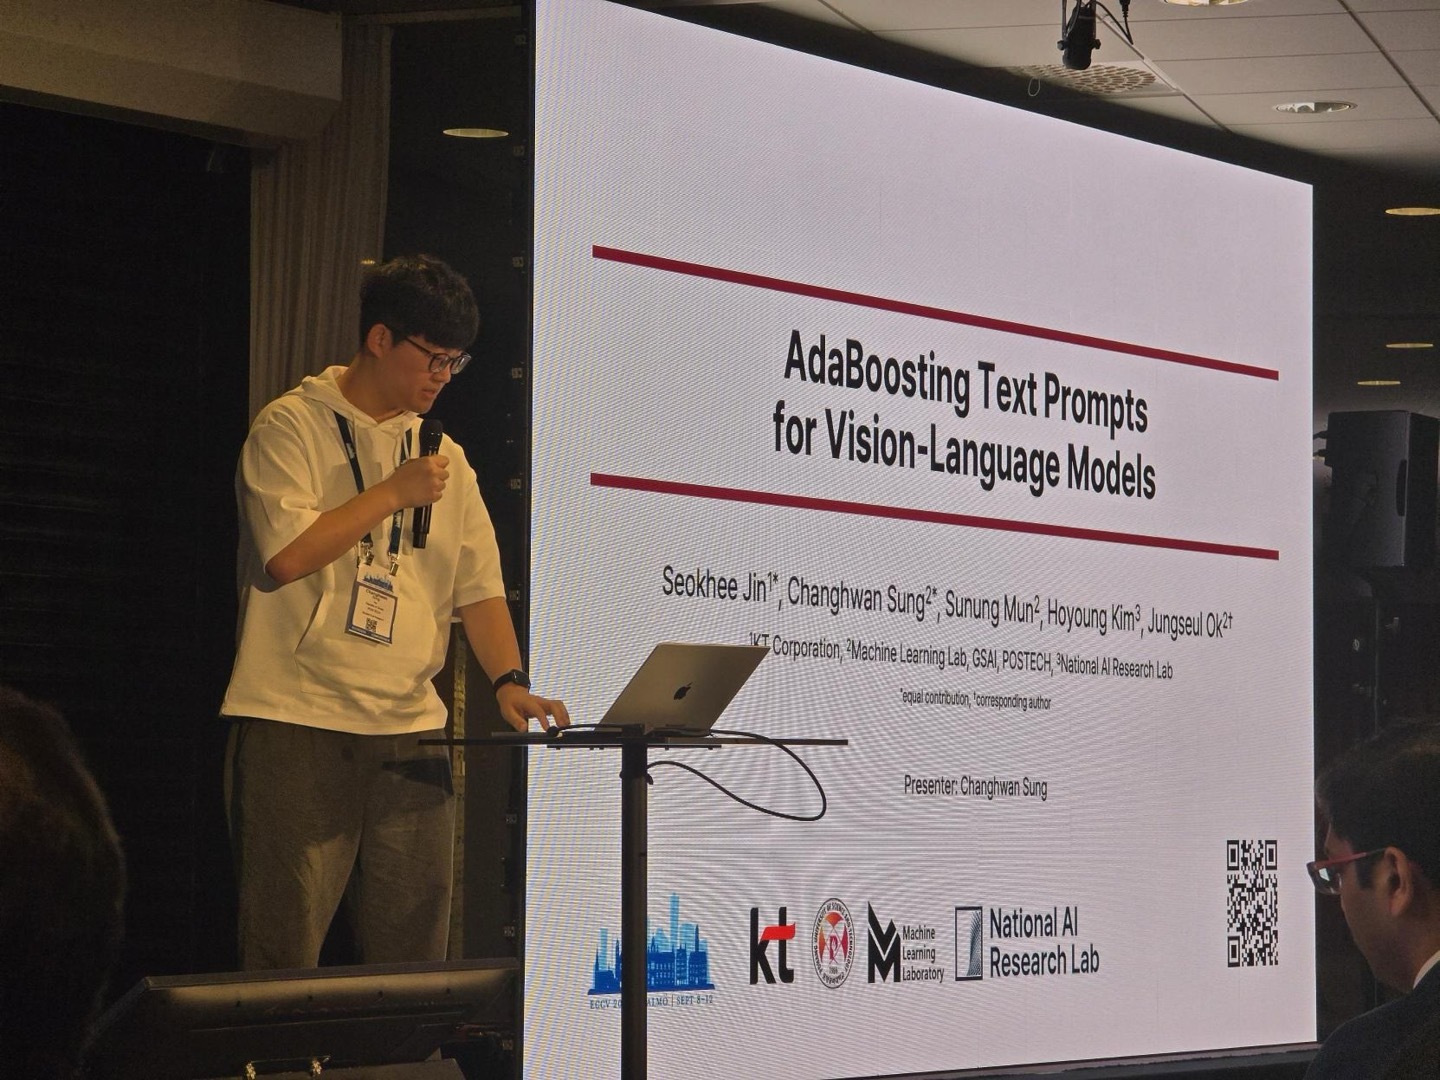
이 연구는 채택 논문 가운데 일부만 선정되는 스포트라이트 발표로 소개되었습니다. 특정 VLM에 종속되지 않고 다양한 모델로 확장할 수 있다는 점에서, 보다 유연한 프롬프트 활용 가능성을 보여준 연구였습니다.
Yann LeCun Keynote: 월드 모델이 바꿀 AI의 미래
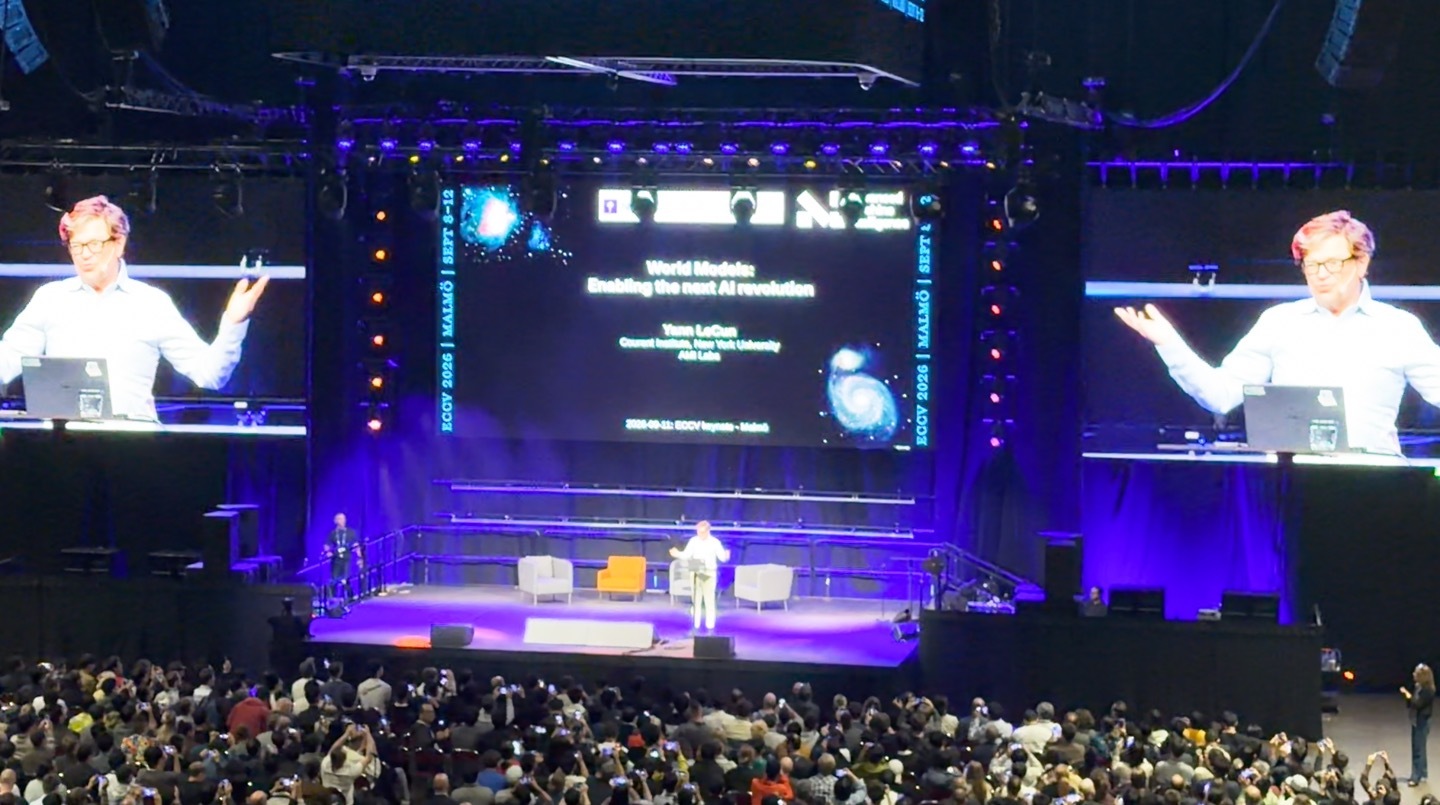
이번 ECCV 2026에서 특히 큰 주목을 받은 세션은 얀 르쿤(Yann LeCun) 교수의 키노트였습니다. 강연장인 말뫼 아레나의 객석 대부분을 채울 만큼 많은 참가자가 모여, 월드 모델과 차세대 AI의 방향에 대한 높은 관심을 실감할 수 있었습니다. 르쿤 교수는 코드와 수학 문제를 풀어내는 AI가 왜 식탁 정리 같은 일상적인 행동에는 여전히 어려움을 겪는지 질문하며 강연을 시작했습니다. 그가 강조한 지능의 기준은 이미 배운 문제를 얼마나 잘 푸느냐보다, 새로운 상황에서 얼마나 빠르게 배우고 적응하느냐였습니다. 사람과 동물처럼 낯선 과제를 해결하려면, 행동하기 전에 그 결과를 예상할 수 있는 월드 모델이 필요하다는 설명입니다.
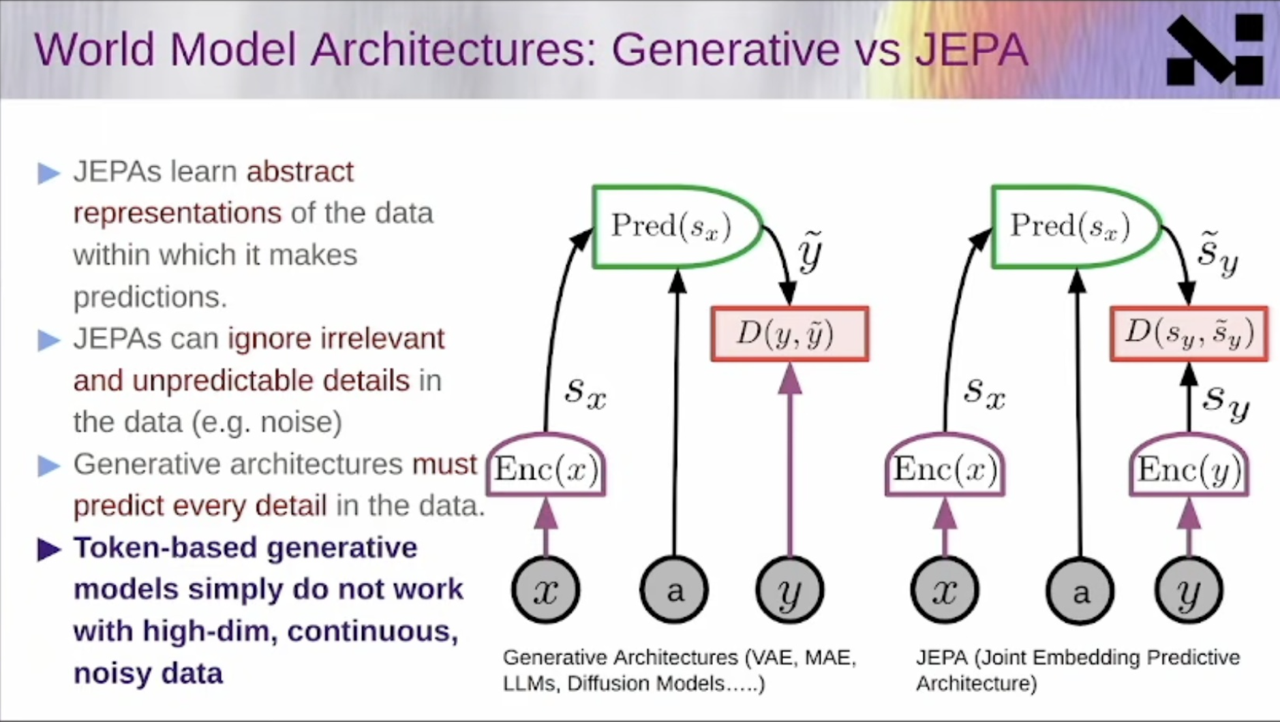
이를 위한 핵심 접근으로 JEPA(Joint Embedding Predictive Architecture)를 소개했습니다. 영상의 모든 픽셀을 예측하는 대신, 관측을 추상적인 표현으로 바꾸고 그 표현의 변화를 예측하는 방식입니다. 르쿤 교수는 자율주행 영상을 예로 들었습니다. 미래의 모든 픽셀을 맞히려면 바람에 흔들리는 나뭇잎이나 물결, 차 뒤에서 나타나는 보행자의 옷차림까지 예측해야 합니다. 주행 판단에 필요하지 않은 세부 사항까지 학습의 부담이 되는 셈입니다. JEPA는 이런 세부 사항을 덜어내고, 판단과 예측에 유용한 추상적 표현을 학습하자는 접근입니다.
이렇게 학습한 월드 모델을 행동 계획에 연결하는 것이 그가 제시한 방향입니다. 여러 행동의 결과를 내부적으로 예측하고, 목표에 가장 잘 맞는 행동을 선택한 뒤 실제 관측에 따라 계획을 수정하는 구조입니다. 다만 긴 시간에 걸친 복잡한 과제를 여러 단계로 나누는 계층적 계획은 아직 남은 연구 과제라고 설명했습니다. 르쿤 교수가 그린 AI의 미래는 세계의 변화를 예측하고, 그 안에서 목표에 맞춰 행동할 수 있는 지능이었습니다.
현장에서 포착한 핵심 기술 트렌드: 월드 모델과 로봇 제어
키노트 외에도 학회 곳곳에서 월드 모델과 로봇 제어를 다룬 연구들이 눈에 띄었습니다. 그중 특히 인상 깊었던 두 연구를 소개합니다.
Seoul World Model: 서울 도심을 누비는 대규모 비디오 월드 모델
도시 전체를 자유롭게 돌아다니는 주행 영상을 AI로 만들려고 하면, 조금만 멀리 가도 건물이 녹아내리거나 길이 사라지는 공간 왜곡(Drift) 문제가 생기기 마련입니다. 네이버랩스 연구진이 발표한 Seoul World Model은 서울 주요 지역의 파노라마 약 44만 장을 영리하게 엮어 이 문제를 풀어냈습니다.
핵심은 서로 다른 시간대의 사진을 매칭하는 데(Cross-temporal Pairing) 있습니다. 일반적인 거리뷰를 그대로 학습시키면, 차나 보행자가 항상 같은 자리에 머물러 모델이 '영속적인 건물 배경'과 '잠깐 지나가는 차'를 구별하지 못합니다. 이 연구는 같은 장소라도 일부러 다른 날짜와 시간에 찍힌 파노라마를 짝지어 학습시켰습니다. 덕분에 계절이나 시간에 상관없이 항상 존재하는 건물과 도로는 고정된 뼈대로 인식하고, 움직이는 차량은 알아서 자연스럽게 생성하도록 유도했습니다. 여기에 더해 긴 거리를 이동할 때 경로가 엉뚱한 곳으로 새지 않도록, 이동할 경로 전방의 실제 거리뷰 사진을 미리 3차원으로 살짝 투영해 길잡이 앵커로 주입하는 Virtual Lookahead Sink 기법을 적용해 현실 지도 데이터와 생성 AI를 깔끔하게 접목했습니다.
AutoSpeed: 작업 난이도에 맞춰 스스로 속도를 조절하는 로봇 조작
로봇 팔을 제어하는 인공지능(Action-chunk Policy)의 오랜 골칫거리 중 하나는, 모든 동작을 처음부터 끝까지 똑같은 속도와 일정한 보폭으로만 수행한다는 점이었습니다. 실제 사람은 목표 지점까지 손을 뻗을 땐 휙 빠르게 가고, 컵 손잡이를 잡거나 부품을 맞추는 순간에는 속도를 확 줄여 조심스럽게 움직이는데 말이죠.
AutoSpeed는 사람이 일일이 "여기는 빠르게, 여기는 느리게"라고 구간 라벨을 붙이지 않아도 로봇 스스로 작업의 난이도를 감지해 동작 속도를 조절하도록 설계되었습니다. 원래 동작 데이터를 주파수 변환(DCT)을 통해 다양한 속도 비율의 부드러운 후보들로 펼쳐놓은 뒤, 모델이 각 후보를 얼마나 잘 예측하는지 평가합니다. 장애물이 없는 허공처럼 예측이 쉬운 구간에서는 빠른 속도 후보가 자연스럽게 채택되어 긴 미래까지 성큼성큼 이동하고, 정밀 정렬이나 부품 삽입처럼 불확실성이 큰 구간에서는 조심스러운 느린 속도가 선택됩니다. 결과적으로 출력하는 제어 데이터 개수는 그대로 유지하면서 전체 작업 시간은 획기적으로 줄이고 정밀도는 챙기는 매우 실용적인 아이디어를 보여주었습니다.
스웨덴 문화 노트: 미트볼과 자연향유권
마지막으로, 학회장 밖에서 만난 스웨덴의 모습을 짧게 소개합니다.
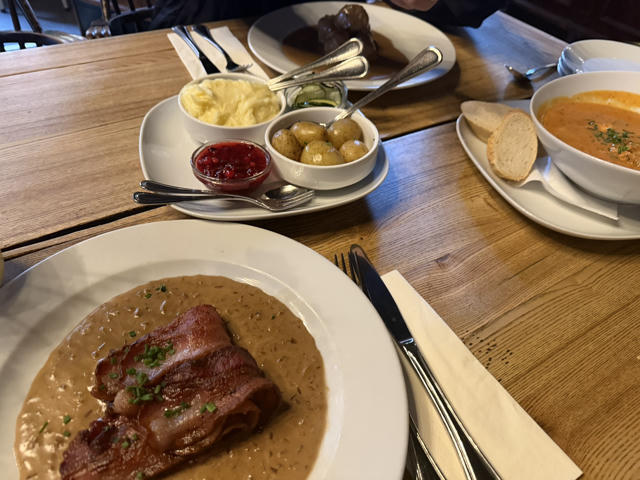
스웨덴에 왔으니 대표 음식인 미트볼은 꼭 맛봐야 했습니다. 크리미한 소스를 듬뿍 두른 미트볼에 으깬 감자와 새콤달콤한 링곤베리 잼을 곁들여 먹는 것이 정석인데요. 고기에 잼이라니 처음엔 조금 낯설었지만, 한 입 먹어보니 짭짤하고 고소한 미트볼에 베리의 산뜻함이 더해져 생각보다 훨씬 잘 어울렸습니다. 학회 일정으로 지친 몸을 든든하게 채워준, 맛있는 한 끼였습니다.
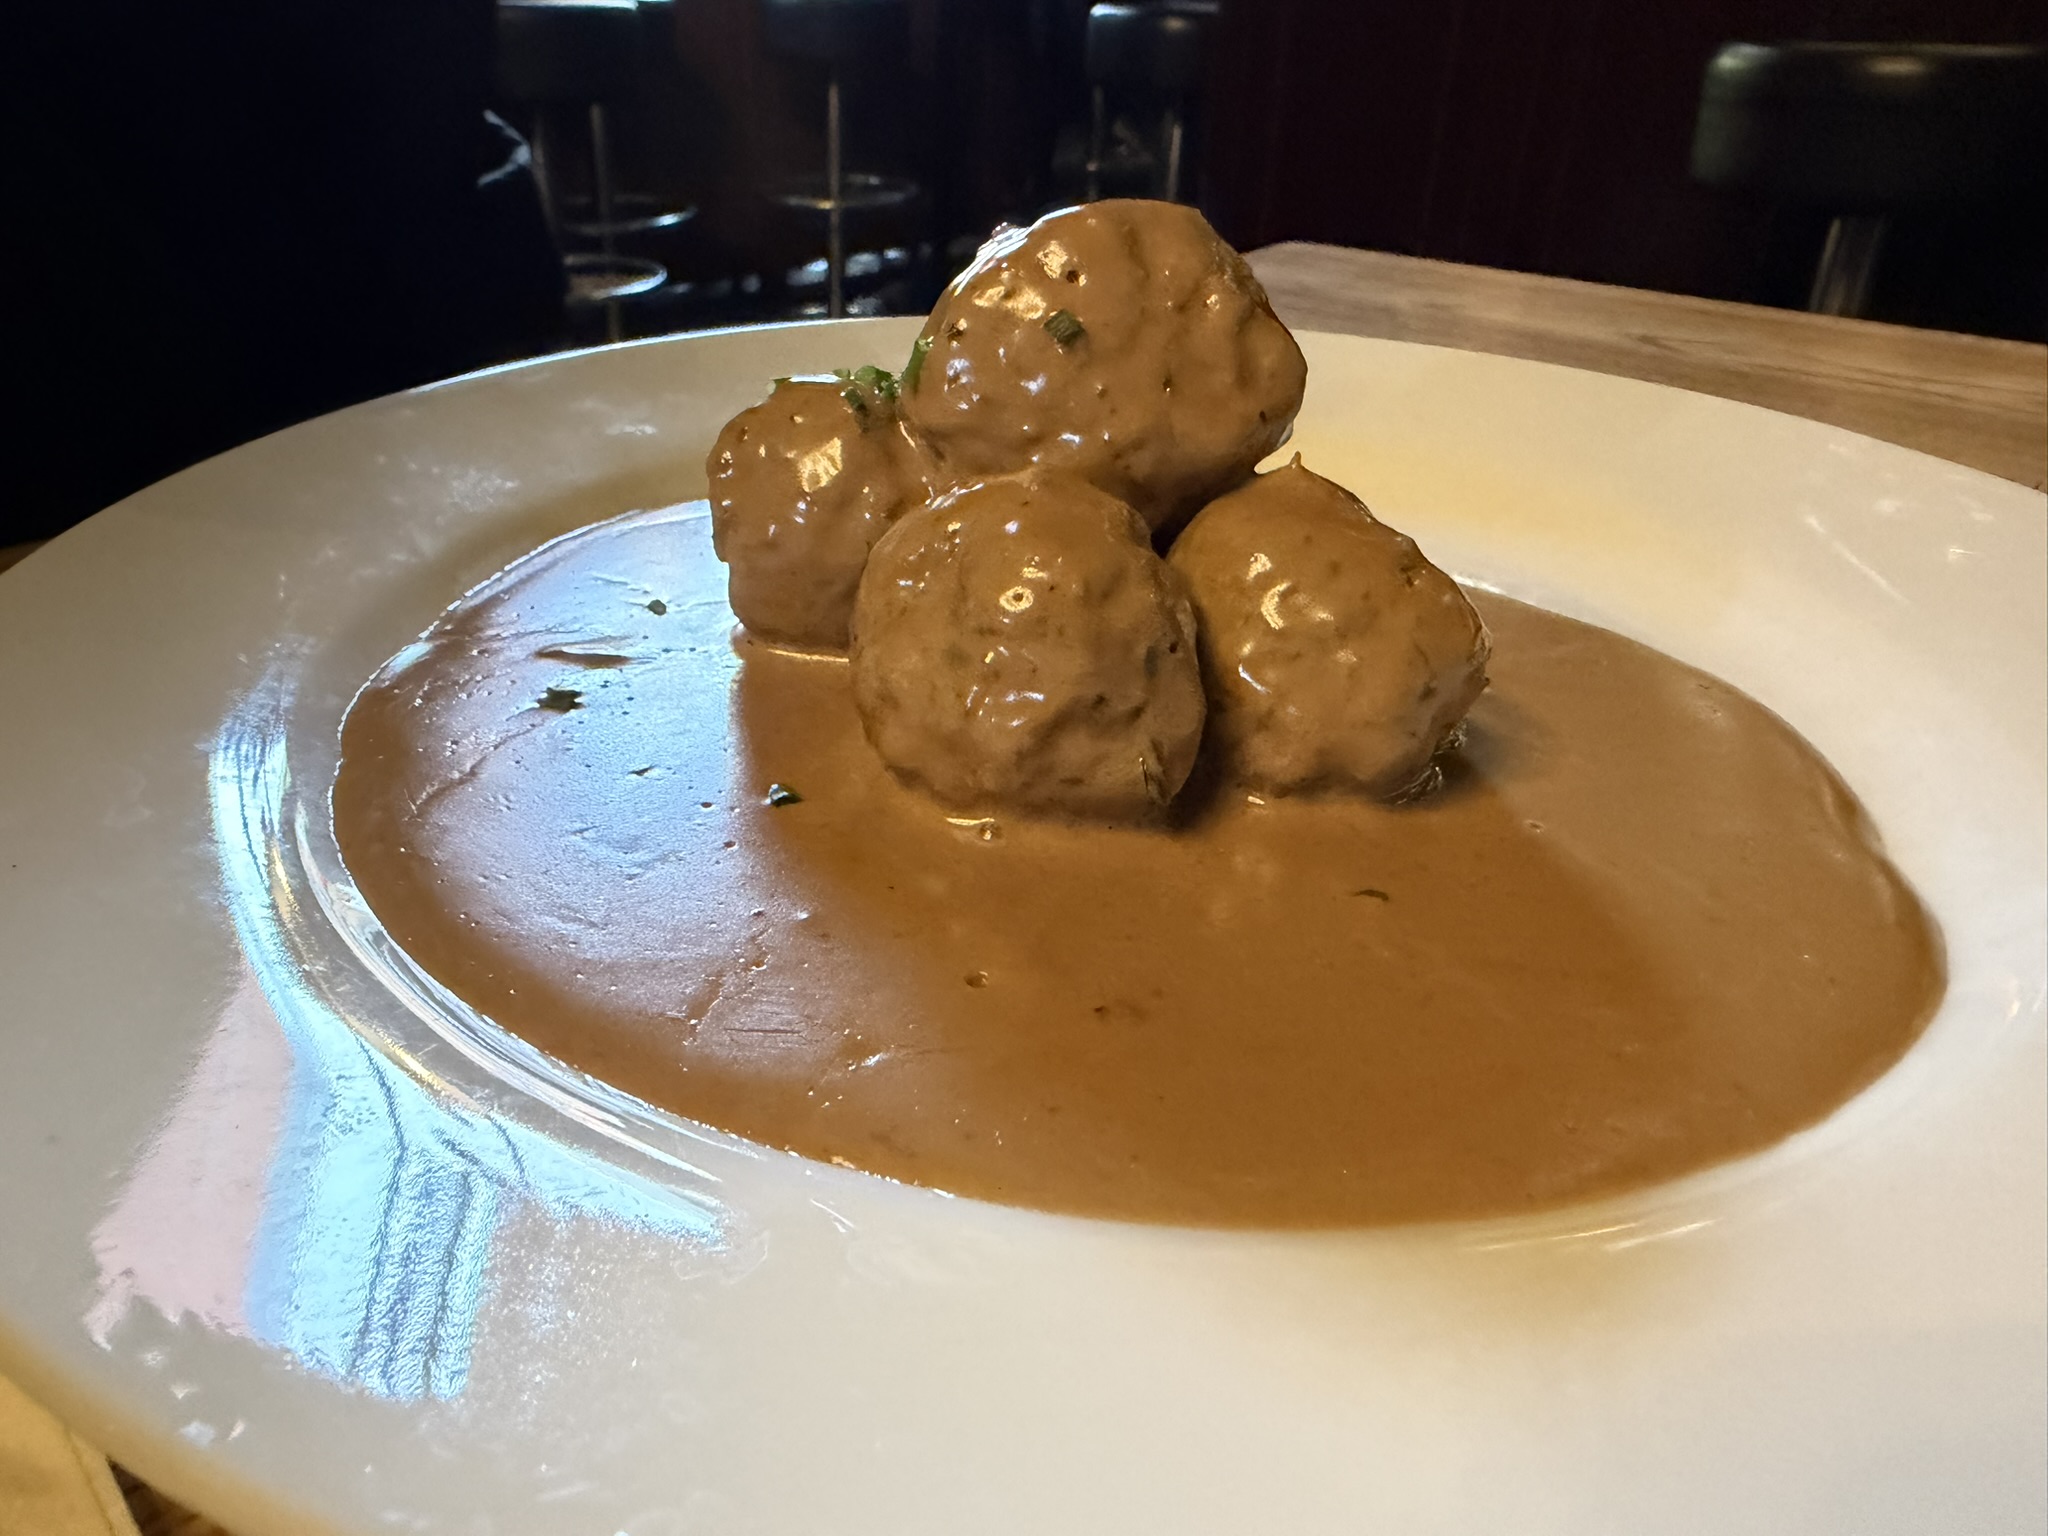
스웨덴 대표 음식 미트볼 |
|
학회 일정 사이에는 근처 공원이나 숲을 자주 거닐었습니다. 산책을 하거나 잔디밭에 앉아 쉬는 사람들 사이를 걷다 보면, 발표와 토론에서 벗어나 자연스럽게 숨을 고를 수 있었는데요. 스웨덴에는 사유지라도 누구나 자연을 자유롭게 누릴 수 있도록 헌법에 명시된 '자연향유권(Allemansrätten)'이 있다고 합니다. 그래서인지 숲과 공원이 특별한 장소라기보다 일상의 쉼터처럼 느껴졌고, 그 여유로움을 한껏 만끽할 수 있었던 시간이었습니다.
마치며: 구체화되는 Physical AI의 기술 흐름
ECCV 2026에서 확인한 여러 연구는 결국 하나의 방향을 가리키고 있었습니다. AI가 현실 세계를 이해하고 행동하기 위해서는 공간에 대한 이해, 미래에 대한 예측, 그리고 이를 실제 행동으로 연결하는 능력이 함께 필요합니다. 월드 모델과 3D 공간 지능, 로봇 제어 기술이 빠르게 발전하고 서로 맞물리면서, Physical AI는 점차 구체적인 연구 과제와 기술 형태로 모습을 드러내고 있습니다.
KT는 앞으로도 공간 이해, 예측, 행동을 연결하는 핵심 기술을 바탕으로 Physical AI의 가능성을 넓히고, 이를 실제 환경에서 활용할 수 있는 기술로 발전시켜 나갈 계획입니다.
References
CasDeblurGS: Haeyun Choi*, Minhyuk Jang*, and I-Gil Kim, "CasDeblurGS: Cascaded 2D-to-3D Multi-View Consistency for 3D Gaussian Splatting from Two Blurry Images", ECCVW 2026. (arXiv:2608.10345) (*equal contribution)
Text Prompt Boosting: Seokhee Jin*, Changhwan Sung*, Sunung Mun, Hoyoung Kim, and Jungseul Ok, "AdaBoosting Text Prompts for Vision-Language Models", ECCV 2026. (arXiv:2607.00684) (*equal contribution)
Seoul World Model: "City retrieval, data construction, autoregressive grounding for urban world modeling", ECCV 2026.
AutoSpeed: "AutoSpeed: Annotation-Free Stage-Adaptive Motion Speed Learning for Robot Manipulation", ECCV 2026.
ECCV 2026 Official Proceedings & Program Guide