
1. 들어가며: 단일 로봇을 넘어 수십, 수백 대의 로봇 플릿으로
2. 워크숍: 로봇 통신 엔진(RMW) 선택과 튜닝
Clearpath Robotics와 Rockwell Automation 에서 "Mastering the Jazzy RMW" 워크숍이 진행되었습니다. RMW(ROS Middleware)는 로봇 프로그램끼리 데이터를 배달하는 통신 엔진이고, Fast DDS, Cyclone DDS, Zenoh가 그 후보 세 가지입니다. 노트북 한 대 안의 가상 로봇 무리(도커)에서 이 엔진들을 설정하고, 재고, 일부러 부하를 준 뒤 점수표로 결정하는 실습이었습니다.
2.1 배경과 해결 과제
핵심 문제 의식
주요 요지
RMW별 통신 아키텍처 특성 비교
| 구분 | Fast DDS (Jazzy 기본값) |
Cyclone DDS |
Zenoh (Jazzy Tier 1) |
|---|---|---|---|
| 기본 프로토콜 |
RTPS / UDP |
RTPS / UDP |
Zenoh Protocol / 기본 TCP |
| 조각화 (Fragmentation) |
OS 커널 IP 계층 위임 (DATA_FRAG 0건) |
DDS 계층 직접 분할 관리 (DATA_FRAG 발생) |
TCP 스트림 세그먼트 분할 |
| 디스커버리 방식 |
SPDP/SEDP 분산 P2P (기본 멀티캐스트) |
SPDP/SEDP 분산 P2P (기본 멀티캐스트) |
라우터(Router) 기반 Gossip |
| 핵심 강점 |
완벽한 ROS 생태계 통합, 광범위한 튜닝 옵션 |
손실 링크 내 대용량 복원력 우수, 낮은 CPU 사용 |
서브넷/NAT 통과 용이, 멀티캐스트 폭풍 차단 |
| 주요 한계 |
대용량 샘플 손실 시 프레임 드롭 심화 |
다중 NIC/인터페이스 라우팅 구성 난이도 높음 |
무선 손실 시 TCP 재전송으로 인한 전체 지연 적체 |
2.2 핵심 방법
[Lab 1] 디스커버리 멀티캐스트 폭풍과 토폴로지 격리
- 실험 : Broadcasting 으로 찾기 → ROS DOMAIN ID로 분리 → Broadcasting을 끄고 고정 → star에서 엔진별 설정하여 실험하였습니다.
- 문제점: 노드가 늘어날수록 탐색 트래픽이 폭증하여 무선 AP 대역폭을 소진함. ROS_DOMAIN_ID는 논리적 분리일 뿐 물리적 멀티캐스트 트래픽을 차단하지 못합니다.
- 해결책
- Cyclone DDS: <AllowMulticast>false</AllowMulticast> 적용 및 <Peers>에 관제 서버 IP를 직접 명시하는 허브 앤 스포크(Hub-and-Spoke) 구조를 구축 합니다.
- Zenoh: 로봇별 로컬 라우터와 중앙 라우터를 연결해 멀티캐스트를 차단하고 가십(Gossip) 기반으로 탐색 트래픽을 격리 합니다.
[Lab 2] 와이어(Wire) 레벨 패킷 분석과 분석 도구의 착시
- 실험 : 카메라 영상(JPEG 약 41KB, 초당 10장)과 레이저 센서(약 0.8KB)를 5단계로 악화시키며 통신을 녹화해 분석하는 실험을 하였습니다.
- 문제점 : 손실 환경에서 41KB 압축 이미지 전송 시 DDS 조각화(Fragmentation) 로직에 차이가 존재합니다.
- Fast DDS: 커널 단편화 조각 1개만 유실되어도 OS의 IP 계층에서 쪼개 달라고 맡겨셔, 프레임 전체 폐기 3~4 Hz로 성능 급락 합니다.
- Cyclone DDS: 미들웨어 자체 조각 관리로 ~8.1 Hz 유지 합니다.
- Zenoh : ros2 topic info -v 상에는 BEST_EFFORT로 나타나고 손실 환경에서도 TCP 엔진이 자체 재전송을 수행하여 앱 수신율 자체는 9.2 Hz로 높게 유지되지만 이는 착시 현상 입니다. - 해결법 : 와이어샤크(Webshark) 패킷 레벨 덤프를 열어봐야만 원인 확인 가능 합니다.
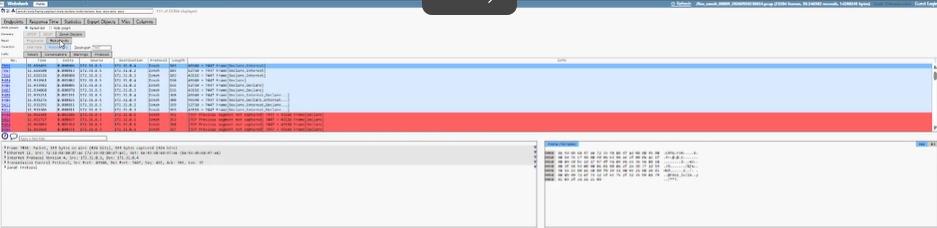 패킷 분석기(Webshark)에는 수천 건의 TCP retransmission 및 out_of_order 에러가 기록되고 분석기 엔진 싱크가 깨져 '0 프레임 복구'로 오표기됨 -> 패킷 도구 수치만으로 애플리케이션 상태를 오판하지 말아야 합니다.
초당 프레임이 높으면 건강해 보이지만, 재전송이 쌓이면 늦게 도착하는 프레임이 늘어 센서끼리 시간이 어긋납니다.
[Lab 3] 공유 무선 AP 스트레스와 QoS의 구조적 한계
- 실험 : 공유기 한 대에 속도 100→20Mbit/s, 지연 5→80ms, 손실 0.1→15%를 걸고 원인 추적하는 실험이였습니다.
- 병목 진단을 위한 3단계 파이프라인는 아래와 같습니다.
1. Lichtblick 관제 UI: state_freshness 지연 감지
2. Netdata AP 큐: ifb0의 패킷 드롭 및 백로그 적체 확인 (네트워크 문제 여부).
3. Netdata Apps CPU: 호스트 및 프로세스별 CPU 사용률 대조 (연산 자원 부족 여부).
- 문제점 : TCP의 Head-of-Line Blocking 한계가 있습니다.
- UDP(DDS): QoS를 BEST_EFFORT로 전환 시 손실 복구를 중단하여 지연 시간(Age)이 1/6로 단축됩니다.
-> UDP는 손실에도 최신 샘플이 제때 도착합니다
- TCP(Zenoh): ROS QoS를 BEST_EFFORT로 설정해도 하위 TCP 바이트 스트림 엔진이 무조건 재전송을 수행하므로 지연 시간(수천 ms) 단축 불가. 하나의 연결에 묶인 모든 토픽(카메라, 라이다, 제어)이 대기열에 함께 멈춰 서는 현상 발생합니다.
-> 응용 계층 QoS를 바꿔도 되돌릴 수 없는 이유입니다. - 해결법 : 재전송은 지연으로 지불합니다. 이 방식에서는 영상 속도를 네트워크에서 낮추거나(Zenoh downsampling), 전송을 분리하는 설계를 따로 고민할 필요가 있습니다.
[Lab 4] 벤치마킹 및 퓨 매트릭스(Pugh Matrix) 의사결정
- 결론: 모든 환경에 완벽한 단일 RMW는 존재하지 않음.
- 지연 시간(Latency) 및 무선 손실 회복력 최우선 시스템: Cyclone DDS 우세
- 대규모 플릿 확장, 서브넷 라우팅, 방화벽/NAT 통과 최우선 시스템: Zenoh 우세.
- 가중치(1~5)와 벤치마크 데이터를 매핑하여 객관적으로 시스템에 맞는 RMW를 선정해야 함.
2.3. 결과와 의의
| 엔진 |
현상 | 한계 | 적합한 환경 |
|---|---|---|---|
| Fast DDS | 영상이 3단계(약 48초 시점)부터 초당 0장으로 갑자기 끊김. 작은 센서 데이터는 초당 10회로 유지. 큰 메시지를 쪼개는 일을 운영체제에 맡겨서, 조각 하나만 잃어도 영상 한 장이 통째로 사라짐 |
큰 데이터가 무선 손실에 약함. |
작은 제어와 상태 메시지 중심이거나 손실이 낮은 구간 |
| Cyclone DDS | 네트워크가 나빠질수록 영상이 서서히 줄어듦(5단계에서 초당 1~2장). 센서는 안정. |
네트워크 카드가 여러 개인 구성에 약함 |
네트워크 카드가 하나인 구성, 전체 방송이 되는 flat 구성 |
| Zenoh | 영상이 4단계까지 초당 약 10장으로 유지됨. 반면 센서는 5단계에서 초당 약 3.5~5회로 급락하고 도착 간격이 150~250ms씩 들쭉날쭉해짐 |
"잃어도 괜찮다(BEST_EFFORT)"를 지정해도 아래의 TCP가 다시 보내서 작은 데이터까지 늦어짐. |
큰 데이터가 중요하고 방송이 안 되는 다중 서브넷, 대역폭 제어가 필요한 환경 |
3. 주요 연구 동향
3.1. 데이터를 옮기는 비용 줄이기 (NVIDIA, AMD, Intel)
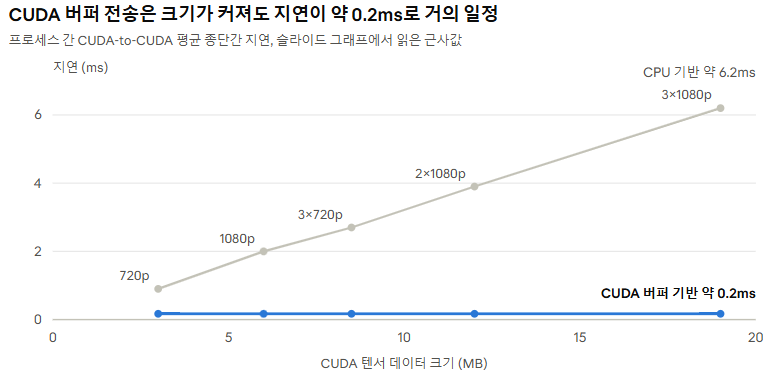
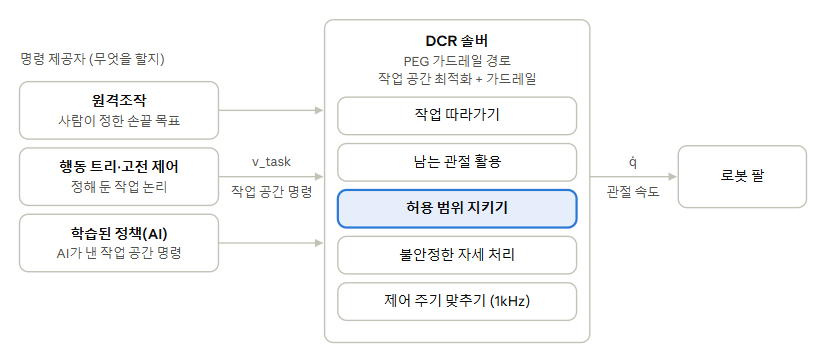
3.2. 데이터를 정리하는 비용 줄이기 (Roboto, Rosetta, Rerun)
로봇이 녹화한 원본과 AI가 학습에 쓰는 데이터는 모양이 달라서, 그 사이를 어떻게 잇느냐가 세 발표의 공통 주제였습니다. 원본(ROS bag: 로봇이 겪은 센서 데이터를 시간순으로 녹화한 파일, 저장 형식은 MCAP)은 모든 센서를 각자의 속도로 빠짐없이 기록하는 데 맞춰져 있습니다. 학습용 형식(LeRobot: 로봇이 사람의 시범을 따라 배우는 학습용 데이터 형식)은 시간을 맞추고, 한 번의 작업 단위(에피소드)로 자르고, 성공 여부 같은 설명을 붙여 빨리 읽도록 만든 것입니다.
변환 파이프라인(Roboto): 네 단계로 나눠 변환하기. 색인(긴 녹화를 에피소드로 나눠 목록을 만들고 펌웨어 버전, 보정 상태, 장소, 조명 같은 상황 정보도 함께 기록), 보강(믿을 수 있나, 무엇이 들었나, 성공했나를 계산하거나 판단), 선별(조건 질의 하나로 쓸 데이터만 고름. 슬라이드에서는 998개 에피소드), 변환(설정 파일로 초당 10프레임 학습 데이터를 만듦)입니다. 변환할 때 생기는 문제로 설명 정보 누락, 작업 경계와 파일의 불일치, 센서값 잘림, 데이터 분포 차이, 센서마다 다른 시계를 꼽았고, 이를 한 가지 장치가 아니라 네 단계가 나눠 맡는 구조로 보여 줬습니다
변환을 미루기(Rosetta): 녹화하는 순간에 "어떻게 변환할지"를 정해 버리면 설계가 바뀔 때 다시 녹화해야 합니다. Rosetta는 원본은 그대로 두고, 변환 방법을 Contract(contract.yaml: 변환 규칙을 적어 둔 설정 문서)에 적어 두었다가 학습 직전에 변환합니다. 설정만 고치면 되니(예: 이미지 크기 224를 512로) 다시 녹화할 필요가 없습니다. 다만 문서에 적지 않은 항목은 변환되지 않습니다.
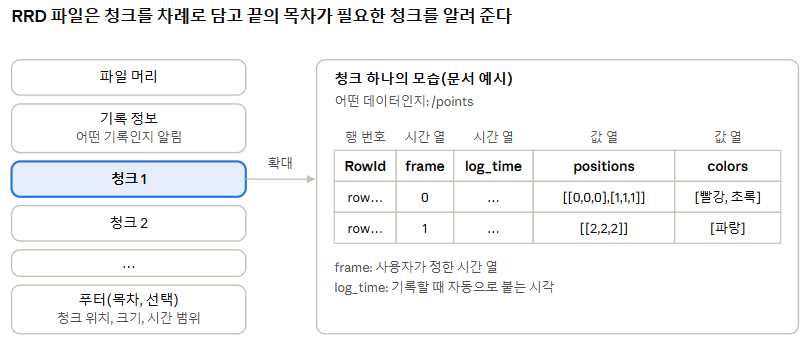
데이터 구조를 바꾸기(Rerun RRD): 변환 파이프라인을 만드는 대신, 시간 색인된 열 지향 데이터를 질의해서 학습 샘플을 즉석에서 만드는 방식입니다. 아래에서 구체적으로 설명합니다.
청크 하나는 "어떤 데이터인지"(경로), 행 번호, 시간 열, 값 열로 이뤄진 작은 표입니다. 시간 열이 여러 개라서 같은 값을 프레임 번호로도, 기록 시각으로도 찾을 수 있습니다.
열 단위 저장이 뭔가요? (설명용 예시) 엑셀 표를 한 줄씩 저장하는 대신 한 열씩 통째로 모아 저장하는 방식입니다.
3.3 데이터 분석 비용의 통제 (Roboto)
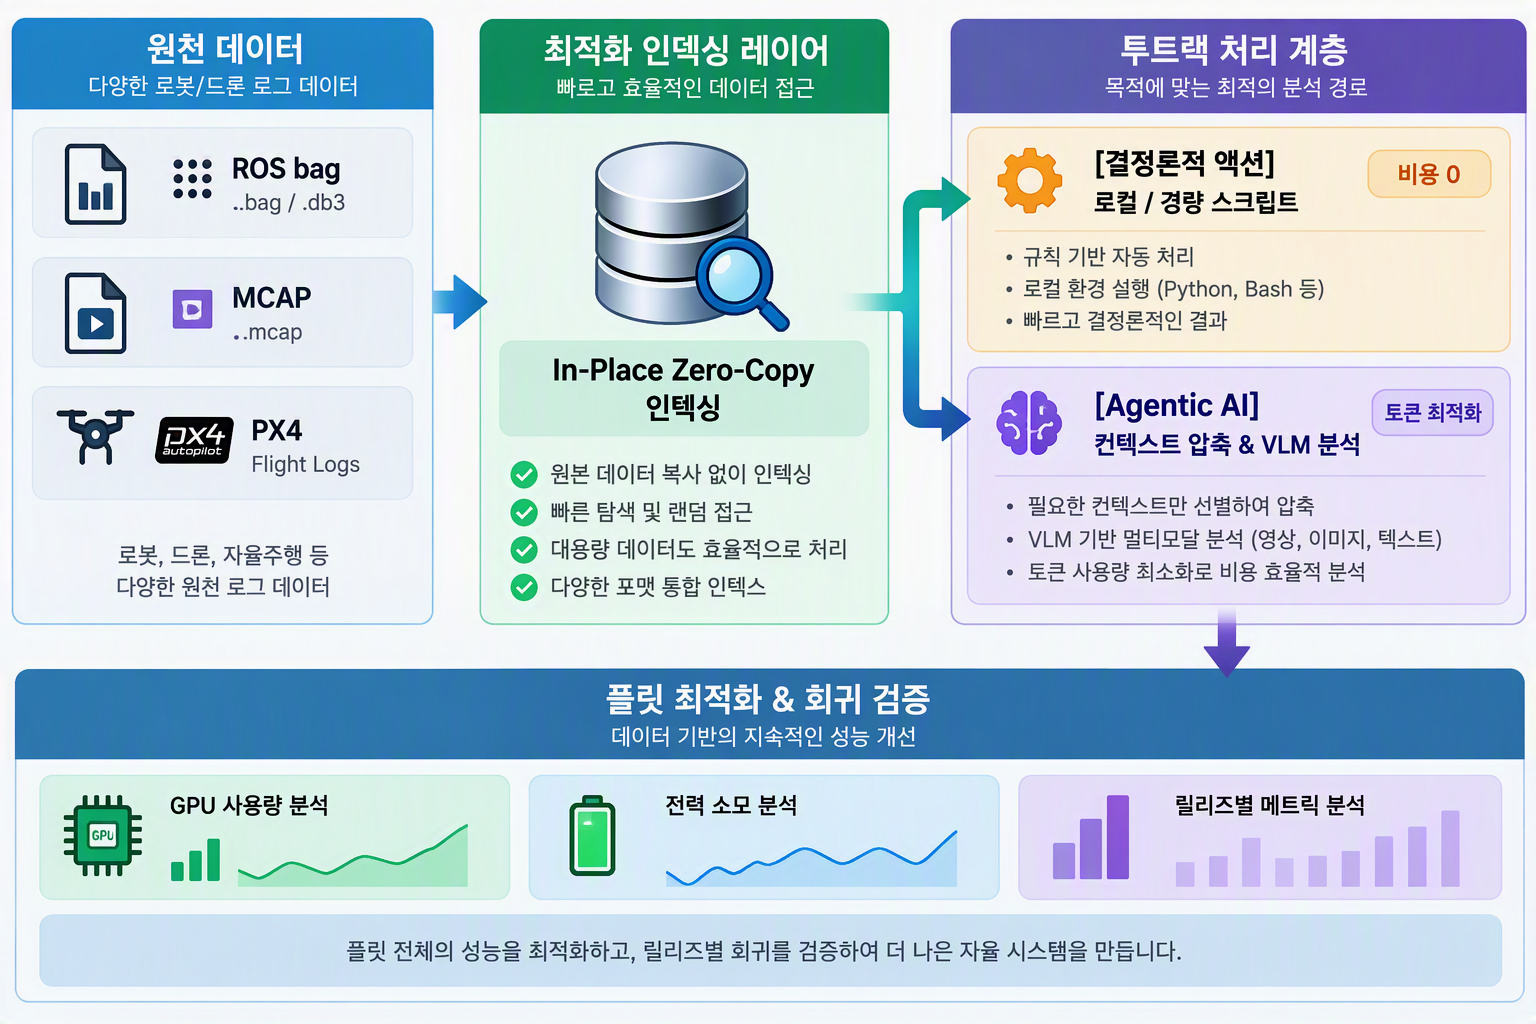
- 원천 데이터 제자리 인덱싱 (In-Place Indexing): 수십 GB의 rosbag/MCAP을 다운로드하지 않고, 스토리지 상에서 SDK로 원하는 IMU나 비디오 구간만 제자리 슬라이싱(Slice & Dice)하여 처리하는 구조를 선보였습니다.
- Actions(결정론적 후처리)를 통한 토큰 최적화: 자력계 노름 계산이나 비상 정지 플래그 확인처럼 기준이 명확한 처리는 경량 파이썬 스크립트(Actions)로 수행해 메타데이터를 정제함으로써 불필요한 LLM 추론 비용과 토큰 낭비를 차단합니다.
- Agentic AI & 멀티모달 분석: 복잡한 장애 분석(RCA)이나 의료 로봇의 그리퍼/소작 이벤트 라벨링처럼 모호한 작업에는 VLM과 에이전트를 결합하여 자동화합니다. 엔지니어가 자연어로 원인을 질의하면 에이전트가 콘솔 로그와 궤적 데이터를 스스로 추적해 Slack 알림과 이슈 티켓을 발행합니다.
- 플릿 줌인 & 줌아웃 (Fleet Metrics): 개별 로그 분석(Zoom In)뿐 아니라 플릿 전체의 소프트웨어 릴리즈별 GPU 사용률, 전력 소모량, 배터리 효율 분포를 Grafana 스타일로 조망(Zoom Out)하여 최적의 파라미터 조합을 도출할 수 있습니다.
4. 심층 분석: DGIST "ROS 2 Middleware Survival Guide"
무선 환경의 통신 문제를 두 개의 피드백 루프(재전송 악순환, 발견 폭풍)로 설명하고, 이를 끊는 도구와 설정을 제시했습니다.
4.1. 문제 틀: 세 보장과 두 개의 피드백 루프
| 보장 |
핵심질문 | 목표 |
|---|---|---|
| Space | 대상이 어디에 있는가 |
위치 투명성 |
| Time | 메시지가 언제 전달 되는가 |
시간 예측 가능성 |
| State | 상태가 어떻게 보존되는가 |
맥락 연속성(재시작과 끊김 후에도 이어짐) |
4.2. 해결 도구와 한계
| 도구 | 풀려는 문제 |
한 줄 설명 |
한계 | 적합한 환경 |
|---|---|---|---|---|
| DDS Optimizer |
재전송 악순환 |
설정값 세 개를 함께 조정. ① 메시지를 네트워크 한도(MTU)보다 작게 만들어 쪼개지지 않게 하고, ② 3초 점호 대신 재전송을 발행 주기의 두 배로 훨씬 자주 하고, ③ 보관 개수를 링크 상황에 맞춤 |
Fast DDS 2.6.x, ROS 2 Humble, 802.11ac에서 튜닝한 값. 다른 엔진이나 링크는 세 값을 다시 구해야 함 |
무선 손실이 있고 큰 메시지(영상)를 보내는 Fast DDS 구간 |
| lever 1: 토폴로지 |
발견 폭풍 |
모두가 모두에게 인사하지 않고, 유선 서버의 중계소(라우터, Fast DDS Discovery Server)에 로봇이 연결 |
중계소가 고장 나면 전체가 멈추는 단일 장애점. 설정이 정적 |
로봇이 계속 늘어나는 무선 플릿 |
| lever 2: 컴포지션 |
발견 폭풍 |
프로그램 여러 개를 한 프로세스에 묶어 "참여자" 수를 줄임. 같은 40개 연결도 한 프로세스면 한가하고 8개로 쪼개면 채널이 포화 |
한 프로그램의 고장이 다른 것에 번질 수 있고, 프로그램별 통신 설정 분리가 약해짐 |
로봇 안에 프로그램이 많은 경우 |
| lever 3: 데몬 끄기 |
발견 폭풍 |
명령행 도구를 빠르게 하려고 떠 있는 참여자 하나를 끔(ROS_DAEMON_ENABLED=0) |
절감 수치는 없고 참여자가 하나 줄 뿐. ros2 topic list가 느려짐 |
호스트가 많은 환경 |
| QoS Guard |
QoS 설정 실수 |
코드를 합치기 전에 통신 설정(QoS) 충돌을 규칙 40개로 자동 검사(밀리초 단위) |
설정만 볼 뿐 실제로 막힌 링크는 못 잡음. Cyclone DDS는 읽을 XML 설정 파일이 없음 |
여러 사람이 코드를 합치는 프로젝트 |
| ros2probe | 문제를 정확히 보기 |
커널이 가진 패킷 사본을 읽는 수동 관찰. 관찰자가 통신에 끼지 않아 실제 손실을 그대로 봄(rosbag2는 실제 손실을 9%만 감지, ros2probe는 전부 감지) |
Linux와 커널 접근 필요 |
참여하지 않고 무선 링크 손실을 진단 |
5. 실무 시사점 및 제언: Physical AI 시대를 준비하는 로보틱스 전략
- 칩셋보다 통신 설계와 측정이 먼저입니다. 고성능 칩을 도입해도 Edge 서버와 온디바이스 Agent 사이 무선 구간의 영상 조각 손실, 재전송 악순환, 서로 찾기 폭주는 사라지지 않습니다. 우리 워크로드를 녹화해 후보 통신 엔진(Fast DDS, Cyclone DDS, Zenoh)을 같은 조건에서 비교하고 점수표(Pugh 매트릭스)로 선정하는 것이 먼저입니다.
- 복사는 같은 컴퓨터 안에서, 무선 구간은 따로 줄입니다. Zero-copy는 로봇 내부와 Edge 내부, On Device 내부 처럼 같은 호스트 안에서 효과가 납니다. 무선 구간은 영상 압축, 통신 설정 튜닝, 서로 찾기 범위 축소로 따로 대응해야 하므로, 내부 통신과 외부 통신은 분리해서 대응해야합니다.
- 로그는 처음부터 질의할 수 있는 형식으로 남깁니다. 표준 기록 형식(MCAP)으로 기록하고 펌웨어, 보정 상태, 장소 같은 상황 정보를 함께 남기며, 학습 데이터 준비는 변환 규칙을 설정으로 분리하거나 열 단위 저장(RRD 등)으로 질의하는 방식을 비교해 정합니다. 원본을 방치하면 학습 데이터를 만들 때마다 변환 비용이 반복됩니다.
- 반복 분석은 규칙(코드)에, AI 에이전트는 판단에 씁니다. 스트림 누락, 멈춘 센서 같은 반복 검사와 지표는 코드(Actions)로 자동 처리하고, 원인 조사와 애매한 판단에만 AI 에이전트를 씁니다.
- 기술 도입 전에는 우리 환경에서 다시 확인해야 합니다. 실제 링크에서 재측정하고 벤더 종속과 데이터 반출 정책을 확인한 뒤 적용합니다.
- VLA나 원격 조종을 붙일 때 명령과 구동 사이에 한계와 충돌을 걸러 주는 계층(PEG 같은 구조)을 둘지 RAI 관점에서 검토가 필요합니다.