1. 🏛️ 도입·학회 소개
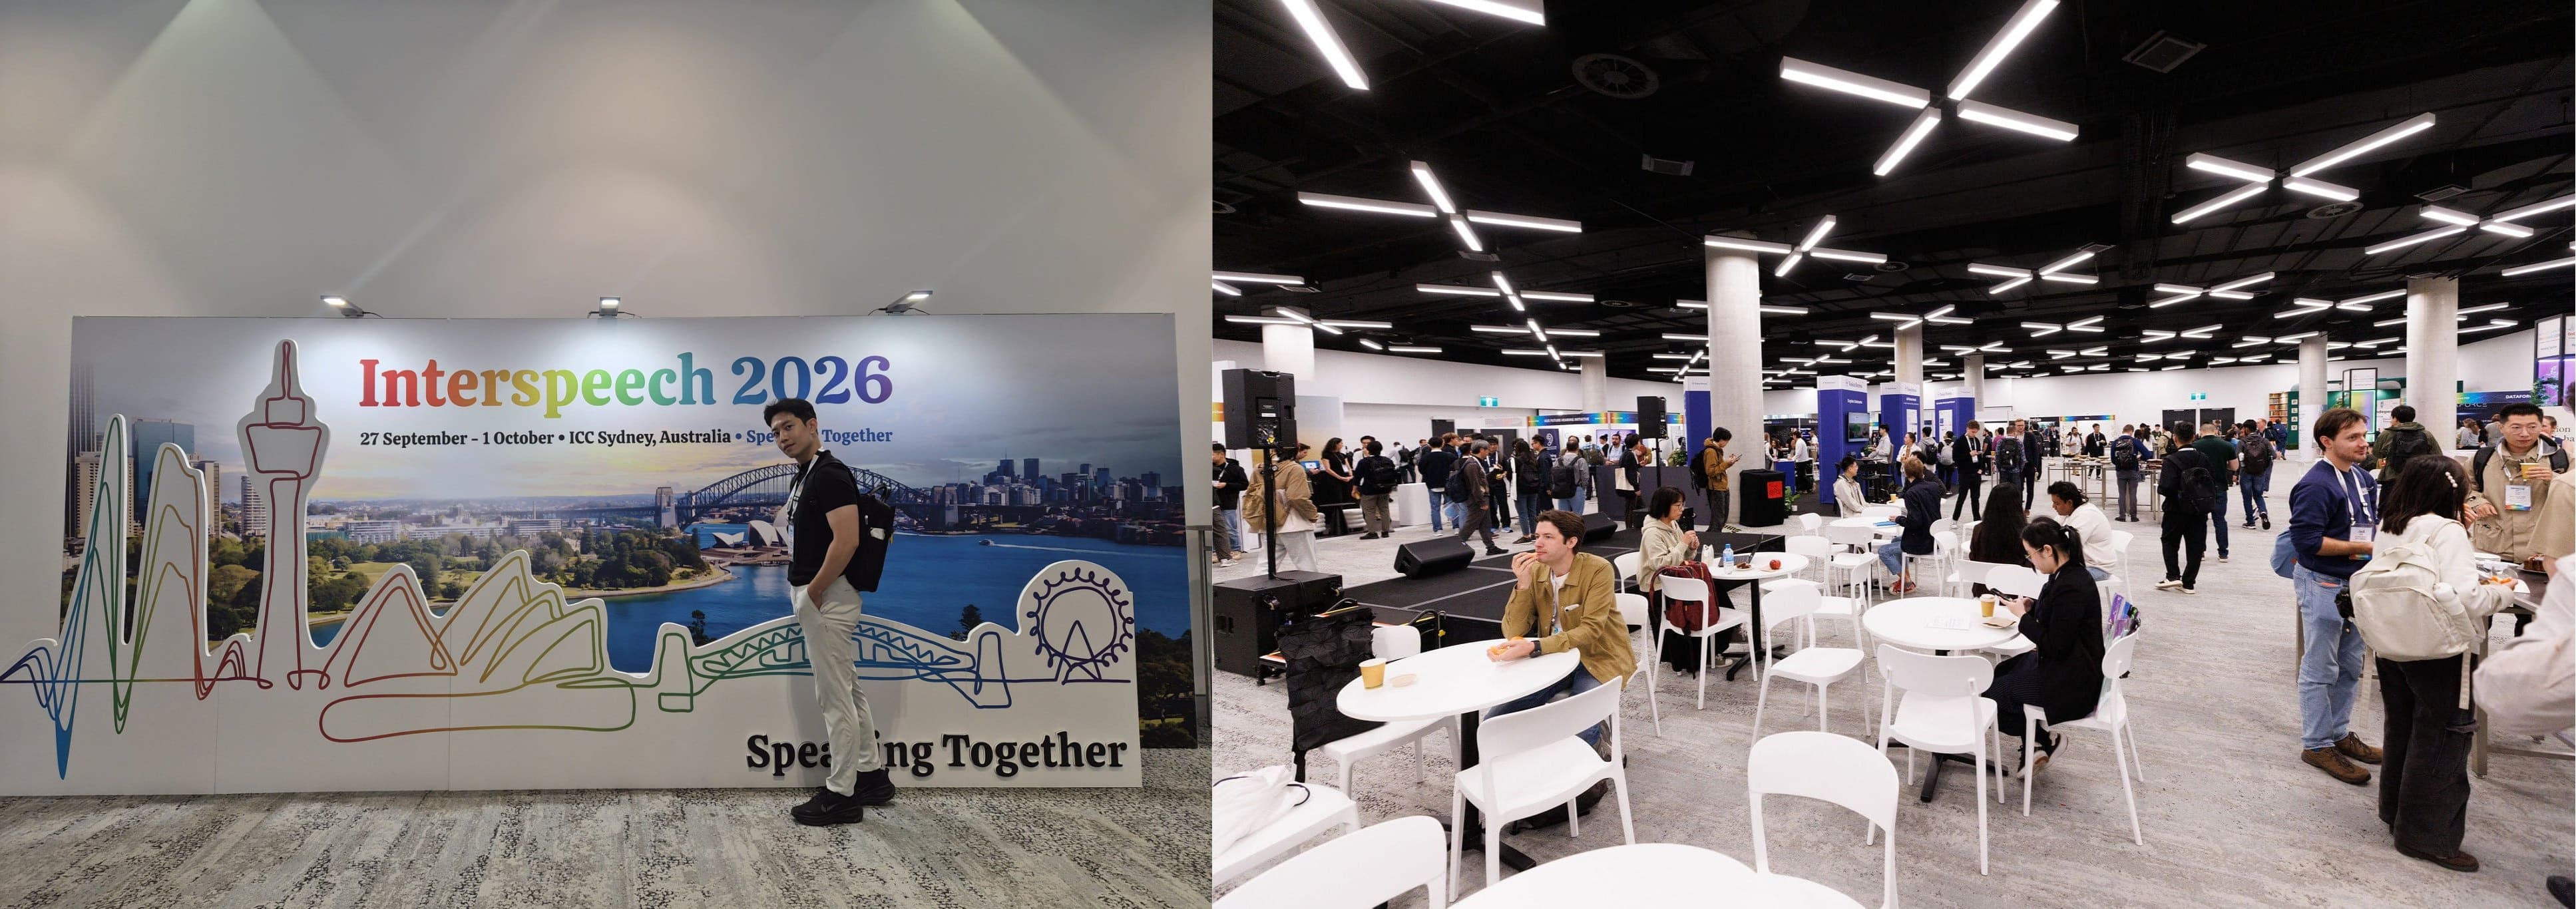
안녕하세요, KT AX미래기술원 Frontier AI Lab 김지환입니다. 2026년 9월 28일부터 10월 1일까지 호주 시드니에서 열린 Interspeech 2026에 참석해, 서울대학교 김남수 교수님과 함께 연구한 ‘ZipL-Dialog’를 포스터로 발표했습니다. 이번 참석의 목적은 두 가지였습니다. 긴 대화 음성을 적은 메모리로 합성하는 저희 연구를 소개하고, 관련 논문과 키노트를 통해 음성 AI의 다음 과제를 확인하는 것이었습니다.
Interspeech는 국제음성커뮤니케이션협회(ISCA)가 주최하는 음성 분야의 대표 국제학회입니다. 음성 인식과 합성, 음성 향상, 화자 처리, 음성 과학 등 폭넓은 주제를 다루며, 학계와 산업계 연구자가 최신 성과를 발표하고 교류합니다. 올해는 시드니 국제컨벤션센터(ICC Sydney)에서 열렸습니다.[1]
이번 글의 핵심 질문은 “긴 대화를 자연스럽고 효율적으로 합성하려면 무엇이 필요하고, 이를 실제 서비스에 적용하려면 무엇을 더 검증해야 할까?”입니다. 음성 AI 서비스는 소리를 입력받고(입력), 음성을 만들고(생성), 그 음성을 믿고 쓸 수 있어야(신뢰) 완성됩니다. 이 흐름에 맞춰 제 발표 논문을 먼저 소개한 뒤, 현장에서 살펴본 연구 흐름과 논문 세 편, 키노트 두 편을 정리하고, KT 관점의 적용 가능성과 검증 과제를 공유하겠습니다.
2. 📄 KT 발표 논문 소개: ZipL-Dialog
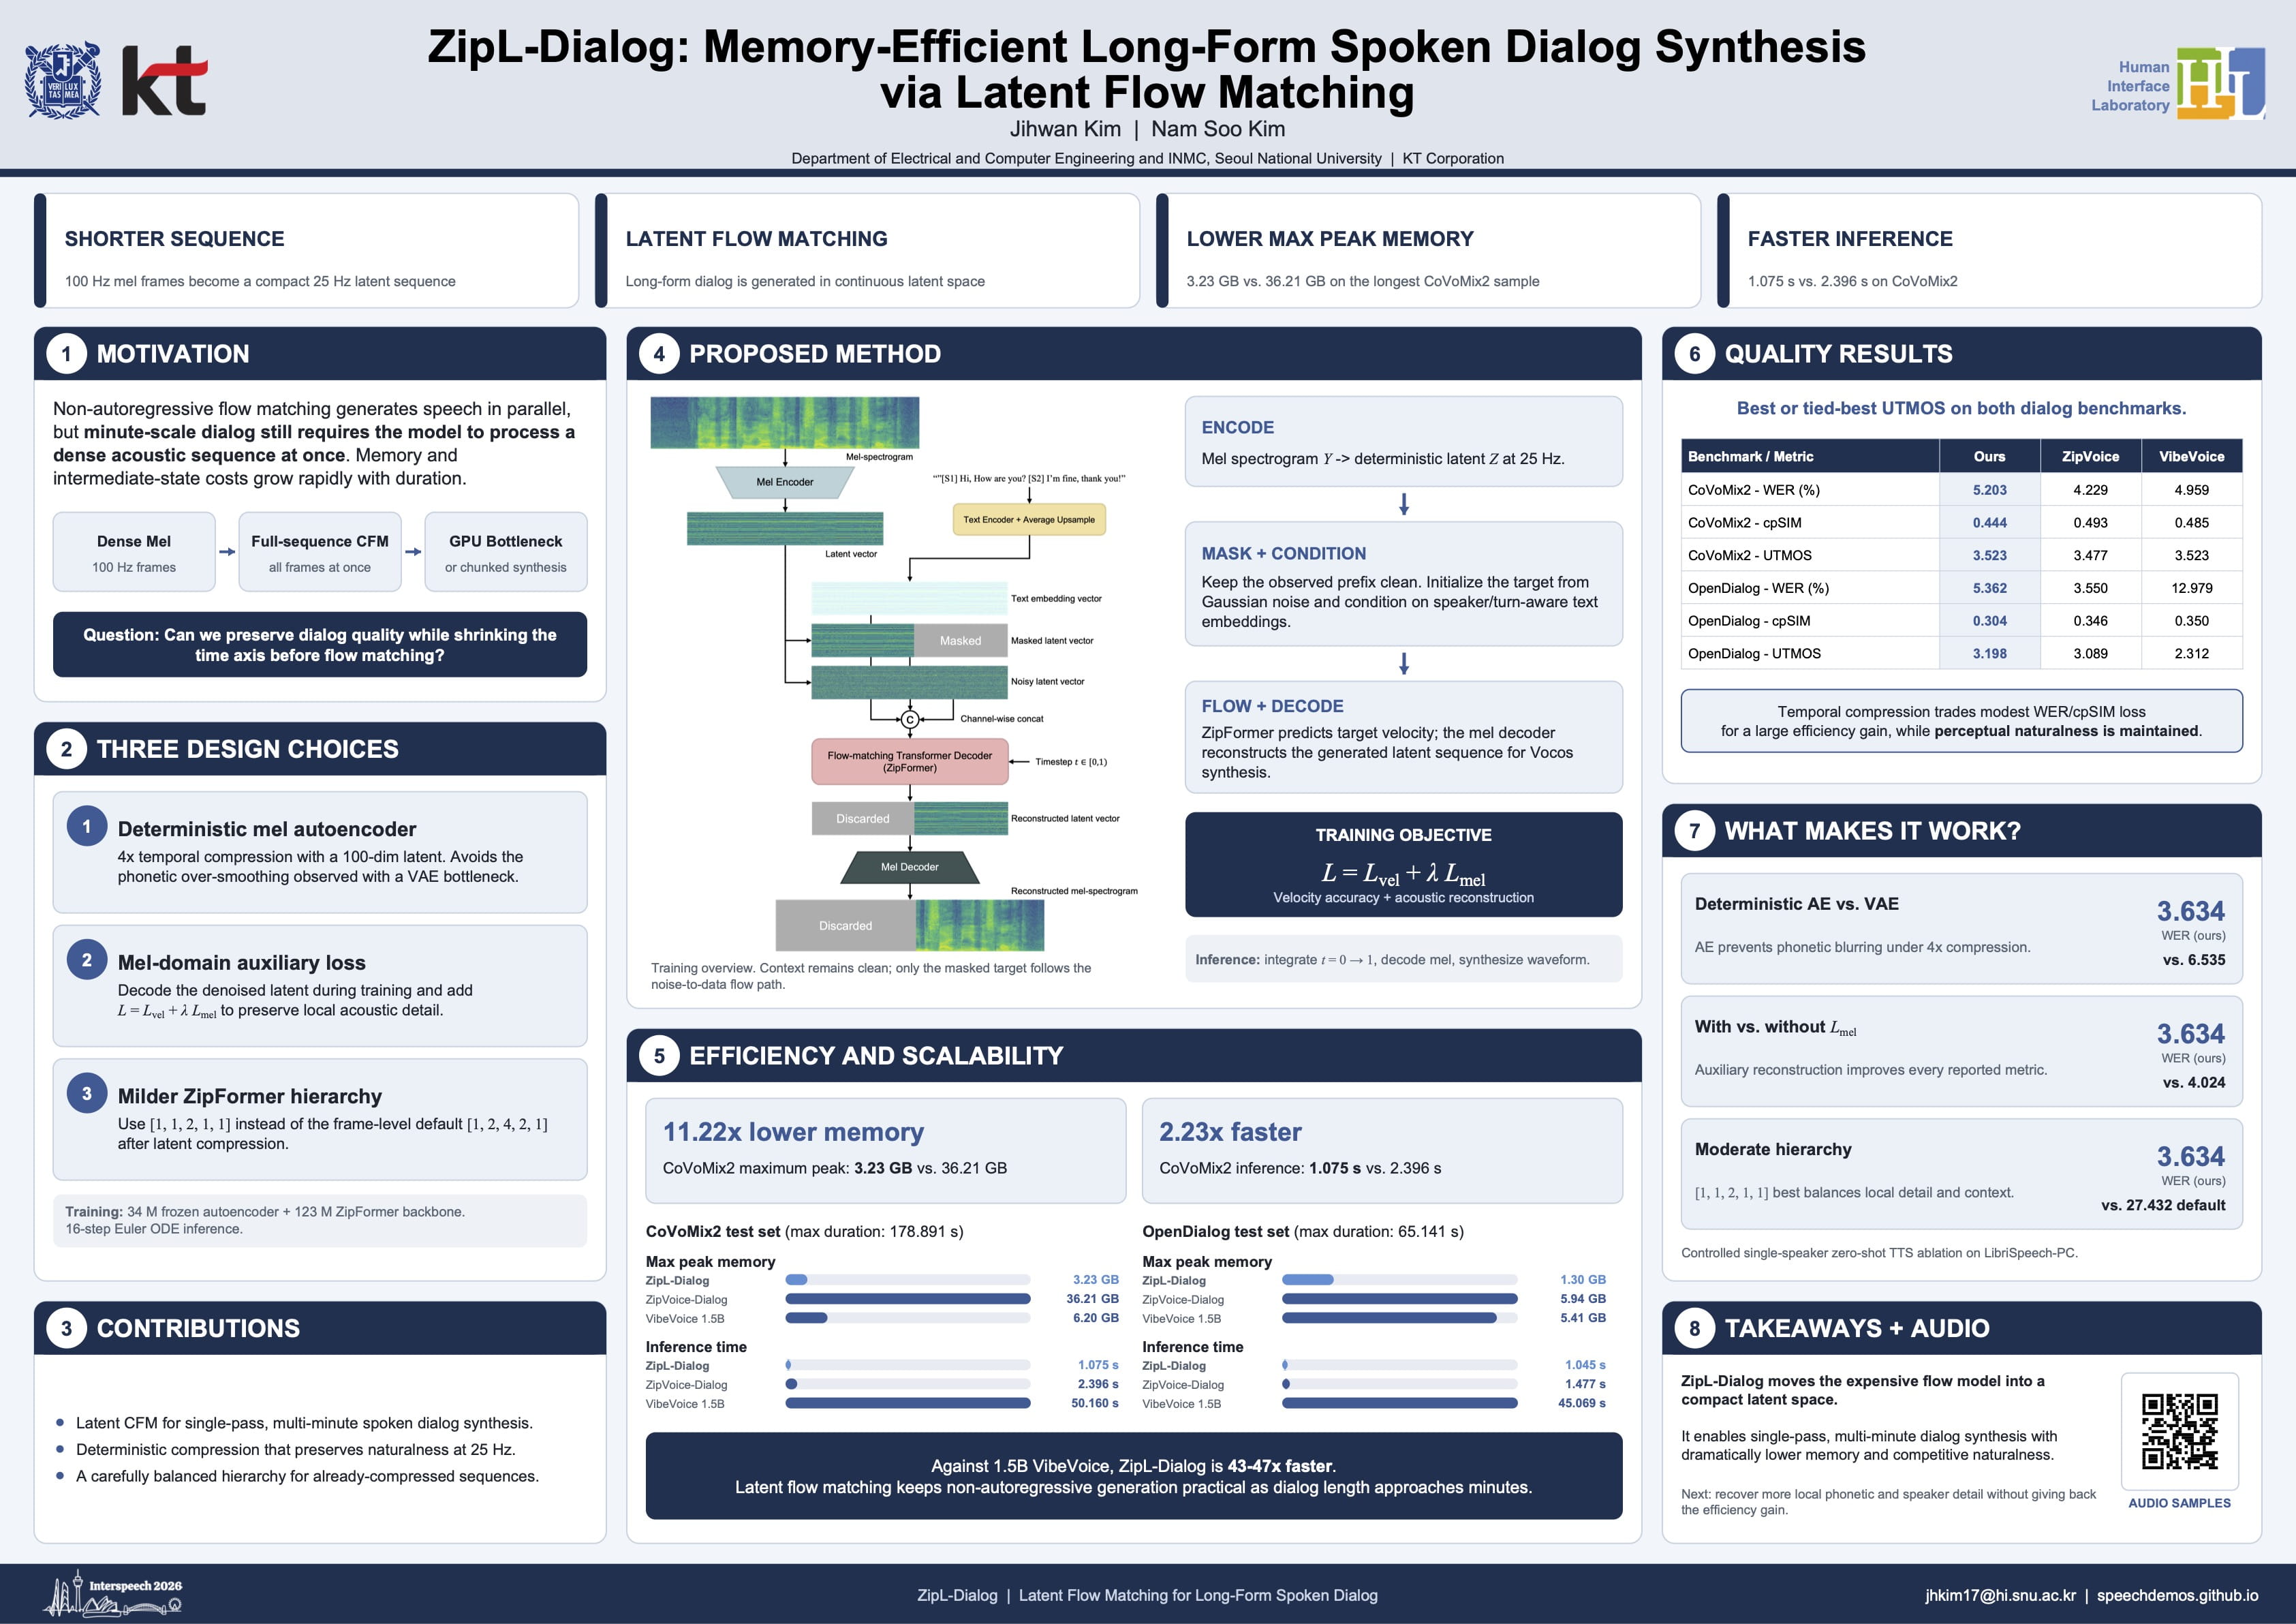
이번에 발표한 논문은 ‘ZipL-Dialog: Memory-Efficient Long-Form Spoken Dialog Synthesis via Latent Flow Matching’입니다. 여러 화자가 번갈아 말하는 긴 대화를 한 번에 생성할 때 생기는 GPU 메모리 부담을 줄이는 연구입니다.[2]
2-1. 연구 배경과 해결 과제: 긴 대화를 한 번에 만들기 어려운 이유
음성 합성은 짧은 문장을 읽는 수준을 넘어, 팟캐스트나 대화형 에이전트처럼 여러 화자가 오가는 긴 음성을 만드는 방향으로 발전하고 있습니다. 이때 모델은 화자별 목소리와 대화의 흐름을 끝까지 유지해야 합니다.
기존 접근에는 각각 한계가 있습니다. 음성을 순서대로 생성하는 자기회귀(AR) 방식은 품질이 좋지만 생성 시간이 음성 길이에 비례해 늘어납니다. 반대로 flow matching 같은 비자기회귀(NAR) 방식은 음성 전체를 병렬로 생성해 빠르지만, 100Hz 멜 스펙트로그램처럼 촘촘한 표현을 통째로 처리하기 때문에 대화가 길어질수록 GPU 메모리 사용량이 크게 늘어납니다. 결국 긴 대화를 짧게 잘라 생성해야 하고, 이는 대화 전체의 맥락과 화자 일관성을 유지하기 어렵게 만듭니다.
그래서 저희는 다음 질문에서 출발했습니다. “음향 정보를 압축한 공간에서 대화를 생성하면, 자연스러움을 유지하면서도 긴 대화를 더 적은 자원으로 만들 수 있지 않을까?”
2-2. 핵심 방법: 압축된 잠재 공간에서 대화 생성
ZipL-Dialog는 100Hz 멜 스펙트로그램을 시간축으로 4배 압축한 25Hz 잠재 표현으로 바꾼 뒤, 이 공간에서 flow matching을 수행합니다. 모델이 처리하는 시퀀스가 4분의 1로 짧아져 메모리와 계산 부담이 함께 줄어듭니다. 생성이 끝나면 잠재 표현을 멜 스펙트로그램으로 복원하고, 보코더로 음성 파형을 만듭니다.
다만 시간축을 강하게 압축하면 발음의 미세한 차이나 화자 특성이 흐려질 수 있어 두 가지 설계를 더했습니다.
첫째, 변분(VAE) 방식 대신 결정론적 멜 오토인코더를 사용하고 멜 영역의 보조 복원 손실을 추가했습니다. 변분 방식은 강한 압축에서 음향 세부 정보가 과하게 뭉개지는 경향이 있었고, 결정론적 표현은 모델 용량을 복원 정확도에 집중시킬 수 있었습니다.
둘째, ZipFormer의 단계별 다운샘플링 구조를 압축된 입력에 맞게 다시 설계했습니다. 기존 구조는 촘촘한 입력을 전제로 만들어져 있어, 이미 압축된 입력에 그대로 쓰면 짧은 음소를 표현하는 데 필요한 시간 해상도까지 잃게 됩니다. 저희는 이 단계를 완만하게 조정한 구조를 선택했습니다.
2-3. 결과와 의의
효율은 단일 NVIDIA A100 40GB GPU에서 프롬프트 처리부터 파형 합성까지 포함해 측정했습니다. CoVoMix2 대화 평가에서 ZipL-Dialog의 최대 피크 GPU 메모리는 3.23GB로, 같은 계열의 NAR 모델인 ZipVoice-Dialog(36.21GB)의 약 1/11(논문 보고치 11.22배 감소) 수준이었습니다. 평균 추론 시간도 2.396초에서 1.075초로 약 2.23배 빨라졌습니다. OpenDialog 평가에서도 최대 피크 메모리가 5.94GB에서 1.30GB로 줄었습니다. 대규모 AR 모델인 VibeVoice 1.5B와 비교하면 추론 시간이 두 평가 세트에서 각각 약 47배, 43배 짧았습니다.
품질에서는 득실이 함께 있었습니다. 자연스러움을 자동으로 추정하는 UTMOS는 CoVoMix2에서 3.523으로 VibeVoice와 공동 최고, OpenDialog에서는 3.198로 가장 높았습니다. 반면 ZipVoice-Dialog와 비교하면 단어 오류율(WER)과 화자 유사도(cpSIM)는 두 평가 세트 모두에서 다소 낮았습니다. 예를 들어 CoVoMix2의 WER은 4.229%에서 5.203%로 높아졌고, cpSIM은 0.493에서 0.444로 낮아졌습니다. 압축으로 메모리와 시간을 크게 줄이는 대신 발음과 화자 유사도의 일부를 내어준 셈입니다.
단일 화자 합성으로 진행한 추가 실험에서는 두 설계의 효과가 확인됐습니다. 변분 방식을 결정론적 오토인코더로 바꾸자 WER이 6.535%에서 3.634%로 낮아졌고, 기존 기본 다운샘플링 구조에서는 WER이 27.432%까지 올라 크게 악화됐습니다. 압축된 표현에서는 구조 설계가 품질을 좌우한다는 뜻입니다.
이 연구의 의의는 긴 대화 합성의 메모리와 시간 부담을 크게 줄이면서 자동 평가에서 경쟁력 있는 자연스러움을 확보한 데 있습니다. 한계도 분명합니다. 실험은 영어 데이터와 두 대화 벤치마크에서만 수행했고, UTMOS는 자동 추정 지표라 실제 청취 평가가 필요합니다. 논문의 시간 단축은 전체 음성을 만드는 데 걸린 시간이므로, 실시간 서비스에서 중요한 첫 음성 출력 지연을 그대로 의미하지 않습니다. 한국어 발음 정확도와 더 긴 대화에서의 화자 유지도 후속 검증 과제입니다.
3. 🔍 학회 주요 연구 동향
3-1. 합성 효율과 지각 품질을 함께 높이는 연구
현장에서 가장 눈에 띈 흐름은 음성 합성의 개선 지점이 여러 단계로 나뉘어 있다는 점입니다. ZipL-Dialog는 생성할 음향 표현을 압축해 비용을 줄이고(표현), FlowTTS-GRPO는 이미 학습된 flow matching 모델을 화자 유사도·발음 정확도·지각 품질 보상으로 추가 학습하며(post-training), RAF는 음향 특징을 파형으로 바꾸는 보코더의 학습 목표를 개선합니다(파형 복원).[2–4] 효율과 품질을 한 모델에서 동시에 해결하기보다, 단계별로 나누어 개선하려는 접근이 함께 논의되고 있었습니다.
입력 쪽에서는 Spatial-Magnifier가 흥미로운 질문을 던졌습니다. 소형 기기에 마이크를 더 달기 어렵다면, 가상 마이크 신호를 추정해 공간 정보를 보완할 수 있는지를 다룹니다. 합성과는 별개의 음성 향상 과제이지만, 음성 AI의 입력 품질을 높인다는 점에서 함께 살펴보았습니다.[5]
3-2. 키노트: 음성 생성 AI의 책임 있는 활용
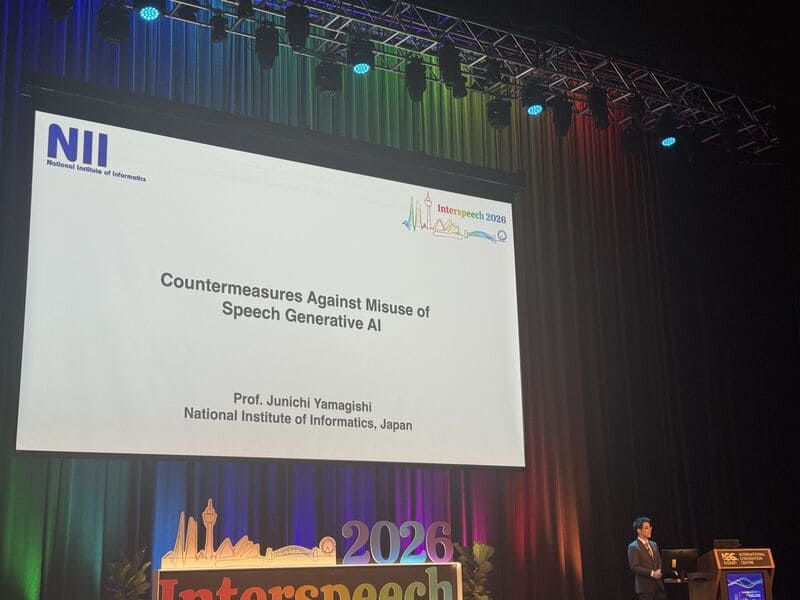
Junichi Yamagishi 교수님의 ‘Countermeasures Against Misuse of Speech Generative AI’ 는 음성 생성 AI가 접근성 지원과 콘텐츠 제작에 기여하는 한편, 사칭 사기와 허위 정보 확산에 악용될 수 있다는 문제에서 출발했습니다. 강연에서는 만들어진 음성을 사후에 가려내는 딥페이크 탐지(사후 대응)와, 사람이 들을 수 없는 정보를 음성에 심어 생성 단계부터 악용을 어렵게 하는 사전 대응을 함께 다뤘습니다. 이는 오디오 워터마킹, 출처 증명 체계인 C2PA와 결합한 여러 겹의 방어 체계로 이어집니다.[6]
특히 딥페이크 탐지를 한 번 만들고 끝나는 모델이 아니라 계속 운영해야 하는 시스템으로 본 관점이 인상 깊었습니다. 생성 모델이 빠르게 바뀌므로 탐지 모델도 갱신해야 하는데, 갱신할수록 데이터 수집과 학습 비용이 늘어납니다. 그래서 데이터 분포의 변화(drift)를 감지해 추가 학습 시점을 판단하고, 탐지 성능을 유지하면서 비용을 관리하는 방법이 논의됐습니다.[6]
3-3. 키노트: 단어를 안다는 것의 의미
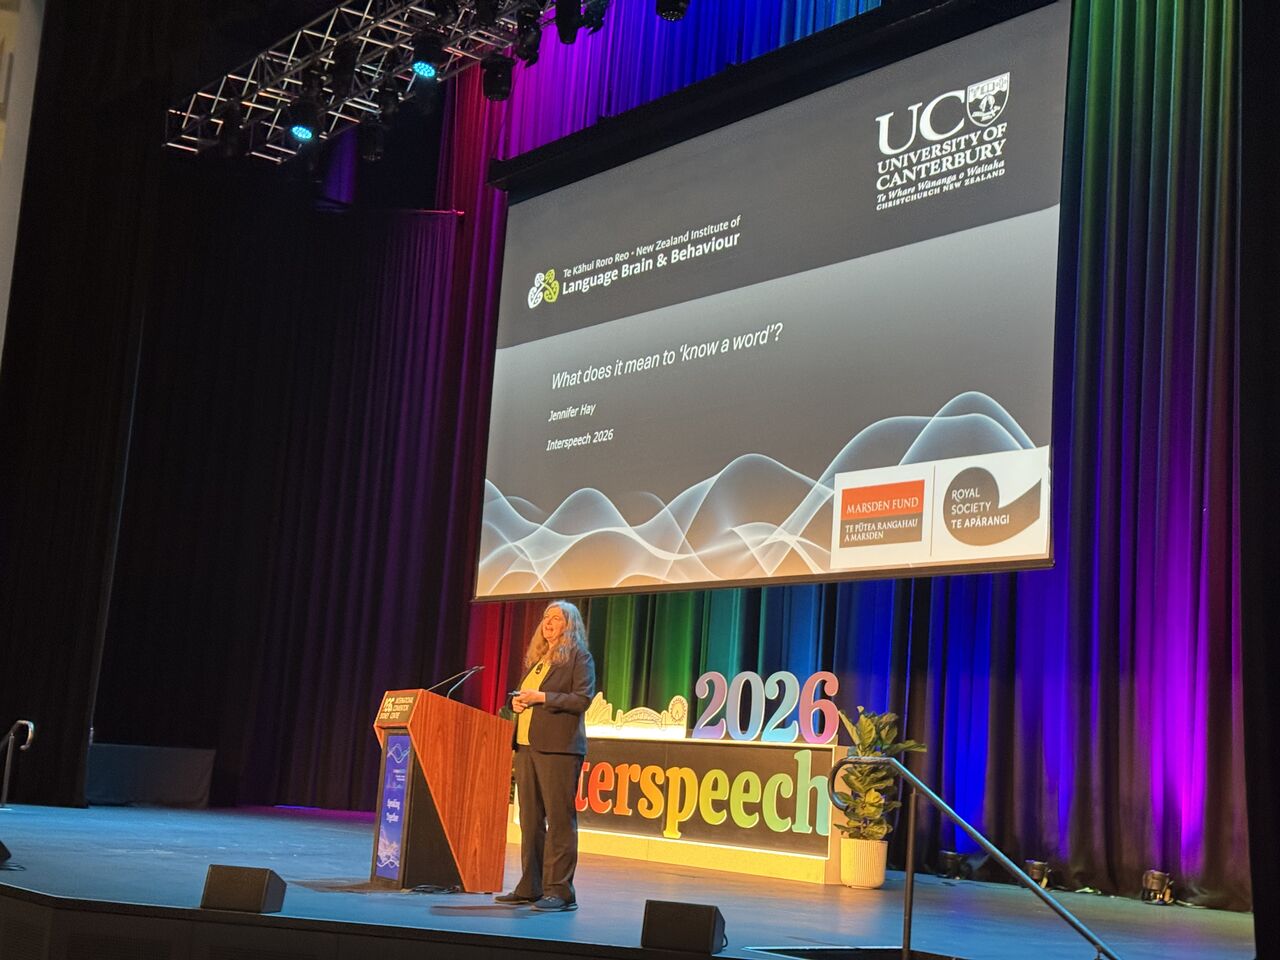
Jen Hay 교수님의 ‘What does it mean to “know a word”?’ 는 단어를 안다는 것이 단순히 뜻을 설명할 수 있다는 의미인지 물었습니다. 익숙한 단어에 대해서는 뜻뿐 아니라 미세한 발음과 사회적·사용 맥락까지 풍부한 정보가 기억되고, 이것이 음성 지각에 활용된다는 연구를 소개했습니다.[6]
반대편 사례가 te reo Māori(뉴질랜드 마오리어)입니다. 연구에 따르면 마오리어를 구사하지 않는 뉴질랜드인도 주변에서 접한 경험만으로 특정 단어가 존재한다는 암묵적 지식을 가질 수 있습니다. 본인이 알고 있다고 의식하지 못해도 단어에 대한 초기 지식이 생긴다는 것입니다. 이 사례는 단어 지식을 ‘안다/모른다’로 나누기보다 노출과 경험에 따라 쌓이는 여러 층위로 보게 했고, 음성 기술을 평가할 때도 텍스트 정확성과 함께 사람이 발음·맥락을 어떻게 지각하는지 고려해야 한다는 생각으로 이어졌습니다.[6]
4. 📚 다른 주요 논문 심층 분석
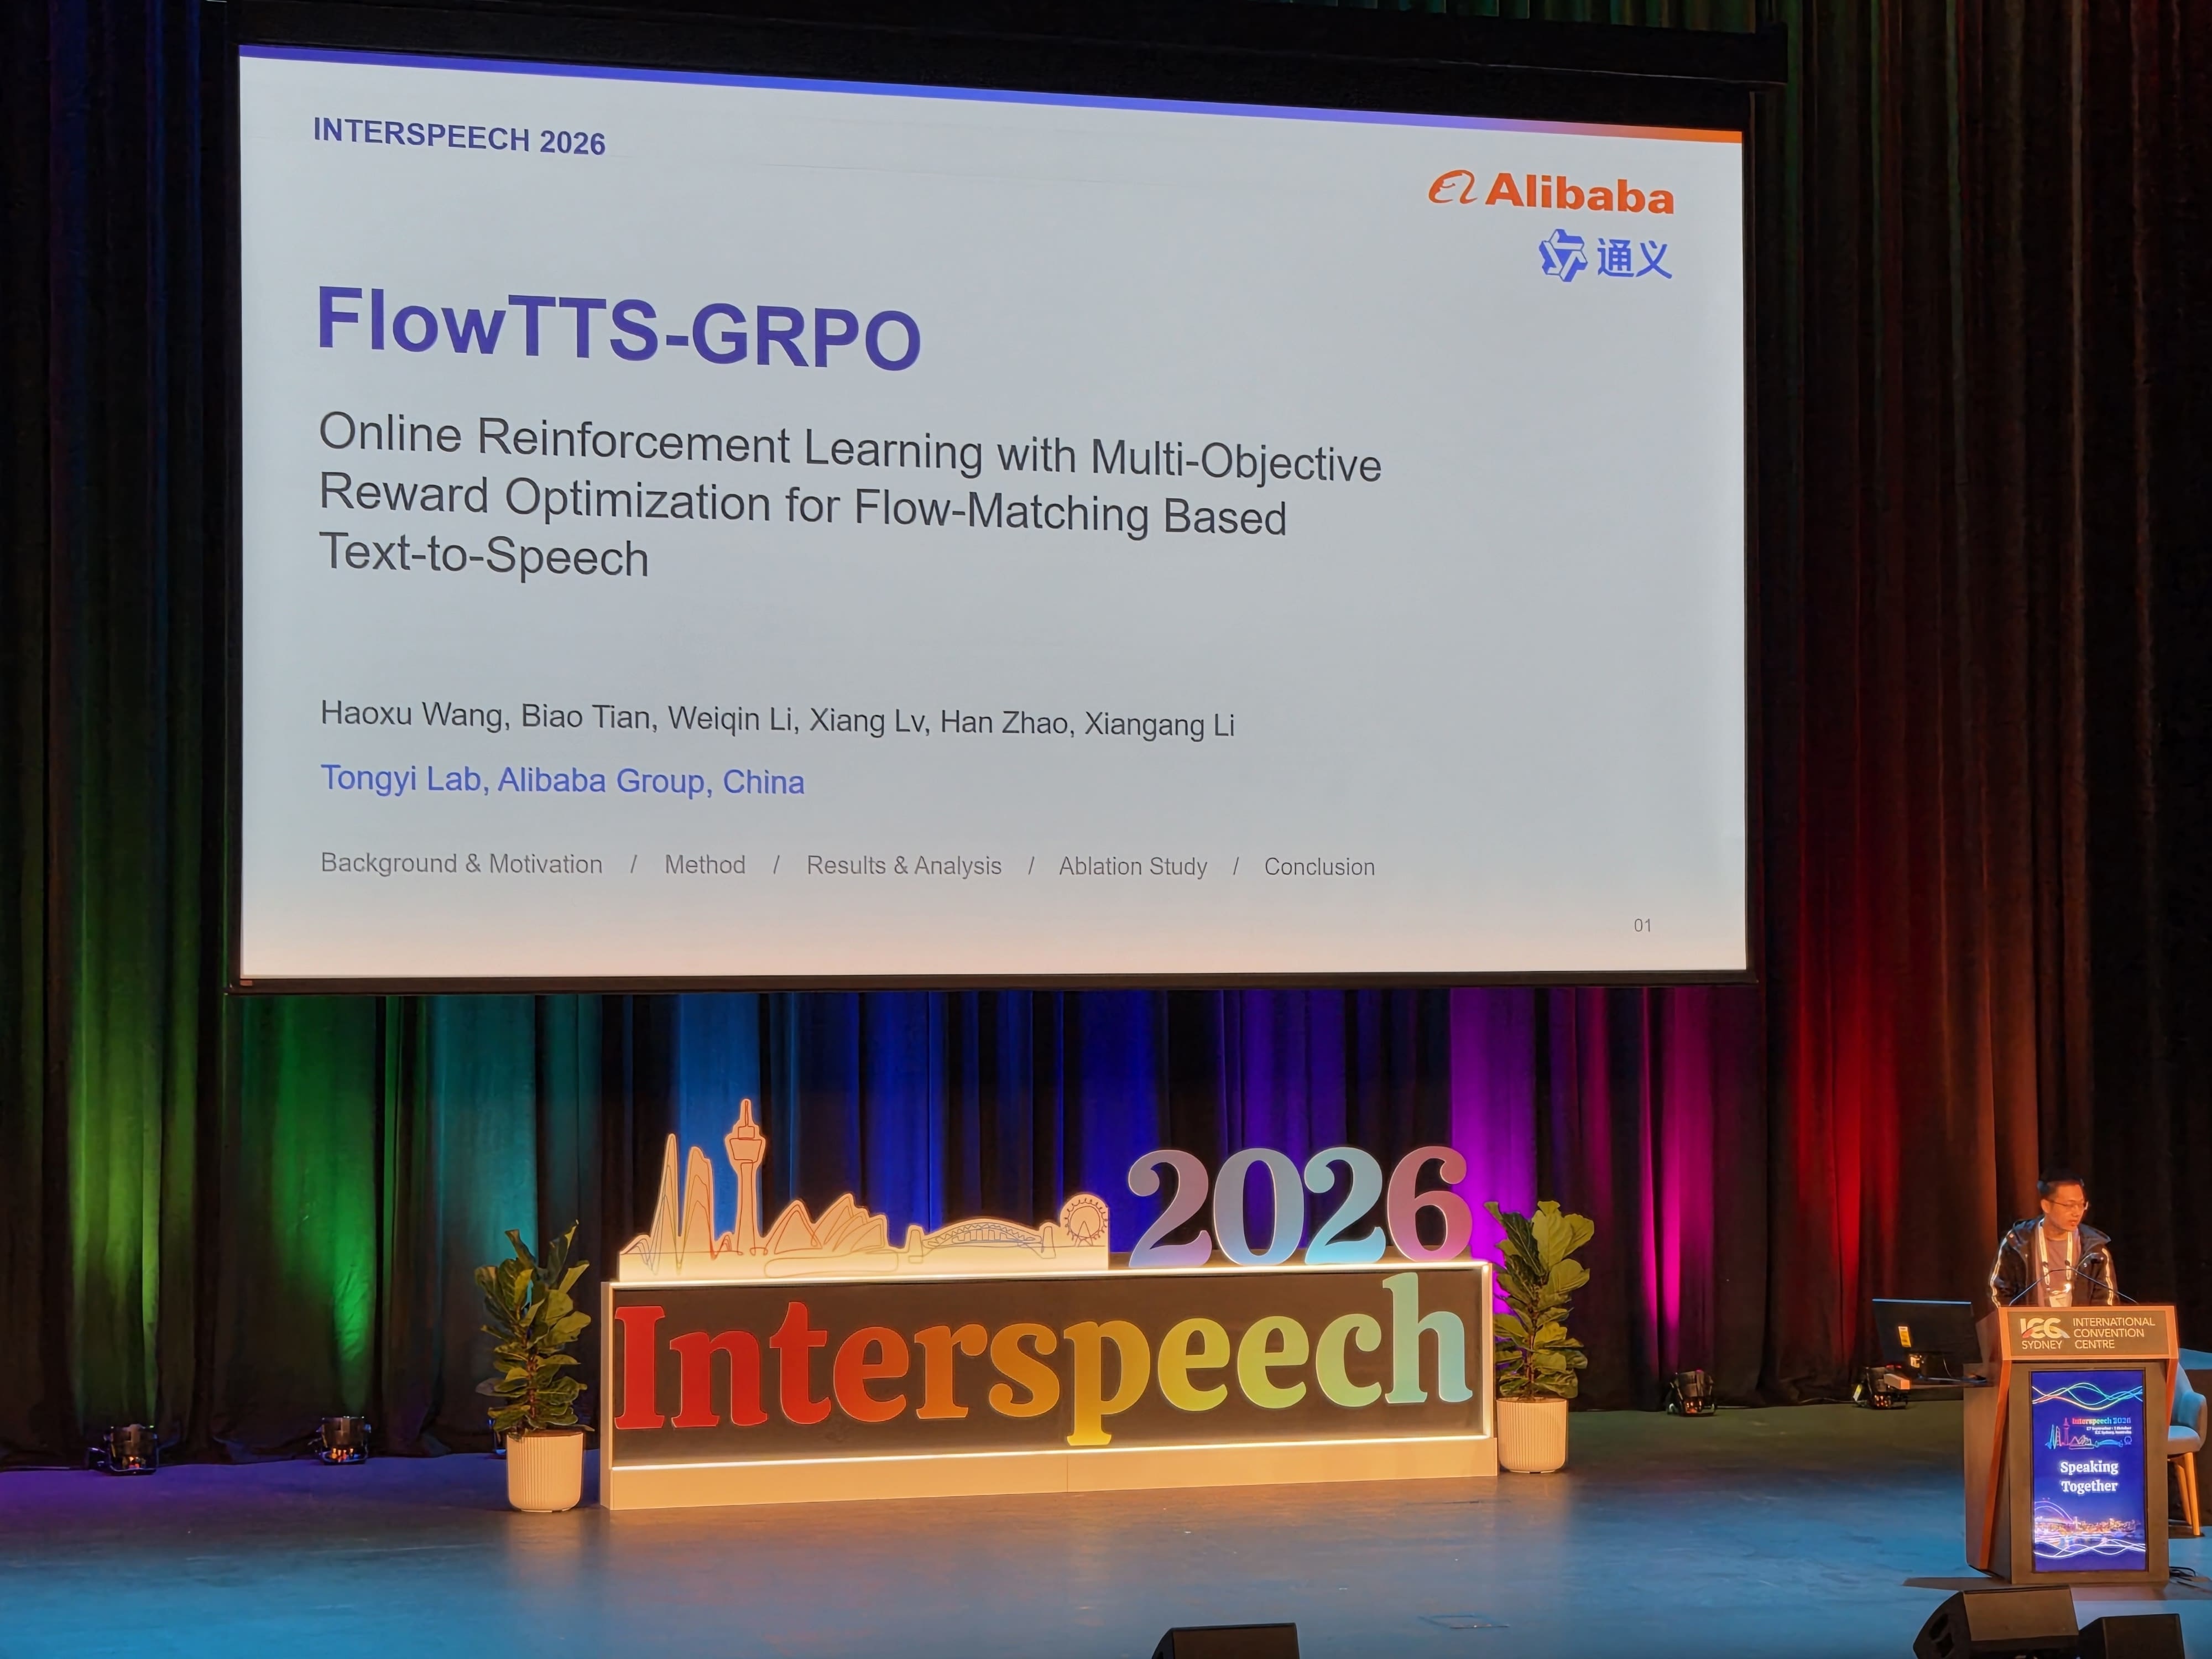
4-1. FlowTTS-GRPO: flow matching TTS에 다중 목표 강화학습 적용
문제 정의: 강화학습은 주로 언어모델 기반 TTS에 적용돼 왔고, flow matching 모델은 상대적으로 연구가 부족했습니다. 이 논문은 flow matching 모델의 생성 결과를 화자 유사도, 내용 정확도, 지각 품질에 맞춰 추가 학습하는 문제를 다룹니다.[3]
접근법: 연구진은 결정론적인 생성 경로(ODE)에 확률적 변화를 도입해(SDE) 같은 조건에서 만든 여러 후보의 보상을 비교하는 GRPO를 적용했습니다. 척도가 다른 보상은 정규화한 뒤 가중합으로 결합하고, 단어나 문장이 반복되는 어려운 입력도 학습에 포함해 안정성을 높였습니다.[3]
결과: Seed-TTS-Eval 중국어 평가에서 CosyVoice 3.0의 화자 유사도는 ERes2Net 기준 0.830에서 0.859로, 학습 보상에 쓰지 않은 WavLM 기준으로도 0.777에서 0.804로 올랐습니다. F5-TTS에서는 영어 WER이 1.88%에서 1.73%로 낮아져, 모델 구조에 따라 내용 정확도도 개선할 수 있음을 보였습니다.[3]
한계: 언어모델과 flow matching을 결합한 CosyVoice 3.0에서는 음향 생성부만 추가 학습해서는 내용 정확도가 일관되게 좋아지지 않았습니다. 또한 학습에는 기존 음성 인식·화자 검증·음질 평가 모델이 필요하고, 자동 보상의 개선이 모든 언어와 상황의 청취 선호를 보장하지는 않습니다.
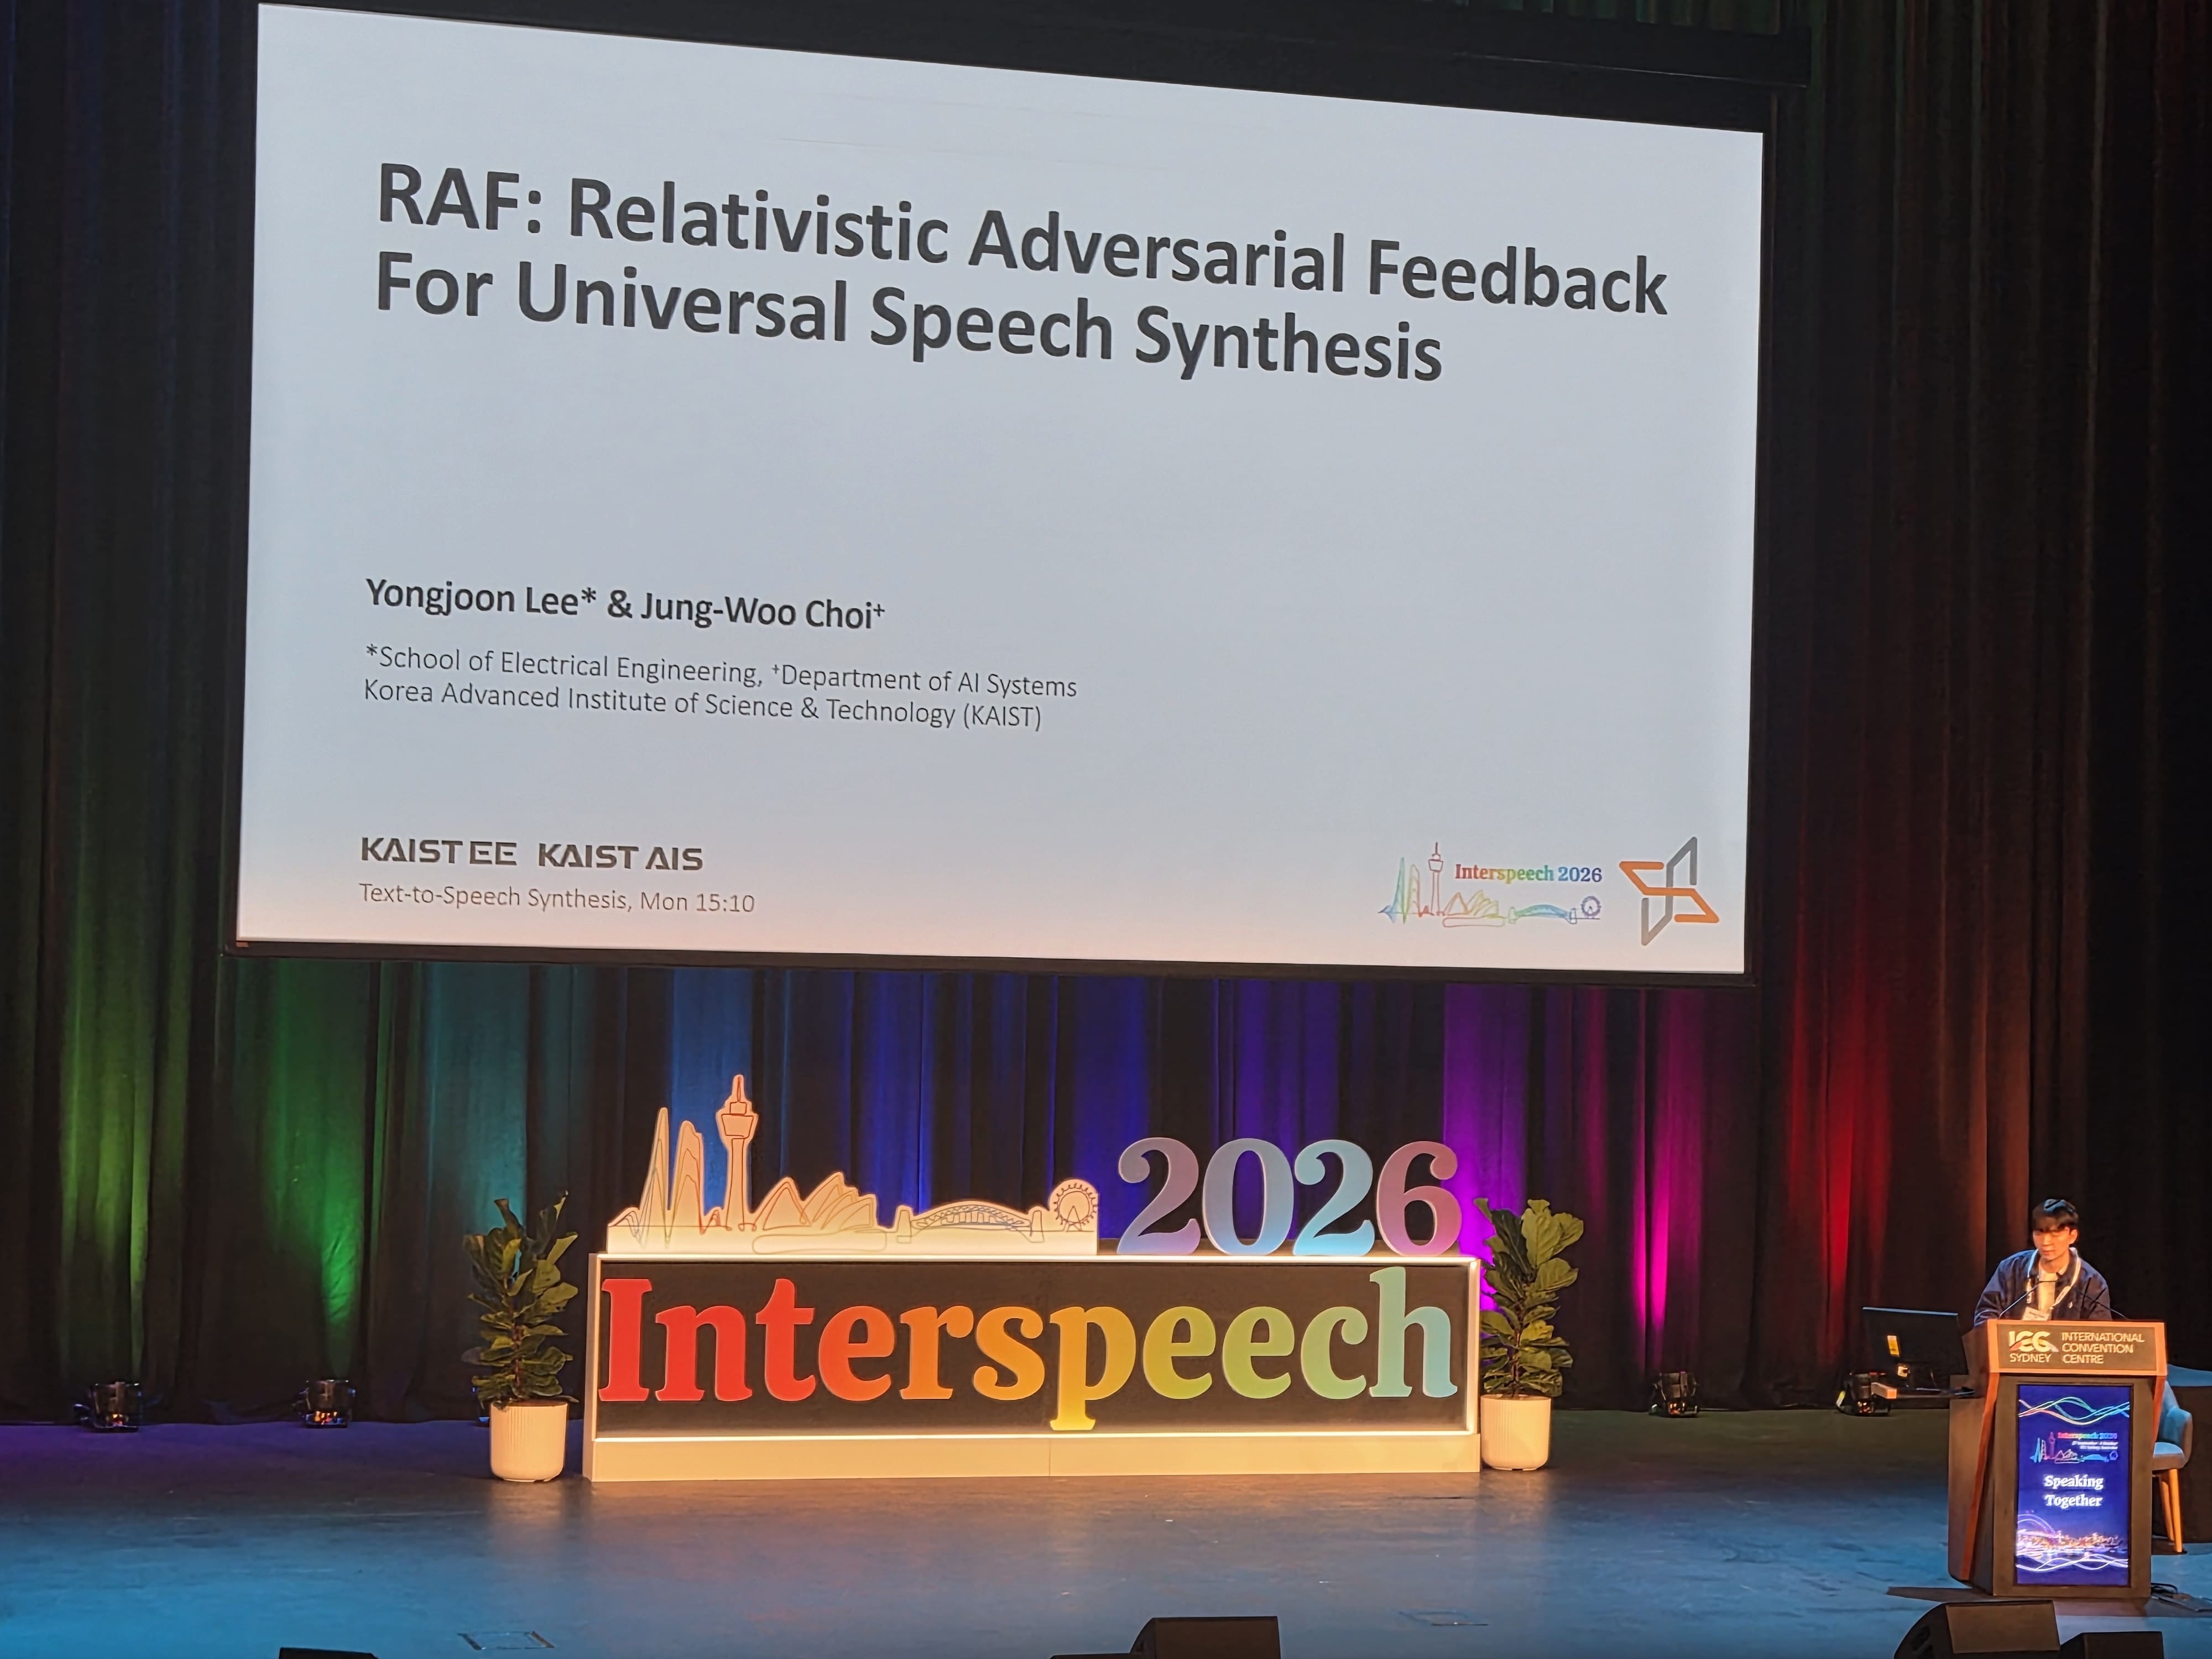
4-2. RAF: 작은 보코더의 지각 품질을 높이는 학습 목표
문제 정의: 보코더는 합성 파이프라인의 마지막 단계라, 여기서 품질이 떨어지면 앞 단계가 좋아도 들리는 음질이 낮아집니다. 최근 GAN 보코더는 구조는 발전했지만, 학습 목표가 학습하지 않은 화자·언어로의 일반화를 충분히 돕지 못한다는 문제가 있습니다.[4]
접근법: RAF(Relativistic Adversarial Feedback)는 WavLM과 HuBERT 같은 음성 자기지도학습 모델의 표현을 판별자가 활용하게 해 생성기가 더 풍부한 특징을 배우도록 합니다. 또한 실제 음성과 생성 음성을 서로 상대적으로 비교하는 적대적 학습을 적용합니다.[4]
결과: LibriTTS 평가에서 RAF로 학습한 BigVGAN-base의 UTMOS는 3.651로, 기존 LSGAN 방식으로 학습한 더 큰 BigVGAN(3.509)보다 높았습니다. 파라미터는 약 1,400만 개로 비교 모델(약 1억 1,240만 개)의 12% 수준입니다. 학습에 쓰지 않은 한국어 데이터(Deeply Korean)의 청취 평가에서도 같은 BigVGAN-base의 원음 유사도 점수(SMOS)가 3.824에서 4.324로 높아졌습니다.[4]
한계: 학습 비용이 늘어납니다. 같은 BigVGAN-base를 100만 단계 학습할 때 RAF는 9.4일, LSGAN은 5.9일이 걸렸습니다. 서비스에 쓰는 모델은 작아지지만 개발 단계의 학습 비용은 커지는 구조입니다.
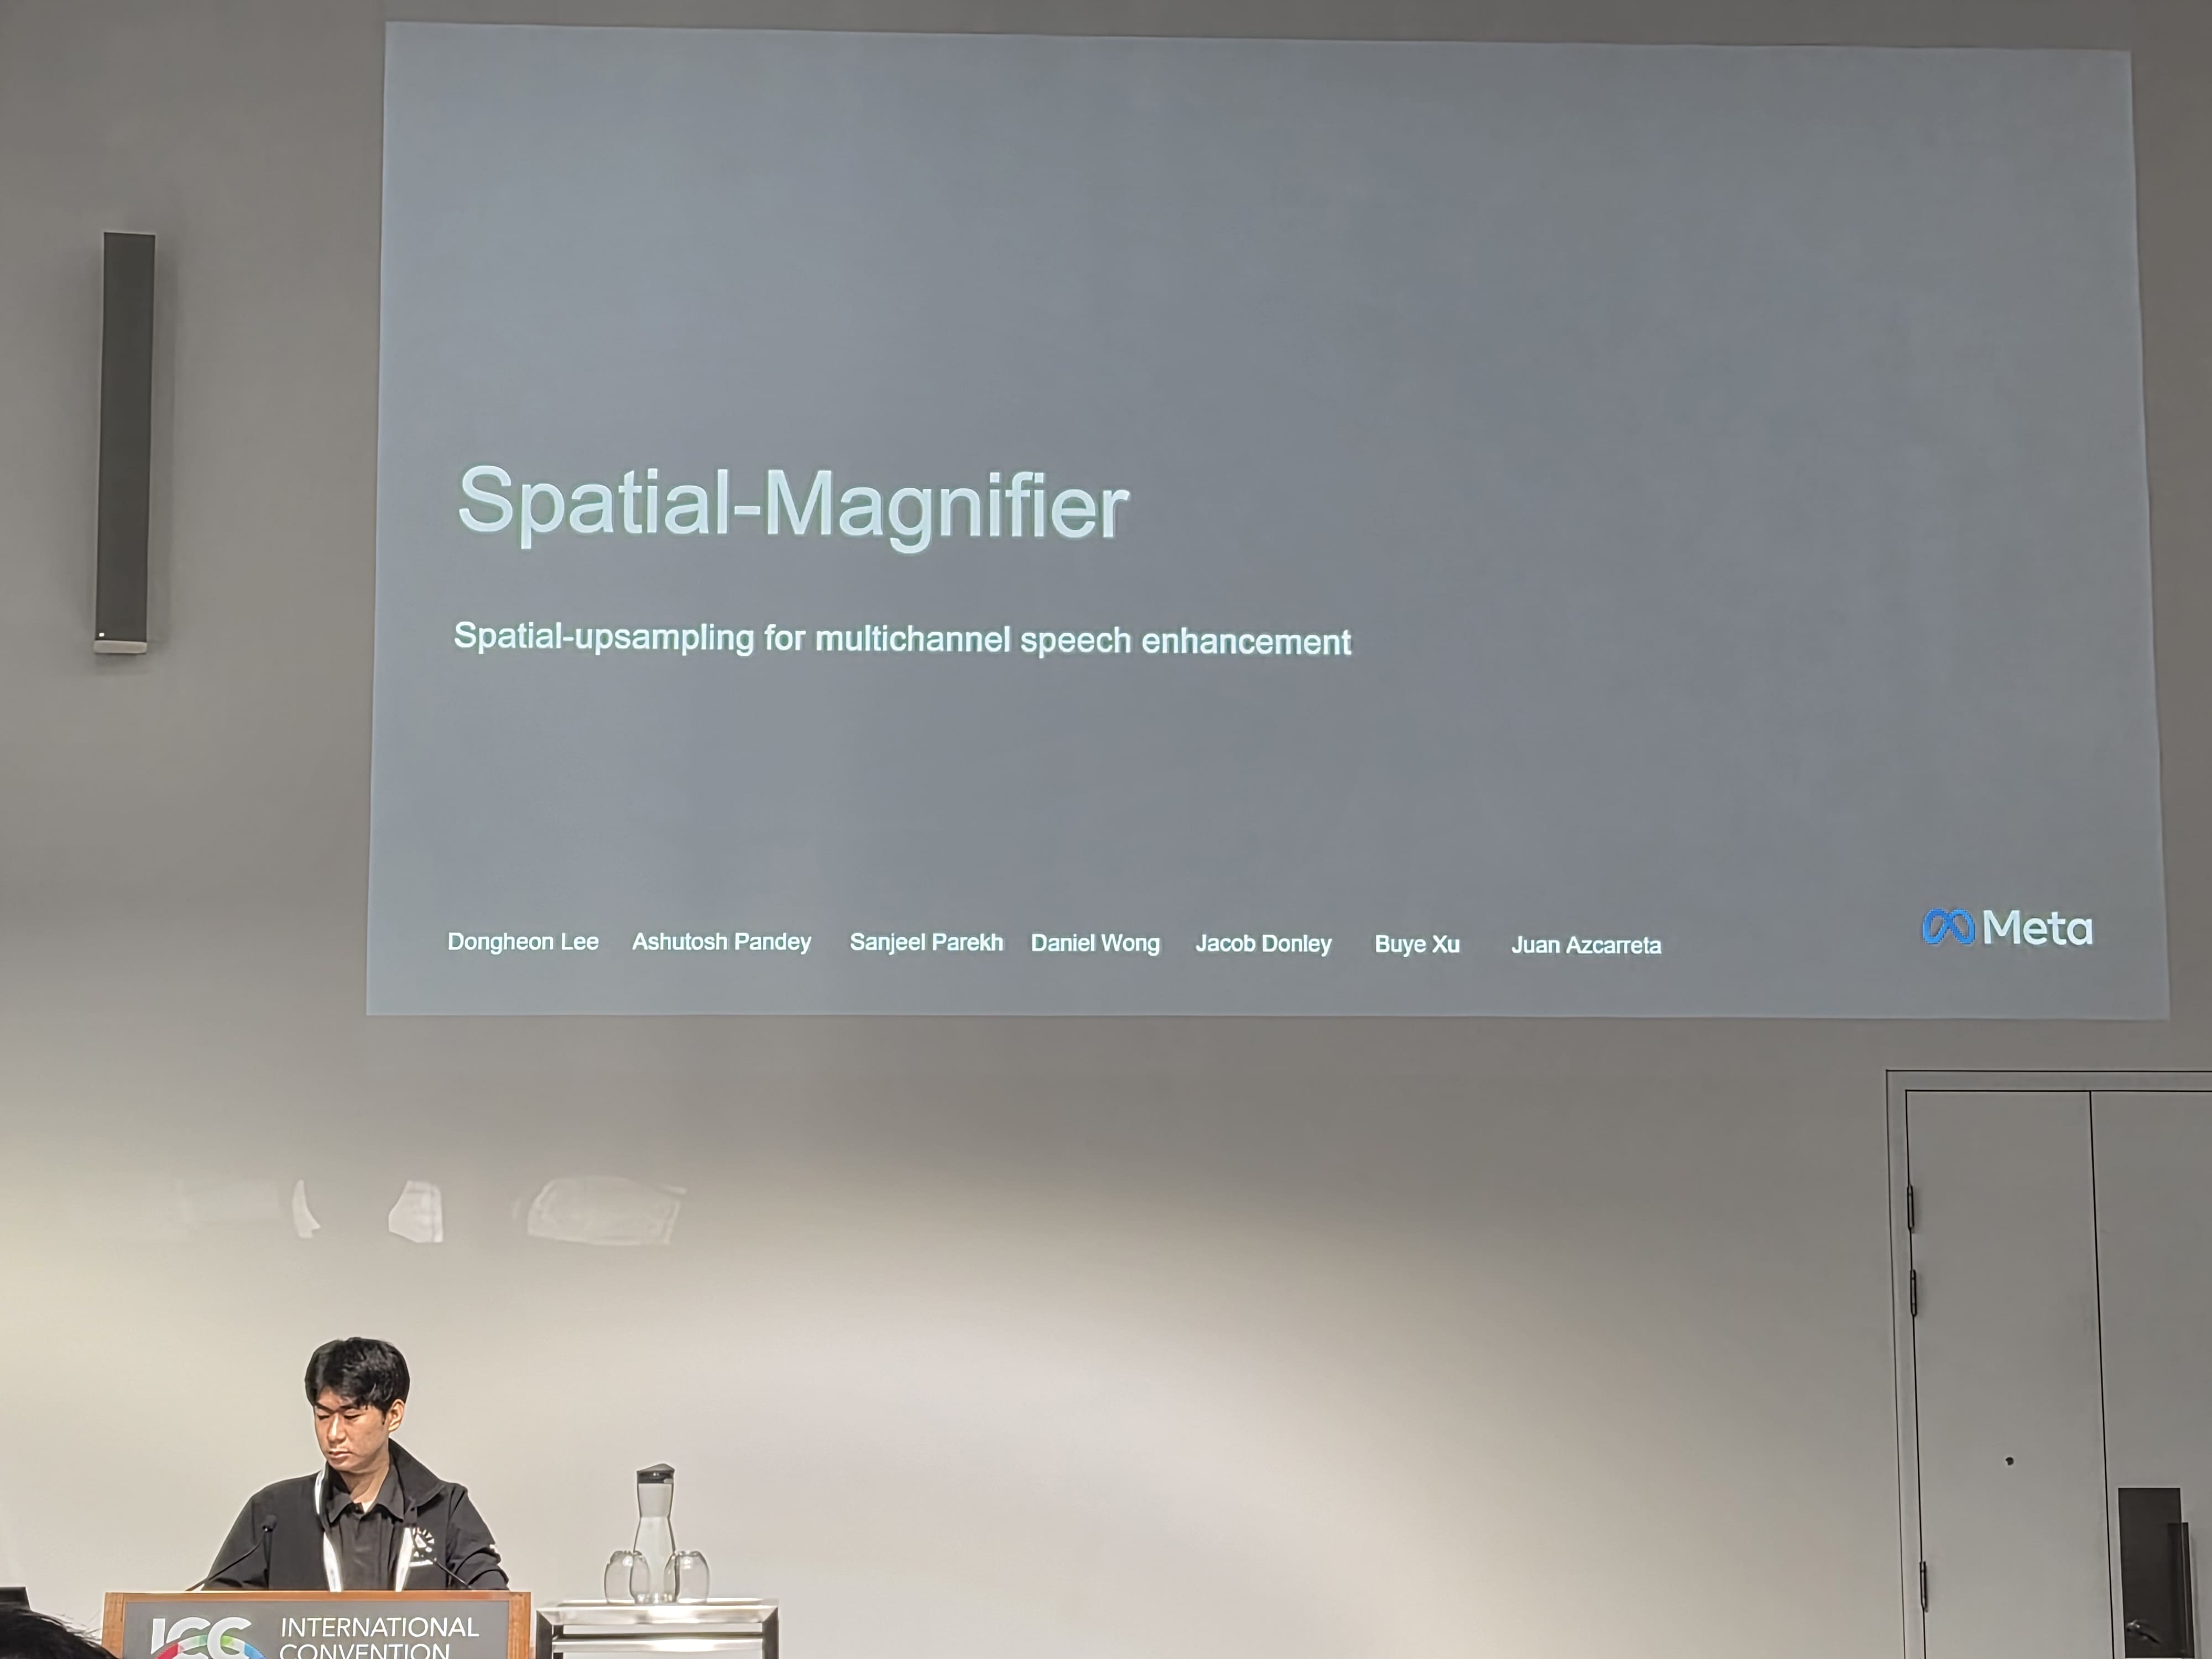
4-3. Spatial-Magnifier: 음성 향상 분야의 가상 마이크 추정
문제 정의: 마이크가 많을수록 원하는 방향의 음성을 더 잘 추출할 수 있지만, 이어버드나 AR 글래스는 크기 제약으로 마이크 수와 배치가 제한됩니다.[5]
접근법: 소수의 실제 마이크 신호로부터 가상 마이크 신호를 추정하고, SARL이라는 학습 틀로 추정한 신호나 특징을 후속 음성 향상 모델에 활용합니다. 빔포밍은 여러 채널의 신호를 조합해 원하는 방향의 음성을 강화하는 방식입니다.[5]
결과: 실제 마이크 2개와 가상 마이크 4개를 쓴 실험에서 SARL-S 방식의 빔포밍 SI-SDR은 7.10dB로, 실제 마이크 2개만 쓴 기준 모델(2.19dB)보다 크게 높았습니다. SI-SDR은 복원된 음성의 왜곡 정도를 평가하며 높을수록 좋습니다. 실제 마이크 6개를 쓴 모델(8.35dB)에는 못 미쳤지만, 하드웨어를 늘리지 않고 그 격차의 대부분을 줄였습니다.[5]
한계: 실험은 시뮬레이션한 방과 마이크 배열이 중심이었습니다. 또한 이 방식은 학습한 마이크 배치에 묶여 있어 임의의 위치에는 적용하기 어렵다고 논문도 밝히고 있습니다. 실제 기기의 움직임·잔향·잡음과 기기 내 처리 지연은 별도로 확인해야 합니다.
4-4. 연구 간 비교: 어디를 개선하고 무엇을 검증하는가
음성 합성의 세 연구는 개선하는 위치가 서로 다릅니다. ZipL-Dialog는 생성 모델이 처리하는 표현의 길이를 줄이고, FlowTTS-GRPO는 생성 결과에 대한 보상으로 음향 모델을 추가 학습하며, RAF는 마지막 파형 복원 단계의 학습 목표를 바꿉니다. 목표도 다릅니다. ZipL-Dialog와 RAF는 작은 모델과 낮은 비용을 지향하고, FlowTTS-GRPO는 추가 학습 비용을 들여 품질을 높입니다. 구조적으로 함께 검토할 수 있는 접근이지만 효과가 그대로 더해질지는 아직 확인되지 않았습니다.
Spatial-Magnifier는 다채널 음성 향상과 빔포밍이 비교 대상이므로, 이 연구의 SI-SDR을 합성 논문의 WER·화자 유사도·UTMOS와 같은 성능 순위로 묶을 수 없습니다. 각 논문의 결과는 해당 데이터와 평가 조건 안에서 해석하고, 서비스에 적용할 때 필요한 지표를 과제별로 정해야 합니다.
5. 💡 KT 관점의 시사점·마무리
5-1. 연구·서비스 적용 가능성
KT 관점에서 먼저 검토할 수 있는 것은 긴 대화형 콘텐츠와 음성 에이전트의 합성 효율입니다. ZipL-Dialog의 메모리 절감은 긴 콘텐츠를 생성하거나 여러 요청을 동시에 처리할 때 자원 부담을 줄일 가능성을 보여줍니다. 여기에 FlowTTS-GRPO의 후학습과 RAF의 보코더 학습을 더하면, 효율을 유지하면서 ZipL-Dialog에서 다소 낮아진 발음과 화자 유사도를 보완하는 후속 연구를 설계할 수 있습니다. 이는 서비스 적용을 위한 후보 방향이며, 결합 효과는 실험으로 확인해야 합니다.
Spatial-Magnifier는 소형 단말이나 잡음이 있는 환경의 음성 입력 품질을 높이는 별도의 연구 과제로 검토할 수 있습니다. 마이크를 늘리기 어려운 장치에서 가상 채널이 음성 인식이나 대화 입력 품질을 개선하는지 확인해 볼 만합니다.
5-2. 적용 전에 확인할 검증 과제
합성 분야에서는 한국어 고유명사·숫자·외래어·반복 문장, 긴 대화의 화자 전환과 목소리 유지, 청취자가 느끼는 자연스러움을 함께 평가해야 합니다. 메모리와 전체 생성 시간뿐 아니라 첫 음성이 나오는 시간, 동시 요청 수에 따른 지연, 음성 길이에 따른 실패율도 측정해야 합니다. FlowTTS-GRPO와 RAF를 적용한다면 추가 학습 비용과 실제 청취 품질의 개선 폭을 함께 비교하는 것이 중요합니다.
Yamagishi 교수님의 키노트는 음성 생성 서비스의 오남용 대응을 운영 관점에서 생각하게 했습니다. 워터마크가 압축·재녹음 후에도 유지되는지, 새로운 생성 모델도 탐지되는지, 정상 음성을 잘못 탐지하는 비율과 갱신 비용은 어느 정도인지를 함께 확인해야 합니다. Hay 교수님의 키노트에서 얻은 관점은 평가 방식과 연결됩니다. 텍스트 정확도와 자동 음질 점수에 더해, 실제 사용 맥락에서 발음과 말투가 어떻게 받아들여지는지 청취 평가로 확인해야 합니다.
5-3. 후속 공유와 마무리
후속 공유의 우선순위로는 한국어 긴 대화의 성공·실패 음성 사례, 생성 길이에 따른 메모리·지연 비교, 압축 표현·후학습·보코더 변경에 따른 품질 차이를 생각하고 있습니다. 음성 향상 연구는 실제 기기의 마이크 조건별 결과를 별도로 정리해 합성 연구와 구분해 공유하겠습니다.
이번 Interspeech에서는 ZipL-Dialog 발표와 관련 연구를 통해 합성의 효율과 품질을 함께 살펴보고, 음성 향상 논문과 두 키노트로 입력과 신뢰, 인간 지각까지 관심의 폭을 넓힐 수 있었습니다. 이번 경험을 바탕으로 긴 대화를 자연스럽고 효율적으로 생성하는 기술을 연구하고, 서비스에 필요한 평가와 운영 과제도 함께 검토하겠습니다. 읽어주셔서 감사합니다.
6. 🔗 참고자료
6-1. 논문 원문
[2] Kim, Jihwan, and Nam Soo Kim. “ZipL-Dialog: Memory-Efficient Long-Form Spoken Dialog Synthesis via Latent Flow Matching.” arXiv:2607.12496
[3] Wang, Haoxu, et al. “FlowTTS-GRPO: Online Reinforcement Learning with Multi-Objective Reward Optimization for Flow-Matching Based Text-to-Speech.” arXiv:2606.23190
[4] Lee, Yongjoon, and Jung-Woo Choi. “RAF: Relativistic Adversarial Feedback For Universal Speech Synthesis.” arXiv:2603.11678
[5] Lee, Dongheon, et al. “Spatial-Magnifier: Spatial upsampling for multichannel speech enhancement.” arXiv:2605.04749
6-2. 공식 프로그램·강연 소개
[1] Interspeech 2026 공식 웹사이트. 학회 일정 및 장소
[6] Interspeech 2026 Keynote Speakers. 키노트 발표자·강연 초록
Junichi Yamagishi, “Countermeasures Against Misuse of Speech Generative AI.”
Jen Hay, “What does it mean to ‘know a word’?”
6-3. 이미지 출처
본 기사에 있는 모든 이미지는 본인이 직접 찍은 사진입니다.