Intro.
안녕하세요. Agentic AI Lab에서 Agentic RAG 관련 기술 연구개발을 담당하고 있는 박천용, 유주원, 최혜진, 이수아, 이강민, 박국현, 박태희 입니다.
사용자가 질문에 AI가 생성한 답변을 확인하다보면, 필요했던 근거가 답변에 누락되거나 일부 조건만 반영된 답변을 생성하는 경우가 종종 발생하고는 합니다. 이러한 문제의 주요 원인 중 한 가지는 질문에 답하는 데 필요한 정보를 충분히 탐색하지 못한 채, 제한된 검색 결과만을 바탕으로 답변을 생성하기 때문입니다. 특히 실제 기업 환경에서는 수백만, 수천만 건의 정보가 여러 문서와 지식 저장소에 분산되어 있어 이러한 문제가 더욱 두드러질 수 있습니다. 이처럼 방대한 정보가 분산된 환경에서 정확한 답변을 도출하려면, 단순히 질문과 관련된 문서를 찾는 것을 넘어 어떤 정보가 필요한지 파악하고 이를 어디에서 찾아야 할지 판단하는 과정이 필요합니다. 나아가 검색 과정에서 새롭게 확인한 사실에 따라 추가로 필요한 정보나 검색 대상이 달라질 수 있기 때문에, 확보한 근거를 바탕으로 탐색 방향을 유연하게 조정하는 능력도 중요합니다.
이러한 정보 탐색 과정은 사람이 복잡한 질문에 답을 찾아가는 방식과 유사합니다.
- 필요한 정보 파악: 질문에 답하기 위해 어떤 정보를 확인해야 하는지 정리합니다.
- 검색 대상 선택: 여러 지식 저장소 중 필요한 정보가 있을 만한 곳을 판단하고 검색합니다.
- 검색 결과 검토: 검색된 문서에서 질문에 유용한 근거를 선별합니다.
- 추가 탐색 판단: 확보한 근거가 충분하지 않다면 어떤 정보가 부족한지 분석하고, 원하는 근거가 아예 발견되지 않았다면 검색 대상을 조정하여 탐색을 이어갑니다.
저희가 개발한 Agentic RAG는 이러한 사람의 정보 탐색 방식에 착안하여 질문에 필요한 정보를 계획하고, 적절한 지식소스를 선택해 검색하며, 확보한 근거를 바탕으로 추가 탐색이 필요한지 판단하는 과정을 반복합니다. 나아가 이러한 탐색 능력을 작은 모델에서도 효과적으로 구현하기 위해 Agentic Search 특화 모델 KT-Agentic-Search-v1도 개발하였고, 활성 파라미터 약 4B 규모의 Student 모델을 통해 31B Teacher 모델보다 빠른 추론 속도와 높은 성능을 달성했습니다.
이번 글에서는 Agentic RAG가 필요한 이유를 시작으로, 저희가 설계한 Agentic Search 엔진의 구조와 주요 설계 고민, 작은 모델에 검색 의사결정 과정을 학습시킨 방법, 그리고 평가 결과와 향후 개선 과제를 차례로 소개하겠습니다.
1. 왜 Agentic RAG가 필요할까?
AI가 답해야 하는 질문은 대부분 관련 문서를 찾아 내용을 요약하는 것만으로 해결되지 않는 경우가 많습니다. 예를 들어, 다음과 같은 질문을 생각해 보겠습니다.
"해외 출장 중 항공편이 취소되어 추가 숙박이 발생했다면, 숙박비를 지원받을 수 있나요? 만약에 지원 가능하다면 어떤 절차로 신청해야 하나요?"
이 질문에 정확하게 답하려면 출장비 지원 규정뿐 아니라, 항공편 취소와 같은 예외 상황에 대한 처리 기준, 추가 숙박비의 인정 조건, 비용 정산 절차까지 확인해야 할 수 있습니다. 문제는 이러한 정보가 하나의 문서에 정리되어 있지 않고, 사내 규정, 부서별 업무 지침, 비용 정산 매뉴얼 등 여러 지식 저장소에 분산되어 있을 수 있다는 점입니다.
더욱 중요한 것은 질문만 읽고 처음부터 필요한 정보를 찾기 위해 어떤 문서를 어떤 순서로 찾아야 할지 모두 알 수는 없다는 것입니다. 출장비 규정을 확인하는 과정에서 예외 상황에 적용되는 별도 지침을 발견할 수도 있고, 정산 매뉴얼을 읽은 후 추가로 확인해야 할 승인 조건이 드러날 수도 있습니다. 즉, 검색 과정에서 새롭게 확보한 정보에 따라 다음에 찾아야 할 정보가 달라질 수도 있습니다.
그러나 기존 RAG는 일반적으로 사용자 질문을 바탕으로 한 번에 관련 문서를 모두 검색하고, 검색된 내용을 근거로 답변을 생성합니다. Query Rewriting이나 Multi-hop Retrieval과 같은 기법을 통해 검색을 확장할 수도 있지만, 복잡한 기업 업무 질문에서는 미리 정해진 검색 절차만으로 다양한 상황에 대응하기 어려울 수 있습니다.
이러한 환경에서는 검색 시스템이 단순히 관련 문서를 찾아오는 역할을 넘어, 현재까지 확보한 근거를 바탕으로 무엇이 부족한지 판단하고, 다음에 어떤 정보를 어디에서 찾아야 할지 스스로 Agentic 하게 결정할 수 있어야 합니다. Agentic RAG는 이러한 문제를 해결하기 위한 접근 방식으로, 사전에 정해진 검색 절차를 따르는 대신, 질문과 검색 결과에 따라 탐색 방향을 유연하게 조정함으로써 복잡한 정보 탐색 문제에 대응하게 됩니다.
저희는 이러한 Agentic RAG의 구성 요소 중 답변에 필요한 근거를 스스로 탐색하고 확보하는 검색 과정(Retreival)에 집중했습니다. 다음 장에서는 이를 위해 개발한 Agentic Search 엔진의 구조를 소개하겠습니다.
2. Agentic Search 엔진 소개
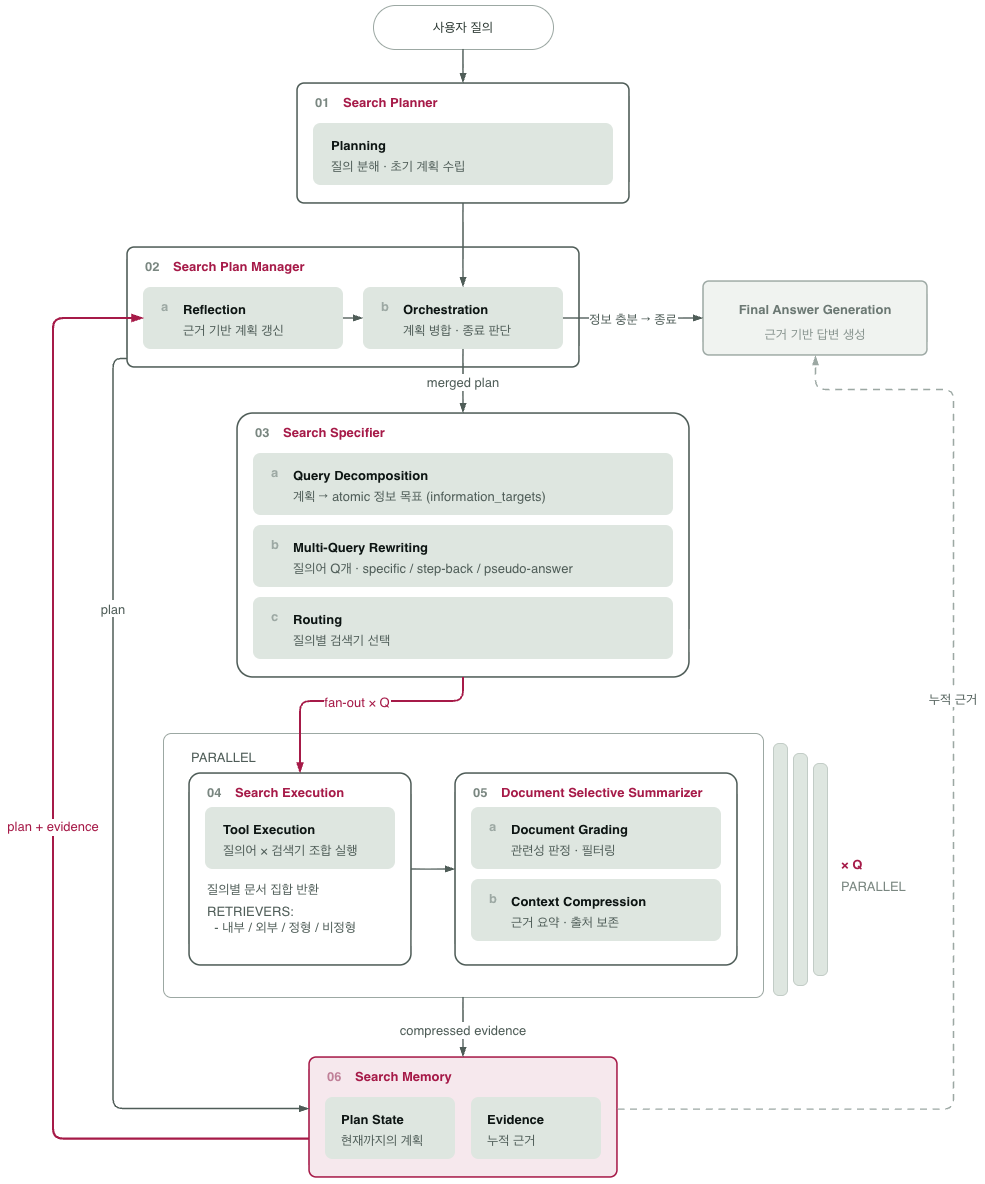
앞서 살펴본 것처럼, 복잡한 질문에 답하려면 검색 시스템이 단순히 문서를 검색하는 것을 넘어 탐색 과정 전반에서 여러 의사결정을 수행해야 합니다. 저희는 이러한 의사결정을 하나의 모델 호출에서 모두 처리하기보다는, 검색 과정에서 수행해야 할 역할을 구분하고 각 역할이 서로 협력하는 구조로 Agentic Search 엔진을 설계했습니다.
구체적으로 다음 네 가지 기능을 중심으로 검색 워크플로를 구성했습니다.
- Search Planner: 사용자 질문을 분석하여 답변에 필요한 정보와 초기 탐색 계획을 수립
- Search Plan Manager: 누적된 근거와 검색 이력을 바탕으로 계획을 조정하고 다음 행동을 결정
- Search Specifier: 검색 목표에 적합한 검색 도구와 질의를 선택하여 실행 가능한 검색 요청 생성
- Document Selective Summarizer: 검색된 문서에서 실제 답변에 필요한 근거를 선별하고 요약
그림 1. Agentic RAG 아키텍쳐
2.1. Search Planner
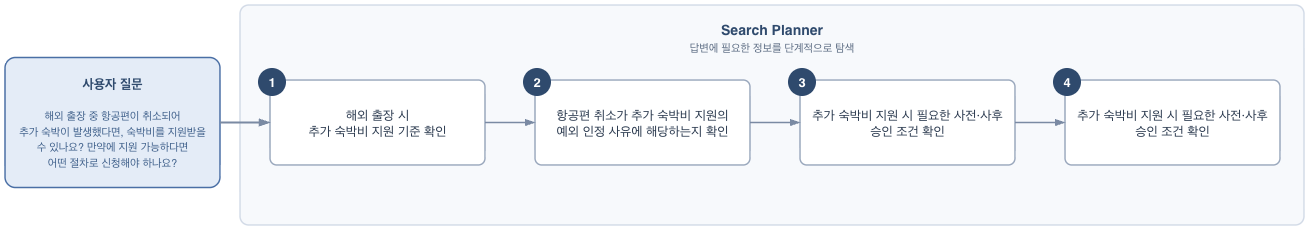
Search Planner는 사용자 질문과 대화 맥락을 분석하여 답변에 필요한 정보를 식별하고, 이를 어떤 순서로 탐색할지 초기 검색 계획을 수립합니다.
여기서 핵심은 검색어를 생성하기 전에 답변에 필요한 정보와 탐색 순서를 먼저 정의한다는 것입니다. 이러한 접근이 필요한 이유는 크게 두 가지입니다.
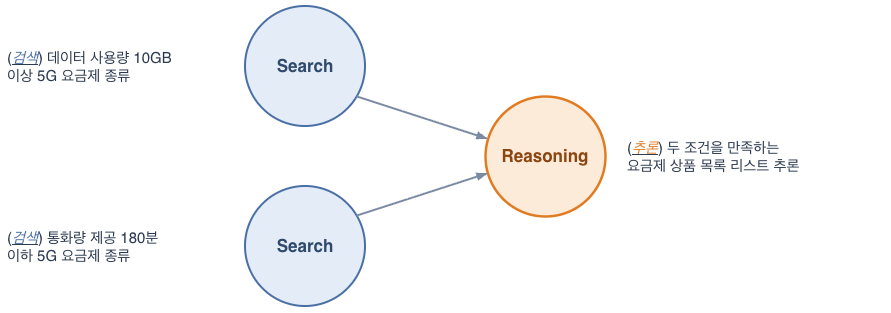
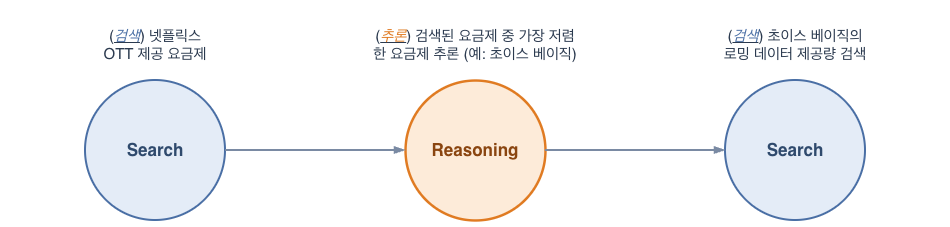
- 첫째, 정보 간의 의존관계를 고려하지 못할 수 있습니다. 복잡한 질문에서는 앞선 검색 결과를 확인해야만 다음 검색 대상을 구체화할 수 있는 경우가 있습니다. 이때 사용자 질문을 그대로 검색어로 변환하면 중간에 확인해야 할 정보를 건너뛴 채 검색을 시도하게 될 수 있습니다. 따라서 어떤 정보를 먼저 확보해야 하는지 파악하고, 정보 간 의존관계에 따라 탐색 순서를 계획해야 합니다.
- 둘째, 질문에 명시되지 않은 정보 요구사항을 놓칠 수 있습니다. 실제 사용자는 자신이 궁금한 내용을 질문할 뿐, 정확한 답변을 위해 어떤 조건이나 예외 사항을 확인해야 하는지까지 모두 명시하지는 않습니다. 이때 사용자 질문을 그대로 검색어로 변환하면 이러한 암묵적인 정보 요구사항이 검색 대상에서 제외될 수 있습니다. 따라서 사용자의 의도와 제약 조건을 분석하여 추가로 확인해야 할 정보까지 도출하는 과정이 필요합니다.
이를 위해 Search Planner는 먼저 사용자 질문의 의도와 제약 조건을 분석하고, 답변을 생성하기 위해 어떤 대상의 어떤 정보를 확인해야 하는지 구체화합니다. 이후 각 정보의 중요도와 의존관계를 고려하여 논리적인 순서로 검색 단계를 구성하게 됩니다.
예를 들어, 앞서 살펴본 해외 출장 중 추가 숙박비 지원 질문에서 사용자가 직접 요청한 것은 '숙박비 지원 가능 여부'와 '신청 절차'입니다. 하지만 정확한 답변을 위해서는 다음과 같은 정보도 추가로 확인해야 할 수 있습니다.
- 항공편 취소가 추가 숙박비 지원의 예외 인정 사유에 해당하는가?
- 추가 숙박비 지원에 별도의 승인 조건이 존재하는가?
- 비용 정산 시 어떤 증빙 서류가 필요한가?
이처럼 답변에 필요한 정보를 찾아오기 위해 검색 계획을 수립하면, 이후 검색 과정에서 어떤 정보를 확보했고 무엇이 아직 부족한지 판단할 수 있는 기준이 마련됩니다. 이를 통해 중요한 근거의 누락을 줄이고, 앞서 확보한 정보를 후속 검색에 활용할 수 있도록 했습니다.
그림 2. Search Planner 예시
2.2. Search Plan Manager
Search Plan Manager는 초기 검색 계획과 지금까지의 검색 이력, 누적된 근거를 종합하여 현재 어떤 정보를 확보했고, 무엇을 더 확인해야 하는지 판단하고 다음 행동을 결정하는 역할을 합니다.
앞서 Search Planner가 수립한 초기 계획은 실제 문서를 확인하기 전에 설정한 탐색 방향입니다. 하지만 검색 과정에서는 하나의 문서에서 예상보다 많은 정보를 얻을 수도 있고, 반대로 계획에 없던 새로운 확인 사항이 발견될 수도 있습니다. 따라서 초기 계획을 변경 없이 실행하면 이미 확보한 정보를 반복 검색하거나, 새롭게 드러난 중요한 조건을 놓칠 수 있습니다.
저희는 이러한 문제를 해결하기 위해 매 검색 단계에서 누적된 근거와 검색 이력을 검토하고, 그 결과를 바탕으로 계획을 동적으로 조정하는 Search Plan Manager를 설계했습니다. Search Plan Manager는 구체적으로 다음과 같은 판단을 수행합니다.
- 정보 확보 현황 파악: 누적된 근거를 바탕으로 답변에 필요한 정보 중 무엇을 새롭게 확보했고, 무엇이 부족한지 판단합니다.
- 검색 계획 조정: 이미 확보한 정보에 대한 검색 단계는 생략하고, 새롭게 확인해야 할 정보가 발견되면 단계를 추가하거나 기존 단계의 순서를 조정합니다.
- 다음 검색 단계 결정: 검색 단계 간 의존관계와 이전 검색의 성공·실패 이력을 고려하여 다음에 수행할 검색 작업을 결정합니다.
- 검색 종료 여부 판단: 현재까지 확보한 근거만으로 답변이 가능하다 판단되면 검색을 종료하고 답변 생성 단계로 전환합니다.
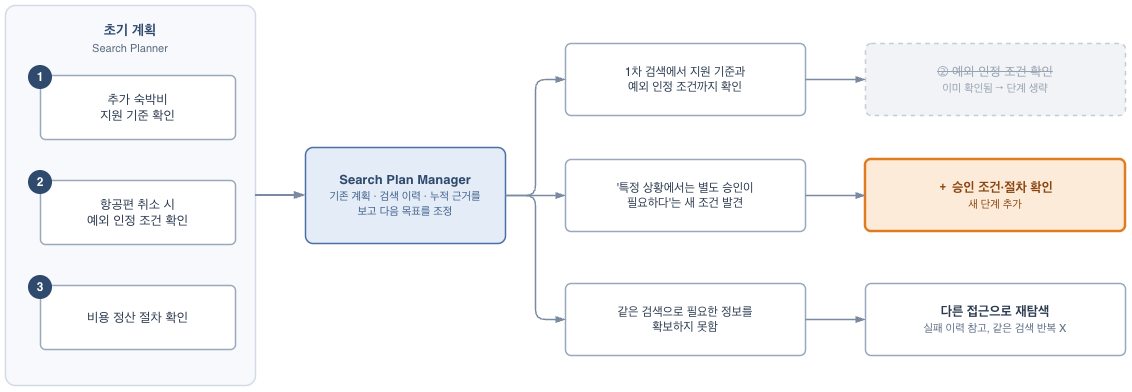
예를 들어, Search Planner가 해외 출장 중 추가 숙박비 지원 질문에 대해 다음과 같은 초기 계획을 수립했다고 가정해 보겠습니다.
추가 숙박비 지원 기준 확인 → 항공편 취소 시 예외 인정 조건 확인 → 비용 정산 절차 확인
만약 첫 번째 검색에서 찾은 문서에서 숙박비 지원 기준’뿐 아니라 ‘항공편 취소에 대한 예외 인정 조건’까지 확인되었다면, 두 번째 검색 단계를 별도로 수행할 필요가 없습니다. 반대로 검색된 문서 내 '특정 상황에서는 별도 승인이 필요하다'는 새로운 조건이 발견되었다면, 해당 승인 요건을 확인하는 단계를 추가할 수 있습니다. 또한 검색에 실패했다면 동일한 검색을 지속적으로 반복하기보다, 이전에 어떤 방식으로 검색을 시도했고 어떤 정보를 확보하지 못했는지를 고려하여 다음 탐색 방향을 조정합니다.
이처럼 Search Plan Manager는 초기 계획을 그대로 실행하는 대신, 검색 과정에서 새롭게 확보한 정보와 이전 검색 결과를 바탕으로 계획을 지속적으로 보완합니다. 이를 통해 불필요한 검색을 줄이는 동시에, 답변에 필요한 핵심 근거가 누락되지 않도록 탐색 과정을 설계했습니다.
그림 3. Search Plan Manager 예시
2.3. Search Specifier
Search Specifier는 매 Search Plan Manager 가 조정한 검색 목표를 실제 검색 도구가 수행할 수 있는 구체적인 검색 요청으로 변환하는 역할을 합니다.
여기서 핵심은 무엇을 찾아야 하는지 정의하는 것과 실제로 해당 정보를 효과적으로 검색하는 것은 별개의 문제라는 점입니다. 동일한 정보라도 서로 다른 지식 저장소에 존재할 수 있고, 문서마다 해당 정보를 표현하는 방식도 다르기 때문입니다. 따라서 검색 목표를 단일 검색어로 변환하거나 하나의 검색 도구만 사용하는 방식으로는 필요한 근거를 충분히 확보하지 못할 수 있습니다.
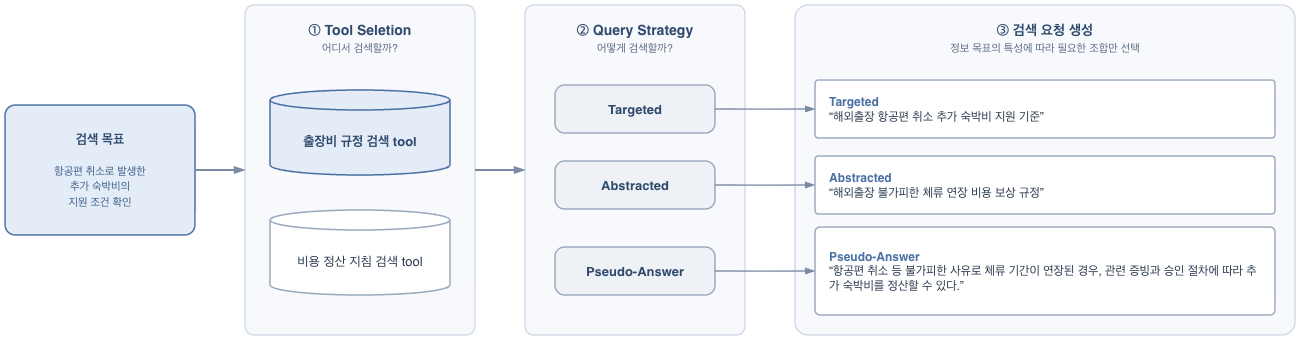
저희는 이러한 문제를 해결하기 위해 검색 목표를 구체적인 정보 단위로 분해하고, 어디에서 검색할지와 어떻게 검색할지를 독립적으로 결정하는 방식으로 Search Specifier를 설계했습니다. 구체적으로 먼저 검색 목표를 한 번의 검색으로 확인할 수 있는 원자적 정보 목표(Atomic Information Target)로 분해합니다. 이후 각 정보 목표에 대해 다음 두 가지를 결정합니다.
- Tool Selection — 어디에서 검색할 것인가?: 정보의 특성과 사용 가능한 검색 도구를 고려하여 적절한 도구를 선택합니다.
- Query Strategy — 어떻게 검색할 것인가?: 정보 목표의 특성을 분석하여 적절한 검색 표현을 선택하고 검색 질의를 생성합니다.
특히 Query Strategy에서는 하나의 검색 목표에 대해 다음 세 가지 질의 유형을 선택적으로 활용하도록 했습니다.
질의 유형
|
설명
|
Targeted
|
검색 대상과 확인할 속성, 제약 조건을 조합하여 구체적인 정보를 직접 찾는 정밀 검색 질의
|
| Abstracted
|
구체적인 검색 목표에서 한 단계 추상화하여 관련 상위 개념이나 배경 지식을 탐색하는 질의
|
| Pseudo-Answer
|
실제 문서에 포함되어 있을 법한 가상의 답변을 생성하여 의미적으로 유사한 문서를 찾는 질의
|
여기서 중요한 점은 모든 정보 목표에 세 가지 질의를 무조건 생성하지 않는다는 것입니다. 단순한 사실 조회에는 Targeted 질의만으로 충분할 수 있지만, 검색 목표와 실제 문서 사이에 표현 차이가 크거나 관련 개념을 함께 탐색해야 하는 경우에는 Abstracted 또는 Pseudo-Answer 질의가 추가로 필요할 수 있습니다. 반대로 모든 질의 유형을 무조건 적용하면 불필요한 검색 결과가 증가하고 검색 비용도 커질 수 있습니다. 따라서 정보 목표의 특성에 따라 필요한 질의 전략만 선택적으로 활용하도록 했습니다.
예를 들어, 앞서 살펴본 해외 출장 중 추가 숙박비 지원 질문에서 현재 검색 목표가 '항공편 취소로 인한 추가 숙박비 인정 조건 확인'이라고 가정해 보겠습니다. Search Specifier는 해당 목표에 대해 출장비 관련 규정이나 예외 처리 지침을 검색 대상으로 선택하고, 다음과 같이 서로 다른 유형의 질의를 생성할 수 있습니다.
- Targeted: "해외출장 항공편 취소 추가 숙박비 지원 기준"
- Abstracted: "해외출장 불가피한 체류 연장 비용 보상 규정"
- Pseudo-Answer: "항공편 취소 등 불가피한 사유로 체류 기간이 연장된 경우, 관련 증빙과 승인 절차에 따라 추가 숙박비를 정산할 수 있다."
이처럼 Search Specifier는 검색 목표 자체는 유지하면서도 정보의 특성에 따라 검색 대상과 질의 표현을 유연하게 선택하도록 설계했습니다. 이를 통해 단일 검색 방식의 한계를 보완하고, 불필요한 검색 요청을 늘리지 않으면서 필요한 근거를 효과적으로 탐색하고자 했습니다.
그림 4. Search Specifier 예시
2.4. Document Selective Summarizer
Document Selective Summarizer(DSS)는 검색된 문서를 검토하여 사용자 질문에 답하는 데 필요한 근거를 선별하고, 핵심 정보를 요약하는 역할을 담당합니다.
여기서 핵심은 검색된 모든 문서를 요약하는 것이 아니라, 실제로 답변에 기여할 수 있는 근거가 포함된 문서만 선택적으로 요약한다는 것입니다. 검색 결과에서 높은 순위에 노출되거나 질문과 유사한 키워드를 포함하고 있더라도, 반드시 답변에 필요한 정보를 담고 있는 것은 아닙니다. 특히 Agentic Search에서는 검색이 반복되면서 다양한 문서가 누적되므로, 관련성이 낮은 정보까지 모두 보존하면 이후 검색 계획을 결정할 때 불필요한 정보가 많아질 수 있습니다. 반대로 문서의 내용을 지나치게 압축하면 답변에 필요한 조건이나 예외 사항이 누락되어, 이후 검색 단계에서 이미 확보한 정보를 다시 찾거나 불완전한 근거를 바탕으로 판단하는 문제가 발생할 수 있습니다.
저희는 이러한 문제를 해결하기 위해 문서의 유용성을 먼저 평가하고, 답변에 필요한 근거가 포함된 문서에 대해서만 핵심 정보를 보존하며 요약하는 방식으로 DSS를 설계했습니다. 구체적으로 DSS는 다음 두 가지 작업을 수행합니다.
- 근거 유용성 판단: 현재 검색 목표 및 사용자 원질의를 기준으로, 문서 내 답변에 직접적으로 필요한 근거를 제공하는지 판단합니다. 단순히 검색어와 유사한 표현이 포함되어 있거나 배경 정보만 제공하는 문서는 제외합니다.
- 핵심 근거 선별 및 요약: 유용한 근거가 포함된 문서에 한해 조건, 수치, 예외 사항, 절차 등 답변에 필요한 핵심 정보를 선별하여 요약합니다.
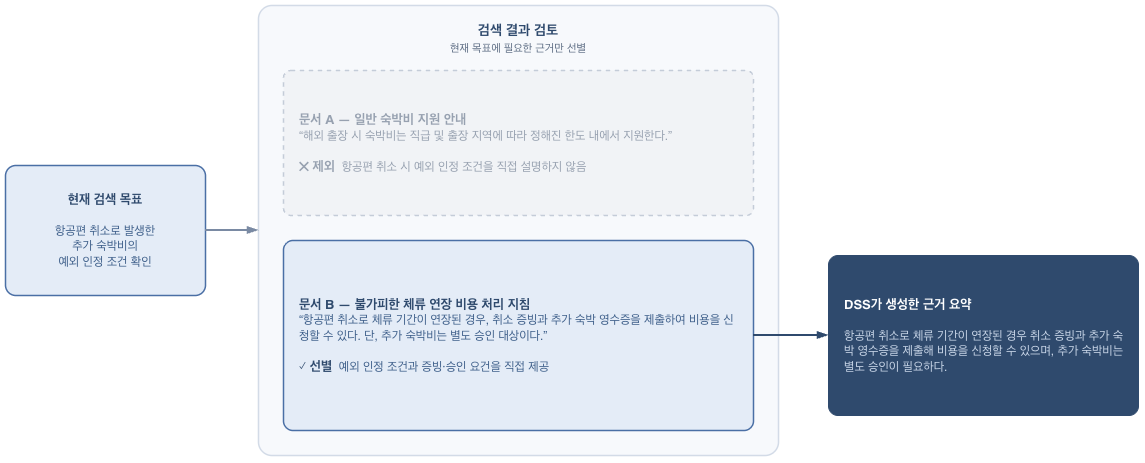
예를 들어, 앞서 살펴본 해외 출장 중 추가 숙박비 지원 질문에서 다음 두 문서가 검색되었다고 가정해 보겠습니다.
- 문서 A: 일반적인 해외 출장 숙박비 지원 한도를 설명하는 문서
- 문서 B: 항공편 취소로 인한 추가 숙박비 인정 조건을 설명하는 문서
현재 검색 목표가 '항공편 취소에 따른 추가 숙박비 예외 인정 조건 확인'이라면, 두 문서 모두 숙박비와 관련된 내용을 포함하고 있더라도 실제 검색 목표에 대한 유용성은 다릅니다. DSS는 단순히 숙박비라는 키워드가 포함되어 있다는 이유로 문서 A를 선택하지 않고, 현재 검색 목표에 필요한 예외 인정 조건을 직접적으로 제공하는 문서 B를 선별합니다. 이후 문서 B에 포함된 인정 조건과 승인 요건, 증빙 서류 등 답변에 필요한 정보를 누락하지 않도록 요약합니다.
이처럼 DSS는 검색된 문서에서 답변에 필요한 근거를 선별하고, 후속 검색 과정에서 활용할 수 있도록 핵심 정보를 보존하는 역할을 수행합니다. 이를 통해 불필요한 정보의 누적을 줄이는 동시에, 이후 검색 단계에서 현재까지 확보한 정보와 추가로 확인해야 할 정보를 판단하는 데 필요한 근거를 제공하도록 설계했습니다.
그림 5. Document Selective Summarizer예시
3. Agentic Search 특화 모델 개발
앞서 소개한 Agentic Search 엔진은 검색 결과를 바탕으로 다음 탐색 방향을 동적으로 결정하고, 여러 검색 단계에서 확보한 정보 중 유용한 근거를 선별·종합하는 등 복합적인 의사결정을 수행해야 합니다. 이러한 과정에서는 높은 추론 능력이 요구되므로 대규모 LLM에 대한 의존도가 높아질 수 있습니다. 하지만 Agentic Search는 검색 계획 수립, 검색 요청 생성, 문서 검토, 계획 조정 등 여러 단계에서 LLM을 반복적으로 호출하는 구조이기도 합니다. 따라서 대규모 모델을 사용할 경우 검색 단계가 늘어날수록 응답 지연 시간과 실행 비용이 누적되는 문제가 발생합니다.
실제로 저희가 운영한 Agentic Search 엔진 역시 이러한 한계를 그대로 안고 있었습니다. 각 단계의 판단을 범용 대규모 모델에 의존하다 보니 한 번의 질의를 처리하는 데 걸리는 시간이 길었고, 검색 계획 수립 방식, 도구 사용 규칙, 근거 선별 기준, 출력 형식 등 탐색에 필요한 지침을 매 호출마다 긴 추론 프롬프트로 전달해야 했기 때문에 입력 토큰 사용량과 지연 시간이 더욱 커지는 구조였습니다. 즉, 모델이 수행해야 할 탐색 전략의 상당 부분이 모델 자체가 아니라 프롬프트에 담겨 있었던 셈입니다.
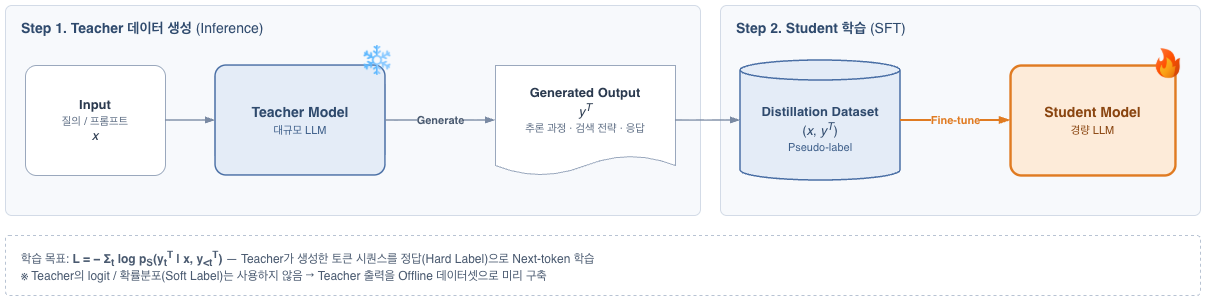
저희는 이러한 문제를 해결하기 위해 프롬프트로 매번 지시하던 탐색 전략과 대규모 모델의 검색 의사결정 능력을 경량 모델에 내재화하여, 검색 성능은 보존하면서 추론 효율성을 높이는 Agentic Search 특화 모델을 개발하고자 했습니다. 탐색 지침이 모델 안에 학습되어 있으면 긴 프롬프트 없이도 동일한 수준의 의사결정이 가능해지고, 경량 모델을 사용함으로써 호출당 추론 비용과 지연 시간도 함께 줄일 수 있기 때문입니다. 이를 위해 Teacher 모델(Gemma-31B-it)이 수행하는 검색 계획 수립, 도구 선택, 근거 선별, 다음 행동 결정 등의 탐색 과정을 활성 파라미터 약 4B 규모의 MoE 기반 Student 모델(Gemma-4-26B-A4B-it)에 학습시키는 방식을 선택했습니다. 단순히 최종 정답을 학습하는 것이 아니라, Teacher 모델이 정답 근거를 확보하기까지 수행한 검색 행동과 의사결정 과정(Trajectory)을 학습하도록 하는 것이 핵심이었습니다.
전체 모델 개발 과정은 크게 두 단계로 구성했습니다. 먼저 다양한 검색 상황을 포함하는 질의를 확보하고, Teacher 모델이 실제 Agentic Search 엔진을 수행하며 생성한 Trajectory 중 학습에 적합한 데이터를 선별했습니다. 이후 선별된 데이터를 활용해 Student 모델에 Teacher의 검색 의사결정 과정을 Distillation하여 Agentic Search 특화 모델을 개발했습니다.
그림 6. Agentic Search 학습 Overall Flow
이하에서는 이러한 개발 과정에 따라 Agentic Search 학습 데이터셋을 구축한 방법과 Teacher의 검색 행동을 Student 모델에 학습시킨 방법을 차례로 소개하겠습니다.
3.1. Agentic Search 학습 데이터셋 구축
Agentic Search에 특화된 모델을 학습시키기 위해서는 다양한 정보 탐색 상황을 포함하는 질문과, 해당 질문을 해결하기 위해 수행해야 하는 검색 ‘과정(Trajectory)’에 대한 데이터가 필요합니다. 일반적인 질문-문서-정답(QA) 형태의 데이터는 최종 답변에 필요한 정보를 제공하지만, 어떤 정보를 먼저 검색해야 하는지, 적절한 검색 도구는 무엇인지, 검색 결과에 따라 다음 행동을 어떻게 결정해야 하는지와 같은 탐색 과정은 충분히 포함하지 않습니다. 따라서 저희는 다양한 검색 상황이 필요로 하는 질의를 확보하고, Teacher 모델이 실제 Agentic Search 엔진을 수행하면서 생성한 Trajectory를 학습 데이터로 활용하는 방식을 선택했습니다.
전체 학습 데이터 구축 과정은 크게 다음 네 단계로 구성됩니다.
- 학습 데이터 수집: 다양한 정보 탐색 상황을 포함하는 QA 벤치마크와 문서 코퍼스를 확보합니다.
- 합성 데이터 생성: 수집한 데이터를 바탕으로 여러 단계의 검색이나 정보 통합이 필요한 복합 질의를 추가로 생성합니다.
- Trajectory 생성: Teacher 모델이 실제 Agentic Search 엔진을 수행하며 생성한 검색 계획, 도구 호출, 검색 결과에 따른 의사결정 과정을 기록합니다.
- 학습 데이터 선별: 생성된 Trajectory 중 최종 검색 결과에서 정답 근거 문서를 확보한 사례를 선별하여 학습 데이터셋을 구성합니다.
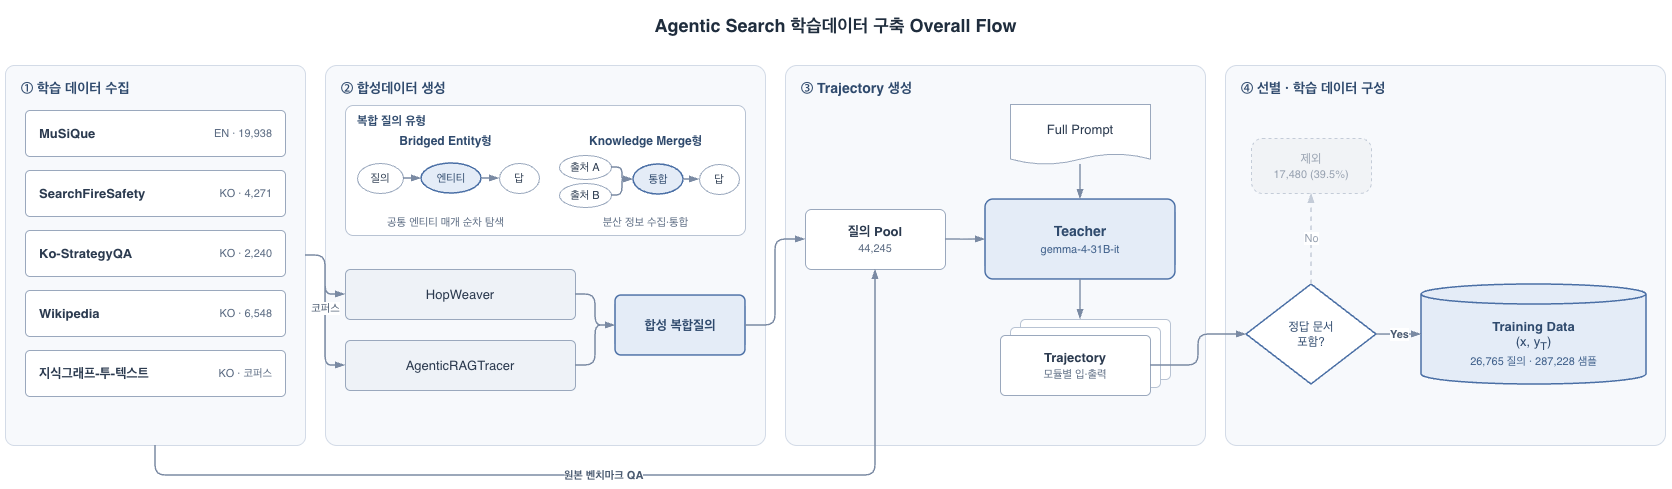 그림 7. Agentic Search 학습 데이터 구축 파이프라인
3.1.1. 학습 데이터 수집
Agentic Search 모델을 학습시키기 위해서는 단순히 많은 질문과 정답을 확보하는 것보다, 실제로 학습시키고자 하는 검색 행동을 유도할 수 있는 데이터를 확보하는 것이 중요합니다. 예를 들어, 하나의 문서에서 정답을 바로 찾을 수 있는 질문만으로는 앞선 검색 결과를 바탕으로 다음 검색 대상을 결정하는 능력을 충분히 학습시키기 어렵습니다. 또한 하나의 지식소스만 활용하는 데이터로는 여러 검색 도구 중 적절한 도구를 선택하고 조합하는 상황을 다양하게 구성하기 어렵습니다.
저희는 이러한 점을 고려하여 학습 데이터 수집 시 다음 두 가지 기준을 중점적으로 검토했습니다.
- Multi-hop 질의 포함 여부: 여러 단계의 정보 탐색을 통해 정답에 도달해야 하는 질의를 포함하는지 검토했습니다. 특히 앞선 검색에서 확보한 정보를 다음 검색의 단서로 활용하는 등, 검색 단계 간 의존관계를 학습할 수 있는 데이터를 고려했습니다.
- 다중 지식소스 활용 가능 여부: 하나의 질문을 해결하기 위해 서로 다른 지식소스와 검색 도구를 활용하는 시나리오를 구성할 수 있는지 검토했습니다. 이를 위해 다양한 도메인의 문서 코퍼스가 제공되는지, 문서를 여러 검색 대상으로 구성하여 적절한 도구를 선택하고 활용하는 학습 환경을 만들 수 있는지 고려했습니다.
이러한 기준을 바탕으로 MuSiQue[1], SearchFireSafety[2], Ko-StrategyQA[3], Wikipedia[4], 지식그래프-투-텍스트 데이터[5] 데이터를 확보하여 다양한 검색 행동을 학습할 수 있는 질의 및 검색 환경을 구성하는 데 활용했습니다.
3.1.2. 합성데이터 생성
앞서 수집한 데이터셋만으로는 Agentic Search 모델의 탐색 능력을 충분히 학습시키기 위한 데이터의 양과 다양성을 확보하는 데 한계가 있다고 판단하여 저희는 합성 데이터를 통해 다양한 복합 질의를 추가로 생성하고자 했습니다. 이때 중요하게 고려한 것은 단순히 질문의 길이나 복잡도를 높이는 것이 아니라, 정답을 도출하기 위해 실제로 여러 정보를 탐색하고 연결해야 하는 질의를 구성하는 것이었습니다. 이를 위해 개별 사실을 묻는 단일 질의를 먼저 생성하고, 각 질의가 다루는 정보 간 관계를 연결하거나 결합하여 아래와 같이 두 가지 유형의 복합 질의 생성하였습니다.
질의 유형
|
특징
|
| Knowledge Merge형 질의
|
여러 문서에 분산된 독립적인 정보를 수집·통합
|
| Bridge Entity형 질의
|
공통 개체(Entity)를 매개로 서로 다른 문서의 정보를 연결
|
즉, 두 유형은 각각 정보 간 의존관계를 따라 순차적으로 탐색하는 능력과 독립적인 정보를 수집해 종합하는 능력을 학습하기 위한 것으로, 이러한 복합 질의를 생성하기 위해 HopWeaver와 AgenticRAGTracer 두 가지 방법을 활용했습니다.
① HopWeaver
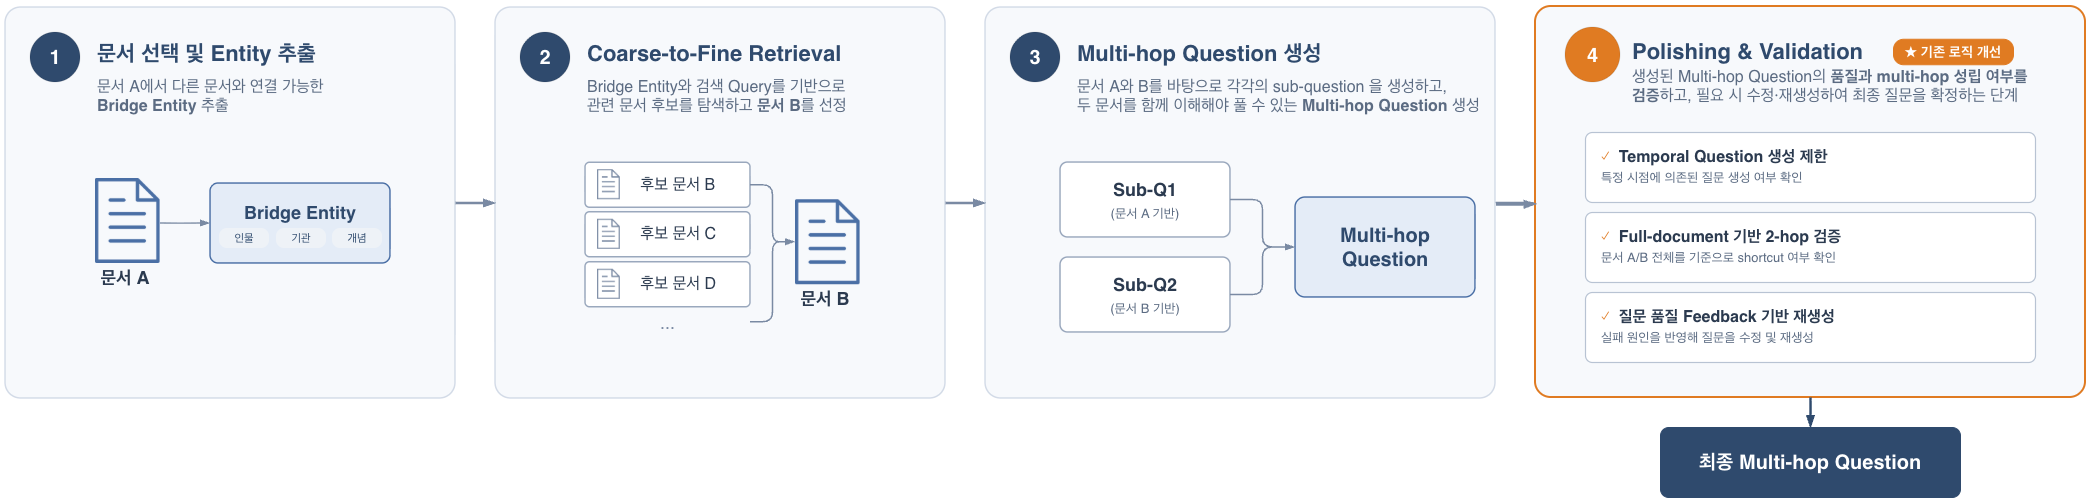
HopWeaver[6]는 한 문서에서 연결 단서가 되는 개체(Entity)를 찾고, 이를 통해 다른 문서와 연결하여 두 문서의 정보를 함께 활용해야 답할 수 있는 2-hop 질의(Knowledge Merge 형 질의)를 생성하는 방법입니다. 다만 기존 방법론을 그대로 차용하여 합성 질의를 생성할 시 형식적으로 두 문서를 연결해 만든 질문이라도 실제로는 하나의 문서만으로 정답을 찾을 수 있다는 문제가 발견되었습니다.
예를 들어 다음과 같은 두 문서가 있다고 가정해 보겠습니다.
- 문서 A: "연구자 X는 연구소 Y에서 근무했다."
- 문서 B: "연구소 Y는 1998년에 설립되었다."
이 두 문서를 연결하면 "연구자 X가 근무한 연구소는 언제 설립되었는가?"라는 질문을 생성할 수 있습니다. 이 경우 문서 A에서 연구소 Y를 확인하고, 문서 B에서 설립 연도를 찾아야 하므로 정상적인 2-hop 질의입니다. 하지만 문서 A에 연구소 Y의 설립 연도까지 포함되어 있다면 문서 B를 확인하지 않아도 정답을 찾을 수 있습니다. 이처럼 실제로는 여러 문서의 탐색이 필요하지 않은 질문을 Shortcut 질의라고 합니다.
이러한 데이터를 학습에 활용하면 모델이 검색 결과를 다음 검색의 단서로 활용하는 과정을 학습하도록 의도했던 목적이 약해질 수 있습니다. 저희는 이를 방지하기 위해 합성 질의가 실제로 두 문서의 정보를 모두 필요로 하는지 검증하지를 포함하여 전반적인 Polishing & Validation 과정을 고도화했습니다. 구체적으로 다음 세 가지를 개선했습니다.
- 문서 기반 2-hop 검증: 두 문서에 필요한 정보가 실제로 분산되어 있는지, 하나의 문서만으로 최종 정답을 찾을 수 있는지, 하위 질문의 정답이 중복되는지 확인하여 Shortcut 질의를 제외했습니다.
- 시간 의존성 관리: '현재', '최근'과 같이 기준 시점에 따라 정답이 달라질 수 있는 질문의 생성을 제한했습니다. 대신 창업자, 출생지, 완료된 사건 등 비교적 안정적인 사실 관계를 우선 활용하여 시간에 따른 정답의 불일치 가능성을 줄이고자 했습니다.
- Feedback 기반 질문 재생성: 검증에 실패한 질문을 무조건 폐기하기보다 실패 원인을 생성 프롬프트에 반영했습니다. 예를 들어 첫 번째 하위 질문이 두 번째 문서만으로도 답변 가능한 경우, 첫 번째 문서에만 존재하는 정보를 활용하도록 질문을 수정했습니다. 이를 통해 기존 문서 조합을 재활용하면서 불필요한 문서 재탐색을 줄이고자 했습니다.
그림 8. HopWeaver 방법론
② AgenticRAGTracer
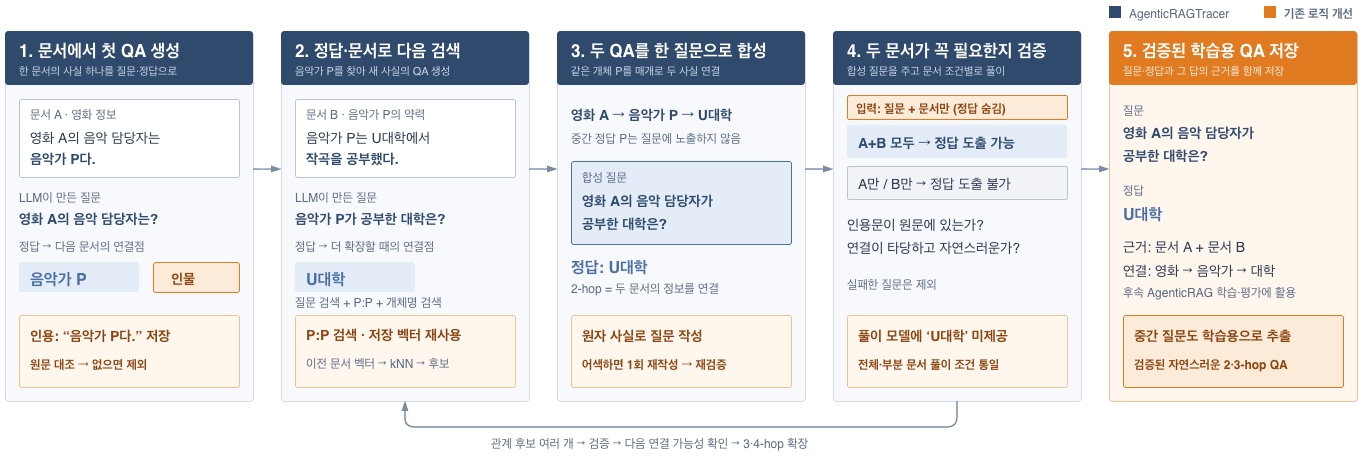
AgenticRAGTracer[7]는 2-hop을 넘어 여러 문서에 걸친 복잡한 정보 연결 관계를 요구하는 질의(Bridge 형 질의) 를 생성하는 데 활용했습니다.
다만 탐색 경로가 길어질수록 두 가지 문제가 발생할 수 있습니다. (1) 먼저 다음 단계로 연결하기 위한 근거 문서를 찾기 어려워지고, 탐색 경로를 확장하는 과정에서 서로 관련이 없는 정보를 잘못 연결할 가능성도 높아집니다. (2) 또한 여러 문서를 활용해 질문을 생성하더라도, 실제로는 일부 문서만으로 정답을 찾을 수 있는 Shortcut 문제가 발생할 수 있습니다.
따라서 저희는 더 다양한 문서 연결 경로를 확보하면서도, 각 연결 관계가 타당하고 실제 정답 도출에 필요한지 검증하는 방향으로 다음과 같이 AgenticRAGTracer를 고도화했습니다
- 검색 후보 확장: 기존의 질문 및 개체명 기반 검색에 문서 벡터 기반 kNN 검색을 추가했습니다. 이를 통해 키워드가 직접 일치하지 않더라도 문맥적으로 관련된 문서를 연결 후보로 탐색할 수 있도록 했습니다. 또한 문서별로 최대 3개의 관계 후보를 생성하고, 후속 연결 가능성에 따라 우선순위를 결정하여 탐색 경로를 확장했습니다.
- 근거 및 연결 관계 검증: 문서 간 정보를 연결할 때 개체 유형과 원문 근거를 함께 확인했습니다. 특히 서로 다른 이름으로 표현된 개체를 연결하는 경우에는 동일한 대상을 가리킨다는 추가 근거를 요구하여 잘못된 정보 연결을 방지하고자 했습니다.
- 다중 문서 필요성 검증: 전체 문서를 제공했을 때 질문에 답할 수 있는지 확인한 뒤, 일부 문서만으로도 정답에 도달할 수 있는 질문을 제외했습니다. 또한 검증 과정에서 정답이나 중간 질문의 힌트를 제거하여, 실제 문서의 근거만으로 해결할 수 있는지 확인했습니다.
- 질문 품질 개선: 문서에서 추출한 원자적 사실과 정보 간 연결 관계를 최종 질문 문장과 분리하여 관리했습니다. 이를 통해 유효한 정보 연결 관계는 유지하면서도, 질문 표현이 어색한 경우 재작성 및 재검증을 거쳐 자연스러운 질문만 활용하도록 했습니다.
그림 9. AgenticRAGTracer 방법론
결과적으로 HopWeaver를 통해 다양한 2-hop 질의를 생성하고, AgenticRAGTracer를 통해 더 복잡한 다단계 탐색이 필요한 질의까지 확장했습니다. 또한 생성된 질의가 실제로 여러 문서의 정보를 필요로 하는지 검증하여, Agentic Search 모델이 다양한 정보 탐색 과정과 검색 단계 간 의존관계를 학습할 수 있는 데이터셋을 구축했습니다.
3.1.3. Trajectory 생성 및 선별
앞선 과정을 통해 다양한 정보 탐색 상황을 포함하는 질의 데이터를 확보했지만, 질문과 정답만으로는 Agentic Search 모델이 실제 검색 과정에서 어떤 행동을 수행해야 하는지 학습하기 어렵습니다. 따라서 저희는 Teacher 모델이 실제 Agentic Search 엔진을 수행하며 생성한 검색 과정(Trajectory)을 학습 데이터로 활용하고자 했습니다.
이를 위해 수집 및 합성한 질의 데이터를 Teacher 모델에 입력하여 Agentic Search를 실행했습니다. 이 과정에서 Teacher 모델이 수행한 Search Planner, Search Plan Manager, Search Specifier, Document Selective Summazier 등의 과정을 Trajectory 형태로 수집했습니다. 다만 생성된 Trajectory 들 중 검색 과정에서 필요한 근거를 확보하지 못한 경우까지 학습에 활용하면, Student 모델이 부적절한 검색 행동을 학습할 가능성이 있기 때문에, 모든 Trajectory가 학습에 적합하다고 볼 수는 없습니다. 따라서 저희는 Trajectory의 최종 예측 결과에 정답 근거 문서가 포함된 경우를 Successful Trajectory로 정의하고, 해당 데이터만 선별하여 최종 학습 데이터셋에 포함했습니다.
| 데이터셋
|
전체 확보 수량 (A)
|
제외 수량 (B)
|
최종 활용 수량 (A-B)
|
| MuSiQue
|
21,824
|
7,240 (33.20%)
|
14,584
|
| SearchFireSafety
|
4,271
|
2,205 (51.60%)
|
2,066
|
| Ko-strategyQA
|
2,240
|
711 (31.70%)
|
1,529
|
| Wikipedia
|
8,775
|
3,335 (38.00%)
|
5,440
|
| 지식그래프-투-텍스트 데이터
|
7,135
|
3,989 (55.90%)
|
3,146
|
| 합계
|
17,480 (39.50%)
|
26,765
|
3.2. Agentic Search 모델 학습
앞서 3.1절에서 구축한 학습 데이터셋을 바탕으로, 저희는 대규모 Teacher 모델의 검색 의사결정 능력을 경량 Student 모델에 이전하기 위한 학습을 진행했습니다.
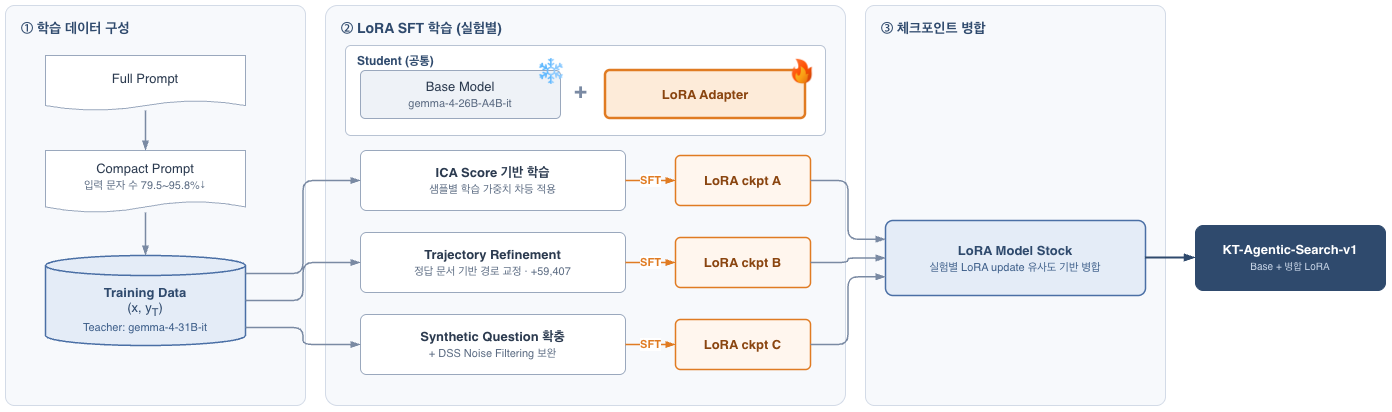
전체 학습 과정은 Teacher의 검색 Trajectory를 활용한 Knowledge Distillation과 서로 다른 학습 전략으로 생성한 체크포인트의 병합으로 구성했습니다. 먼저 Teacher가 생성한 검색 행동을 Student 모델에 학습시키기 위해 Compact Prompt 기반 Supervised Fine-Tuning(SFT)을 수행했습니다. 이후 데이터 가치(i.e., ICA Score) 평가 기반 학습, Trajectory 교정 데이터 기반 학습, Synthetic Question 보강 데이터 기반 학습을 각각 적용하여 세 개의 체크포인트를 확보했습니다.
마지막으로 LoRA Model Stock 기법을 활용해 세 체크포인트의 어댑터를 병합하여 최종 Agentic Search 특화 모델을 구성했습니다. 이를 통해 서로 다른 학습 전략으로 확보한 특성을 하나의 모델에 반영하고자 했습니다.
그림 10. Agentic Search 모델 학습 Overall Flow
3.2.1. Trajectory 기반 Knowledge Distillation
Agentic Search에서는 단순히 최종 정답을 생성하는 능력뿐 아니라, 검색 과정에서 어떤 정보를 먼저 확인하고, 어떤 도구를 활용하며, 검색 결과에 따라 다음 행동을 어떻게 결정하는지가 중요합니다. 이에 저희는 정답 중심의 학습 대신, Teacher가 실제 검색 과정에서 수행한 검색 계획 수립, 도구 호출, 근거 선별 및 다음 행동 결정 등의 Trajectory를 SFT 학습 대상으로 활용했습니다.
이때 Agentic Search는 여러 단계에서 LLM을 반복적으로 호출하므로, 모델 자체의 경량화뿐 아니라 입력 프롬프트의 효율성도 중요하게 고려했습니다. Teacher 모델은 상세한 지시사항이 포함된 Full Context Prompt를 기반으로 Trajectory를 생성했지만, Student 모델은 이를 간결하게 재구성한 Compact Prompt를 입력으로 사용하도록 설계했습니다.
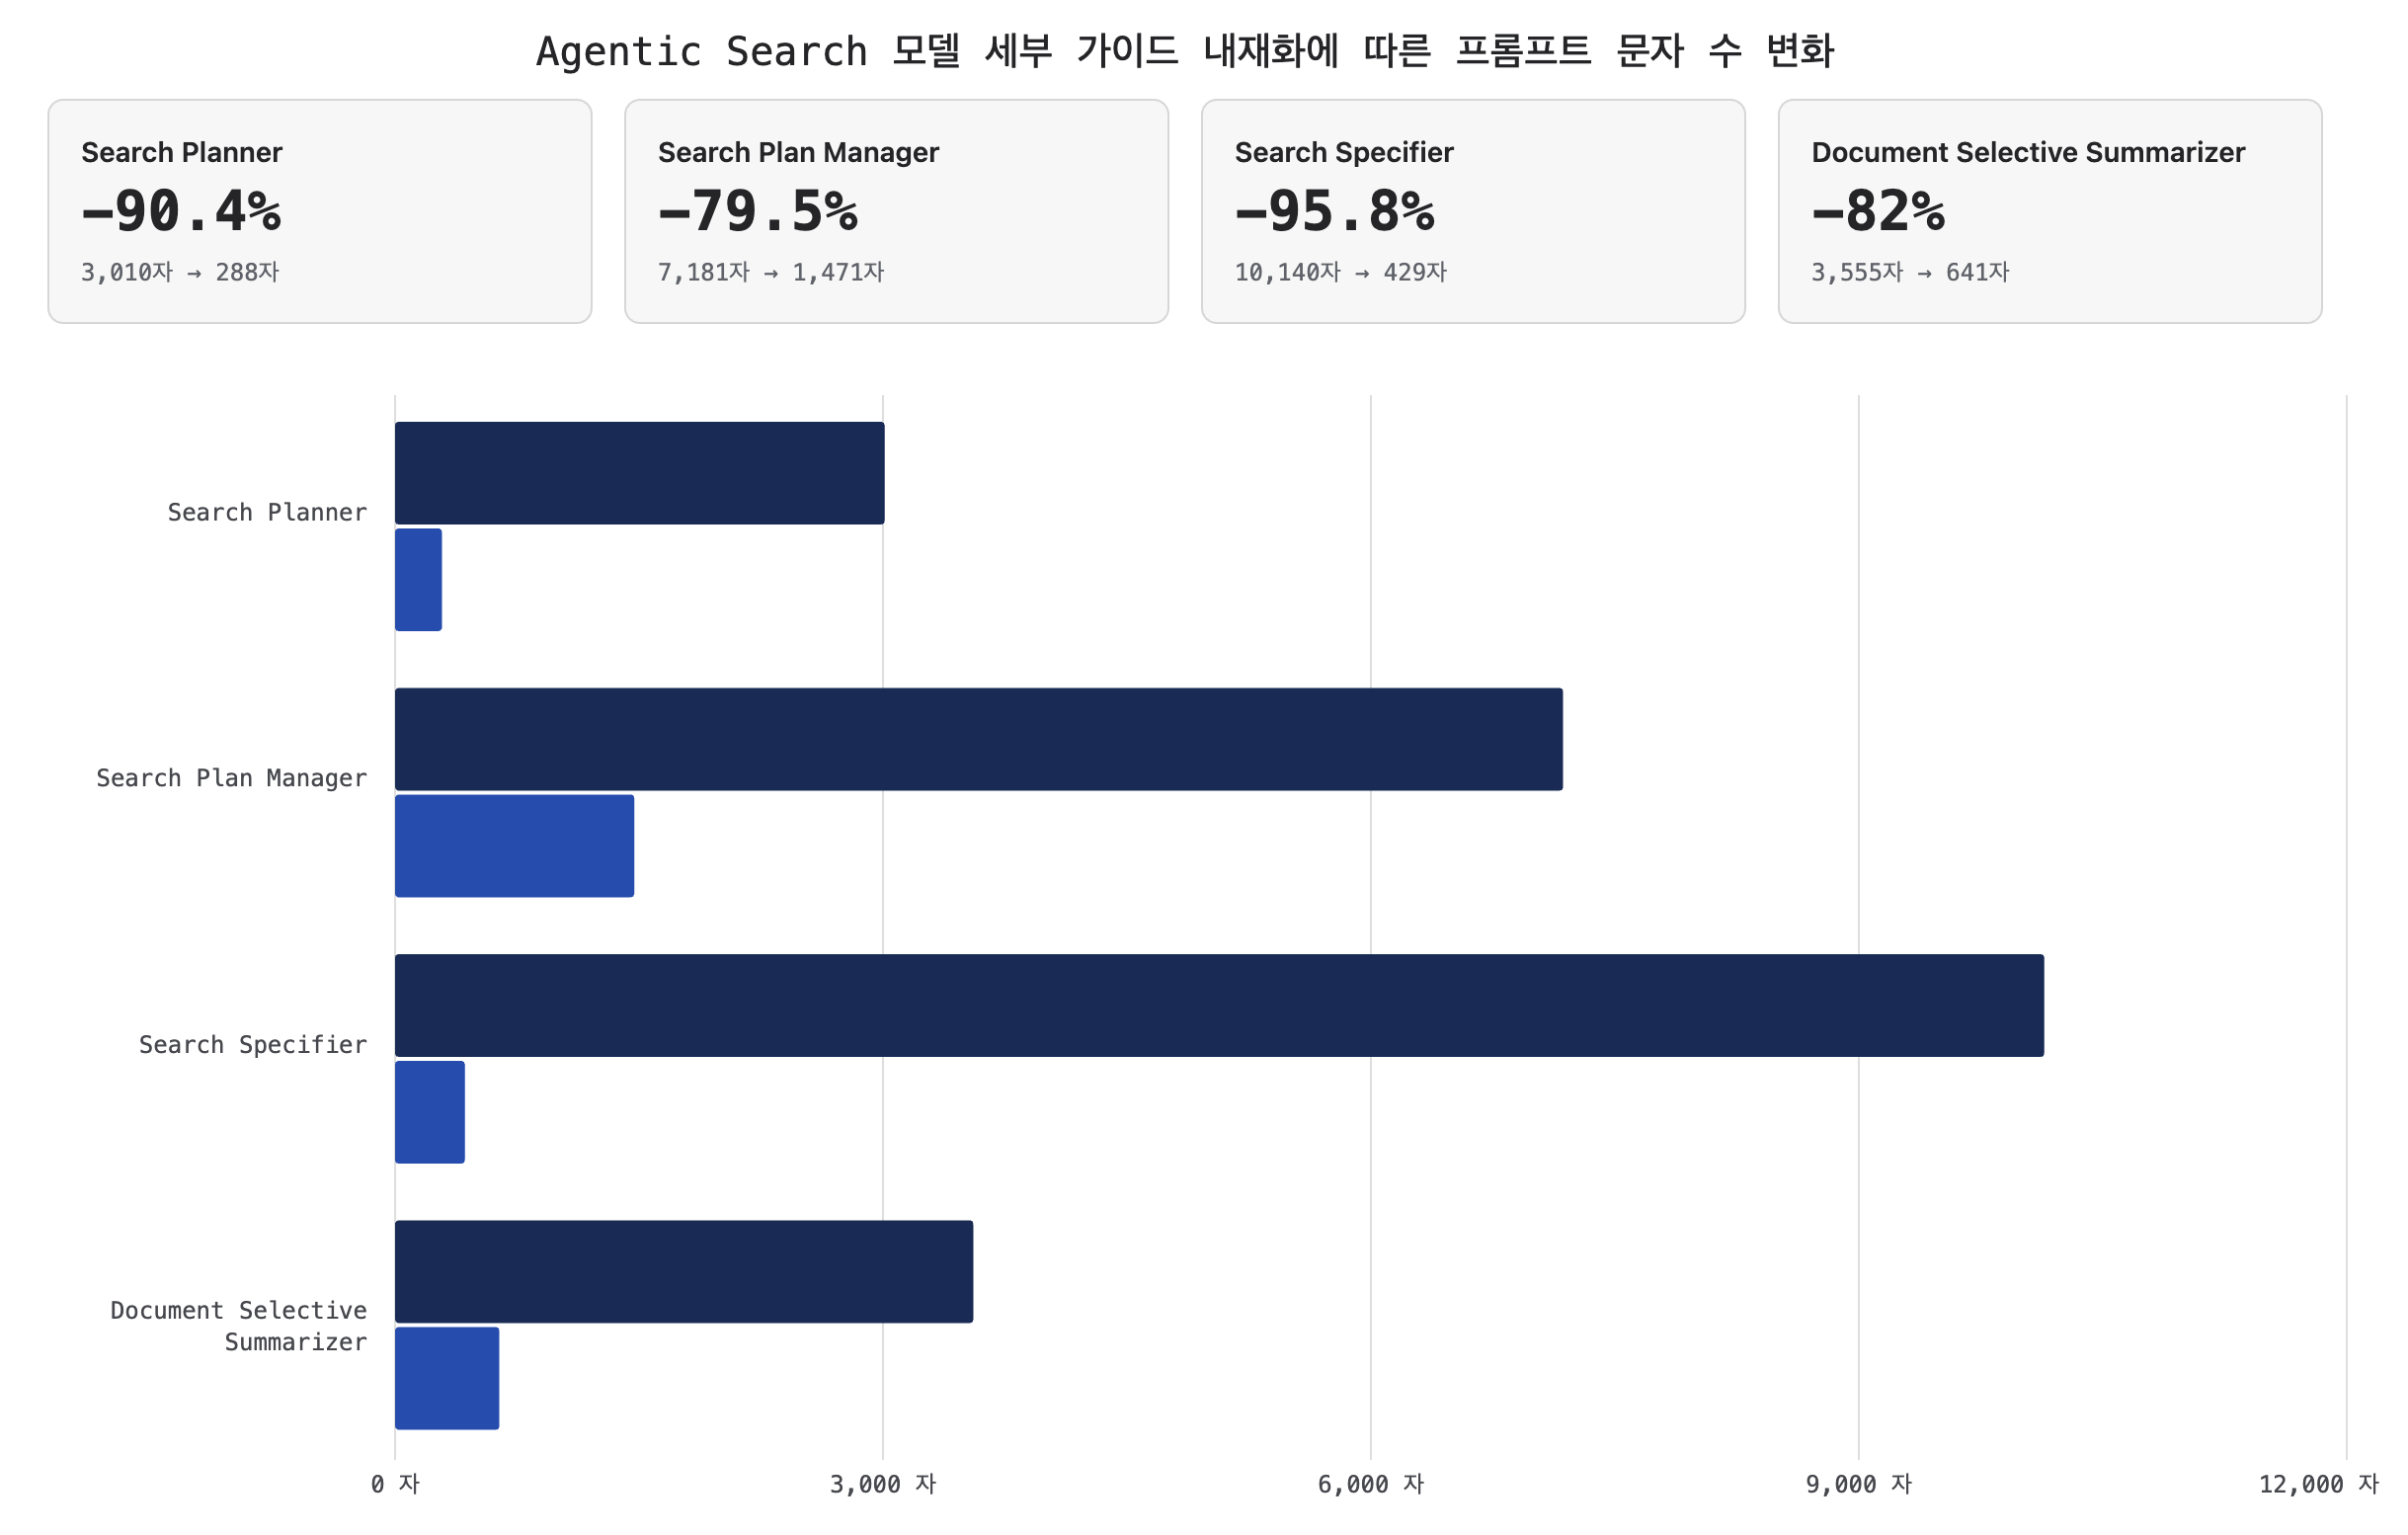
이를 통해 Student 모델이 상대적으로 간결한 입력으로도 Teacher의 검색 행동을 학습하도록 했으며, Agentic Search를 구성하는 4개 모듈의 입력 프롬프트 문자 수를 기존 대비 79.5~95.8% 줄였습니다. 이러한 프롬프트 경량화를 통해 반복적인 모델 호출에서 입력 토큰 부담을 완화하고 추론 효율성을 높이고자 했습니다.
그림 11. Full Context Prompt 대비 Compact Prompt 문자 수 변화
3.2.2. 학습 전략
① 데이터 가치 평가 기반 학습
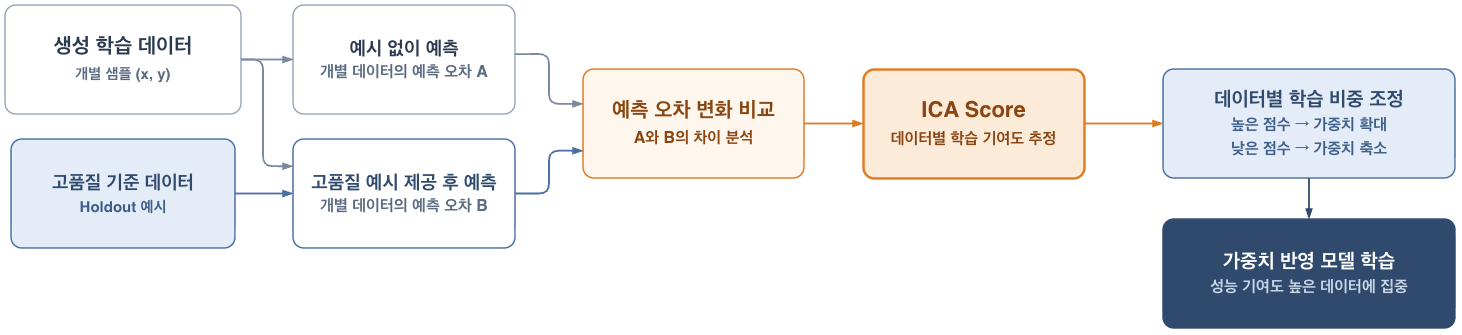
앞서 정답 근거 문서를 확보한 Trajectory를 선별했지만, 검색에 성공한 데이터라고 해서 모든 샘플이 모델의 성능 향상에 동일하게 기여하는 것은 아닙니다. 일부 데이터는 실제 평가 환경에서 요구되는 검색 행동을 학습하는 데 도움이 되는 반면, 다른 데이터는 상대적으로 학습 기여도가 낮을 수 있습니다. 저희는 이러한 차이를 학습 과정에 반영하기 위해 Holdout-Loss-Based Data Selection for LLM Finetuning via In-Context Learning 연구[8]를 참고하여 ICA(In-Context Approximation) Score 기반의 데이터 가치 평가 및 학습 가중치 최적화를 적용했습니다.
ICA Score는 목표 작업(Target Task)을 대표하는 고품질 데이터(Holdout Set)를 Few-shot Demonstration으로 제공했을 때, 개별 학습 샘플에 대한 모델의 정답 예측 확률이 얼마나 달라지는지를 측정하는 지표입니다. 이를 통해 별도의 Fine-tuning을 반복하지 않고도 각 학습 샘플이 목표 작업에 얼마나 부합하는지 추정할 수 있습니다. 저희는 이렇게 산출한 ICA Score를 학습 가중치에 반영하여, 목표 작업에 대한 기여도가 높을 것으로 평가된 샘플은 학습에 더 큰 비중으로 반영하고, 기여도가 낮은 샘플은 상대적으로 학습 비중을 줄이도록 했습니다. 이를 통해 모든 Trajectory를 동일한 비중으로 학습하는 대신, 목표 작업과의 연관성을 고려하여 데이터별 학습 영향을 차등화하는 방식으로 첫 번째 Student 모델 체크포인트를 확보했습니다.
그림 12. ICA Score 기반 데이터 가치 평가 및 가중치 학습
② Trajectory 교정 데이터 기반 학습
앞서 Teacher 모델이 생성한 Trajectory 중 정답 근거 문서를 확보한 데이터만 선별했지만, 복잡한 Multi-hop 질의에서는 Teacher 모델조차 필요한 근거 문서를 모두 찾지 못해 학습에 활용하기 어려운 경우가 있었습니다. 특히 3-hop 이상의 질의에서는 검색 단계가 늘어날수록 중간에 필요한 정보를 놓치거나 잘못된 탐색 경로로 이어질 가능성이 있어, 유효한 Trajectory를 충분히 확보하는 데 한계가 있었습니다.
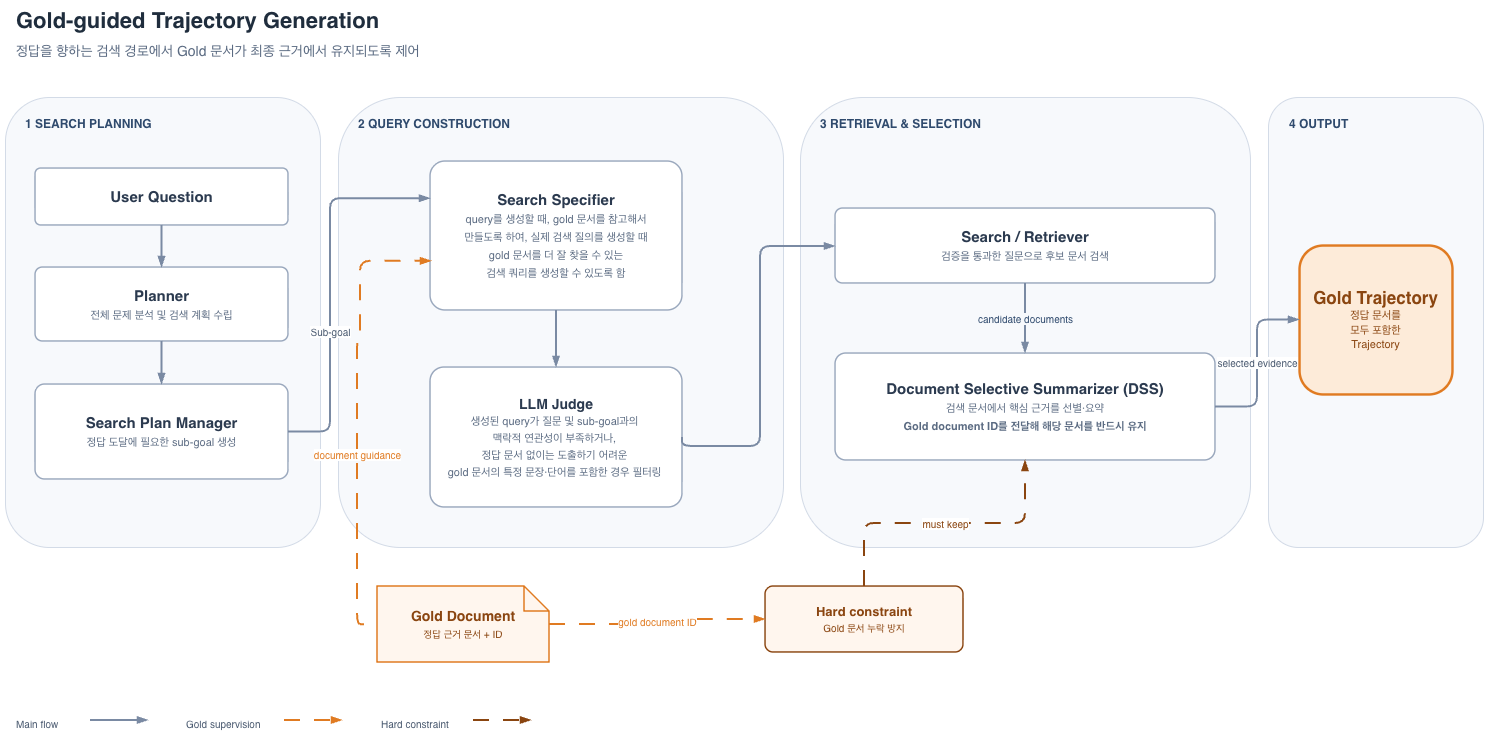
저희는 이러한 문제를 해결하기 위해 정답 근거 문서(Gold Document)를 활용하여 Teacher 모델의 탐색 경로를 교정하는 방식을 적용했습니다. 특히 검색 질의 생성과 근거 문서 선별이 최종 검색 결과에 직접적인 영향을 미친다는 점에 주목하여, 해당 역할을 수행하는 Search Specifier와 Document Selective Summarizer를 교정 대상으로 선정했습니다. 이때 각 모듈의 역할에 맞춰 정답 문서를 서로 다른 방식으로 제공하도록 설계했습니다.
- Search Specifier: 정답 문서의 내용을 참고하여 Search Planner가 설정한 검색 목표(Sub-goal)를 달성하는 데 필요한 검색 질의를 생성하도록 했습니다. 다만 정답 문서의 내용을 제공하면 실제 검색 맥락과 무관한 표현까지 질의에 포함될 수 있으므로, Sub-goal의 범위를 벗어나거나 질문 및 탐색 맥락과의 연관성이 낮은 정답 문서의 표현을 포함한 질의는 필터링했습니다.
- Document Selective Summarizer: 정답 문서의 내용 대신 문서 ID만 제공하여, 검색 결과에 포함된 정답 문서를 누락하지 않고 선별·요약하도록 했습니다. 이를 통해 필요한 근거 문서를 보존하는 방향으로 문서 선별 과정을 교정했습니다.
이러한 방식은 정답 문서를 무조건 검색 결과에 추가하는 것이 아니라, Teacher가 필요한 근거를 찾아가는 검색 행동 자체를 교정하기 위한 것으로, 기존에는 필요한 정답 문서를 모두 확보하지 못했던 질의의 탐색 경로를 교정하여 모든 정답 근거 문서를 확보하는 Trajectory를 생성하고, 총 59,407개의 학습 데이터를 추가로 확보했습니다. 이를 통해 기존 Teacher 모델의 검색 실패로 학습에서 제외되었던 데이터를 활용할 수 있게 되었으며, 복잡한 Multi-hop 질의에서 필요한 근거를 단계적으로 탐색하고 확보하는 행동을 학습할 수 있도록 두 번째 Student 모델 체크포인트를 구성했습니다.
그림 13. Trajectory 교정 과정
③ Synthetic Question 보강 데이터 기반 학습
앞서 Trajectory 교정을 통해 기존에 검색에 실패했던 질의에서도 학습 데이터를 추가로 확보했지만, 3-hop 이상의 복잡한 정보 탐색을 요구하는 학습 데이터는 여전히 부족했습니다.
실제로 Teacher 모델의 검색 결과를 분석한 결과, Hop 수가 증가할수록 필요한 정답 근거 문서를 모두 확보하는 성공률이 크게 감소하는 경향을 보였습니다. 2-hop 질의에서는 성공률이 73.32%였지만, 3-hop에서는 31.25%, 4-hop에서는 15.77%까지 낮아졌습니다. 이에 따라 정답 근거 문서를 모두 확보한 Trajectory의 약 85%가 2-hop 질의에 집중되어 있어, Student 모델이 고난도 다단계 탐색 과정을 학습하기 위한 데이터가 상대적으로 부족한 상황이었습니다.
저희는 이를 보완하기 위해 3-hop 이상의 복합 질의를 추가로 생성하는 Synthetic Question 보강 전략을 적용했습니다. 앞서 소개한 AgenticRAGTracer 방법론을 활용하여 여러 문서 간 정보 연결 관계를 단계적으로 확장함으로써, 기존 학습 데이터에서 부족했던 고난도 탐색 시나리오를 추가로 구성했습니다. 이를 통해 총 5,123개의 Synthetic Question을 추가로 확보했으며, 해당 질의를 바탕으로 Teacher 모델의 검색 Trajectory를 생성하여 세 번째 Student 모델 체크포인트 학습에 활용했습니다.
3.2.3. LoRA Model Stock 기반 모델 병합
앞서 저희는 ICA Score 기반 데이터 가치 평가, Trajectory 교정, Synthetic Question 보강이라는 세 가지 학습 전략을 적용하여 각각의 Student 모델 체크포인트를 확보했습니다. 각 체크포인트는 서로 다른 학습 데이터와 전략을 바탕으로 생성되었기 때문에, 각 학습 과정에서 얻은 특성을 하나의 모델에 통합하는 방법이 필요했습니다. 이를 위해 저희는 ECCV 2024에 발표된 Model Stock 방법론[9]을 LoRA Adapter 병합에 맞게 변형하여 적용했습니다.
Model Stock은 여러 Fine-tuned 모델의 학습에 따른 가중치 변화 방향을 비교하고, 모델 평균을 기준 모델(Anchor) 방향으로 보정하여 병합하는 방법입니다. 다만 기존 Model Stock은 전체 가중치를 Fine-tuning한 모델을 대상으로 설계되었으며, 동일한 데이터와 학습 설정에서 초기 Seed만 다르게 학습한 체크포인트 간 병합을 전제로 합니다. 반면 저희는 동일한 기반 모델에서 서로 다른 데이터 구성과 학습 전략으로 학습한 LoRA Adapter를 병합해야 했습니다. 따라서 모델 전체 가중치를 병합하는 대신, 각 LoRA Adapter가 학습한 가중치 변화량(Update)을 기준으로 Model Stock의 병합 방식을 적용했습니다. 구체적으로 각 LoRA 모듈에서 학습된 가중치 변화량을 계산하고, 모듈별 변화 방향의 유사도를 바탕으로 Adapter 평균을 Anchor 방향으로 보정하도록 구성했습니다.
구분
|
Original Model Stock
|
LoRA Adapter Model Stock
|
병합 대상
|
Full Fine-tuning된 모델의 전체 가중치
|
LoRA Adapter가 학습한 가중치 변화량
|
병합 방식
|
Layer별 가중치 변화 방향의 유사도를 활용해 모델 평균을 Anchor 방향으로 보정
|
LoRA 모듈별 가중치 변화 방향의 유사도를 활용해 Adapter 병합 결과를 보정
|
학습 조건
|
동일 데이터와 학습 설정에서 Seed를 달리하여 생성한 체크포인트
|
일부 학습 데이터와 전략이 서로 다른 체크포인트
|
이를 통해 ICA Score 기반 학습, Trajectory 교정 데이터 기반 학습, Synthetic Question 보강 데이터 기반 학습으로 확보한 세 개의 학습 전략으로 얻은 LoRA Adapters를 병합하여 최종 Agentic Search 특화 모델인 KT-Agentic-Search-v1을 구성했습니다.
4. 결과
KT-Agentic-Search-v1의 성능을 검증하기 위해 도메인과 난이도가 서로 다른 세 가지 벤치마크에서 기존 Base Model 대비 검색 성능과 실행 효율성을 비교 평가했습니다. 또한 저희 Agentic Workflow를 R2MED 리더보드에서 평가하여, 제안한 검색 워크플로우의 성능을 추가로 검증했습니다.
4.1. 실험 세팅
Base Model
gemma-4-26B-A4B-it, gemma-4-31B-it, KT-Agentic-Search-v1
평가 벤치마크
| 벤치마크
|
전체 질의 수
|
도메인
|
특징
|
| KoBLEX[10]
|
226
|
법률
|
법적 분쟁 상황과 구체적인 판단 요구사항이 주어지면, 결론에 필요한 관련 법률 문서를 검색하고 이를 근거로 타당한 법적 판단을 수행해야 하는 데이터셋
|
| MuSiQue[11]
|
300
|
일반지식
|
여러 단계의 추론을 거쳐야 답할 수 있는 복합 질의로 구성된 평가 데이터
|
| EnterpriseRAG[12]
|
500
|
기업 업무 지식
|
기업 내부 업무 환경을 모사한 가상 질의 기반 벤치마크로, 9개 지식 소스의 문서와 질문으로 구성
|
4.2. 평가 결과
4.2.1. 벤치마크 기반 검색 성능
| 평가 데이터셋
|
Base Model
|
Precision
|
Recall
|
F1 Score
|
평균 실행 시간
|
KoBLEX
|
gemma-4-26B-A4B-it
|
26.02
|
90.44
|
36.47
|
29.60초
|
| gemma-4-31B-it
|
44.72
|
88.32
|
53.77
|
53.30초
|
| KT-Agentic-Search-v1
|
64.46
|
85.88
|
68.47
|
28.21초
|
MuSiQue
|
gemma-4-26B-A4B-it
|
42.44
|
76.28
|
50.64
|
35.30초
|
| gemma-4-31B-it
|
57.57
|
72.58
|
60.28
|
65.90초
|
| KT-Agentic-Search-v1
|
73.80
|
64.81
|
65.11
|
34.73초
|
EnterpriseRAG
|
gemma-4-26B-A4B-it
|
11.12
|
61.67
|
16.00
|
65.60초
|
| gemma-4-31B-it
|
26.61
|
65.49
|
32.85
|
91.30초
|
| KT-Agentic-Search-v1
|
56.86
|
63.51
|
57.60
|
45.67초
|
4.2.2. R2MED 리더보드 1등 달성
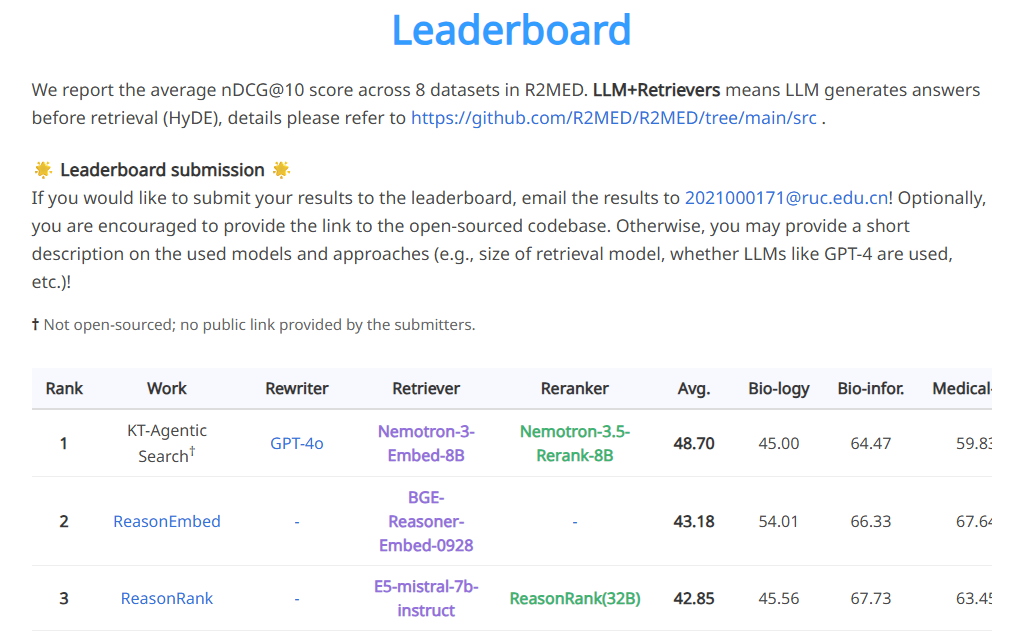
앞선 벤치마크 평가에 더해, Agentic Workflow 자체의 성능을 검증하기 위해 GPT-4o 기반으로 구성한 검색 워크플로우를 의료 도메인 검색 벤치마크인 R2MED[13] 리더보드에 제출했습니다. 평가 결과, 평균 nDCG@10 기준 48.70점을 기록하며 2026년 11월 11일 기준 R2MED 리더보드 1위를 달성했습니다 (리더보드 링크).
마치며
이번 글에서는 Agentic Search 엔진의 구조와 검색 특화 모델 KT-Agentic-Search-v1의 개발 과정을 소개했습니다. 질문에 필요한 정보의 탐색 계획을 수립하고, 검색 결과를 검토하며, 다음 탐색 방향을 결정하는 과정을 경량 모델에 학습시켜 Teacher 모델 대비 검색 성능과 실행 속도를 모두 개선했습니다. 나아가 제안한 Agentic Workflow를 통해 R2MED 리더보드에서 1위를 달성하며, 외부 벤치마크에서도 검색 워크플로우의 경쟁력을 입증했습니다.
한편, 평가 과정에서 검색 정밀도(Precision)는 향상되었지만, 필요한 근거를 충분히 확보하는 재현율(Recall) 측면에서는 여전히 개선 여지가 있음을 확인했습니다. 앞으로는 여러 문서에 분산된 근거를 종합해야 하는 복잡한 질문에서도 정보 누락을 최소화하고, 충분한 근거가 확보된 경우에는 불필요한 검색을 줄여 검색의 정확성과 효율성을 함께 높이고자 합니다. 나아가 검색된 근거가 정확하고 신뢰할 수 있는 최종 응답으로 이어지도록 검색과 응답 생성 과정을 함께 고도화하여, 실제 기업 환경의 다양한 업무 질문에도 안정적으로 대응할 수 있는 Agentic RAG로 발전시켜 나가겠습니다.
출처
- [1] https://huggingface.co/datasets/bdsaglam/musique
- [2] https://github.com/qqplot/SearchFireSafety
- [3] https://huggingface.co/datasets/taeminlee/Ko-StrategyQA
- [4] https://huggingface.co/datasets/wikimedia/wikipedia
- [5] https://www.aihub.or.kr/aihubdata/data/view.do?pageIndex=1&currMenu=115&topMenu=100&srchOptnCnd=OPTNCND001&searchKeyword=%EA%B2%80%EC%83%89&srchDetailCnd=DETAILCND001&srchOrder=ORDER001&srchPagePer=20&srchDataRealmCode=REALM002&srchDataRealmCode=REALM002&aihubDataSe=data&dataSetSn=71728
- [6] https://aclanthology.org/2026.acl-long.1295/
- [7] https://aclanthology.org/2026.findings-acl.66/
- [8] https://arxiv.org/abs/2510.14459
- [9] https://arxiv.org/abs/2403.19522
- [10] https://arxiv.org/abs/2509.01324
- [11] https://arxiv.org/abs/2108.00573
- [12] https://arxiv.org/abs/2605.05253
- [13] https://arxiv.org/abs/2505.14558