
들어가며
안녕하세요. KT AX사업부문 AX Engineering본부에서 B2B AX 사업 이행(Delivery)을 담당하고 있는 김민재입니다.
최근 몇 년 사이 고객사의 AX 요구사항은 크게 다각화되었습니다. 얼마 전까지 Multi-Agent 서비스를 어떻게 구축할 것인가가 논의의 중심이었다면, 지금은 Harness와 Ontology, Physical AI까지 범위가 넓어졌습니다. 이러한 요구에 대응하기 위해 저희 팀에서도 최신 AI 기술을 꾸준히 조사하고 내부에 공유하는 활동을 이어오고 있습니다.
저희 본부는 지난해 Microsoft ISE(현 Frontier Company)와 함께 자율주행 데이터 운영 플랫폼 AVOps를 개발했습니다. 그리고 이를 출발점으로 자율주행 원천기술 연구로 범위를 확장했습니다. AVOps는 Autonomous Vehicle Operations의 줄임말로, 자율주행 개발에 필요한 데이터·학습·검증 운영을 하나로 묶은 개념입니다.
이 글에서는 AVOps 플랫폼을 구축한 과정과, 여기서 파생된 두 건의 연구 — 사고 이해 파이프라인 설계, 그리고 AI 모델의 추론 근거 분석 — 를 차례로 소개하겠습니다.
1. AVOps: 자율주행 데이터 운영 플랫폼
자율주행 모델의 성능에는 학습 데이터의 품질이 결정적입니다. 그런데 테스트 차량이 하루에 수집하는 주행 데이터는 대부분 중복됩니다. 직진과 정속 주행, 무난한 차선 유지가 반복되기 때문에, 수집량을 늘리는 것만으로는 모델이 새로 배울 것이 많지 않습니다.
학습 가치는 오히려 드물게 나타나는 장면에 집중되어 있습니다. 흔한 직진 주행 영상 1만 건보다 갑자기 도로로 뛰어드는 보행자 한 건이 모델 학습에 더 가치가 있습니다. 이렇게 드물지만 중요한 상황을 long-tail 시나리오라고 부릅니다.
AVOps가 다루는 문제가 바로 이것입니다. 차량에서 수집된 데이터 중 학습 가치가 있는 장면을 선별하고, 자동으로 어노테이션을 붙이고, 주행 상황 단위로 검색할 수 있게 만드는 것입니다.
AVOps 아키텍처
AVOps는 크게 세 축으로 구성됩니다. 데이터를 모으고 정제하고 라벨링하는 DataOps, 모델을 학습시키는 MLOps, 그리고 기능안전을 검증하는 ValidationOps입니다.
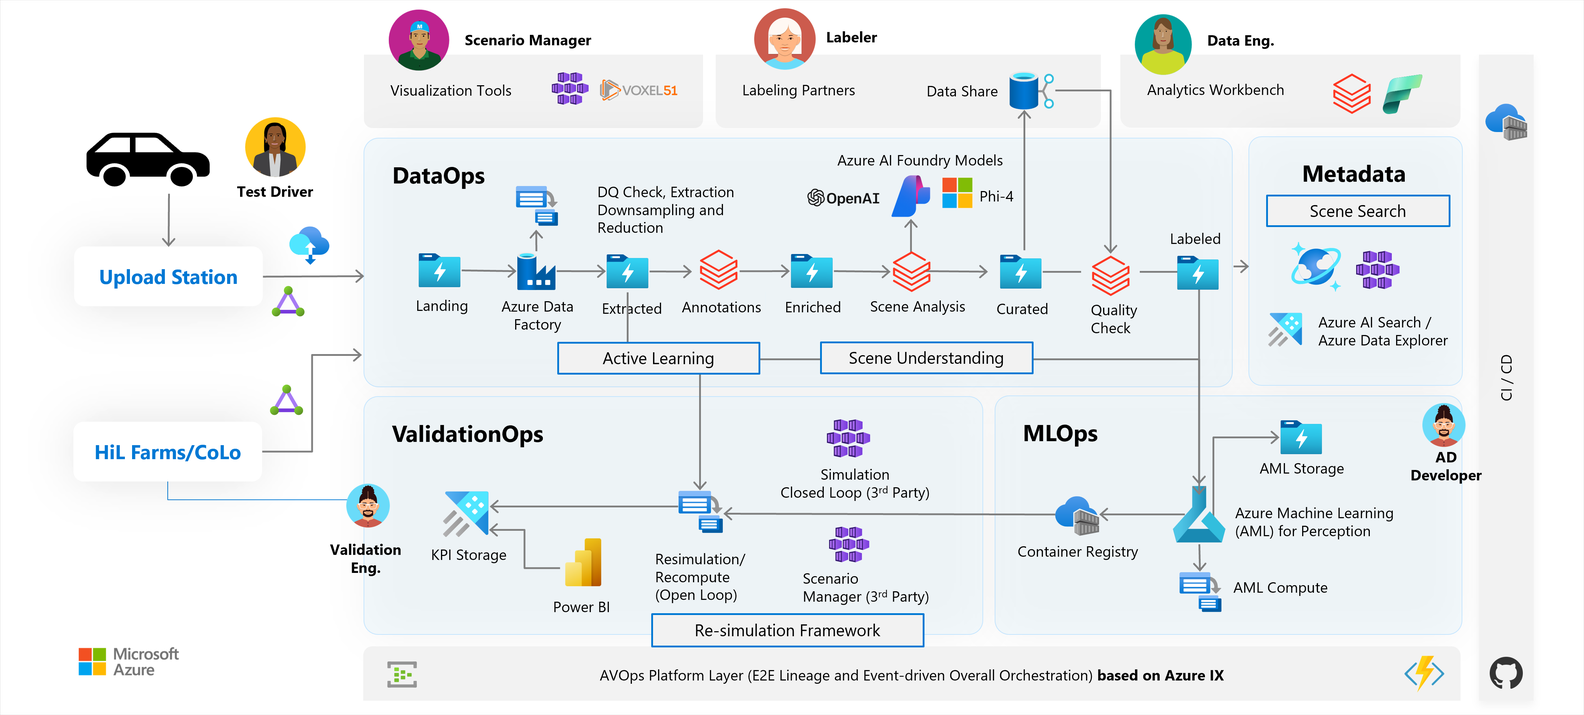
그림 1. AVOps 레퍼런스 아키텍처 (출처: Microsoft Learn [1])
이 중 저희가 담당한 영역은 DataOps 축입니다. DataOps의 역할은 E2E(End-to-End) 주행 모델을 개발하는 완성차·자율주행 기업에 고품질 학습 데이터를 공급하는 것입니다. 차량(엣지)에서 수집된 데이터 중 가치 있는 장면을 선별하고 어노테이션을 붙여, 학습에 바로 투입할 수 있는 형태로 전달합니다.
Scene Library: 서로 다른 데이터 소스를 하나의 스키마로
플랫폼의 첫 번째 핵심 기능은 Scene Library입니다. 성격이 다른 여러 데이터 소스를 하나의 표준 스키마로 통합하는 계층입니다.
이 기능이 필요했던 이유는 데이터셋마다 특성과 형식이 달랐기 때문입니다. 예를 들어, Waymo는 5대의 카메라와 LiDAR 데이터를 함께 제공해 다양한 주행 환경을 폭넓게 담고 있습니다. nuScenes는 3D 어노테이션이 잘 갖춰져 있어 3D 객체 검출 학습에 바로 쓸 수 있고, KADIF는 국내 도로 환경을 담고 있습니다. 그런데 데이터셋마다 파일 구조도, 어노테이션 규격도, 좌표계도 제각각입니다. 그래서 하나의 정규 스키마를 정의하고, 데이터셋별 어댑터가 원본을 그 스키마로 변환하도록 설계했습니다. 새로운 데이터셋은 어댑터만 추가하면 편입됩니다.
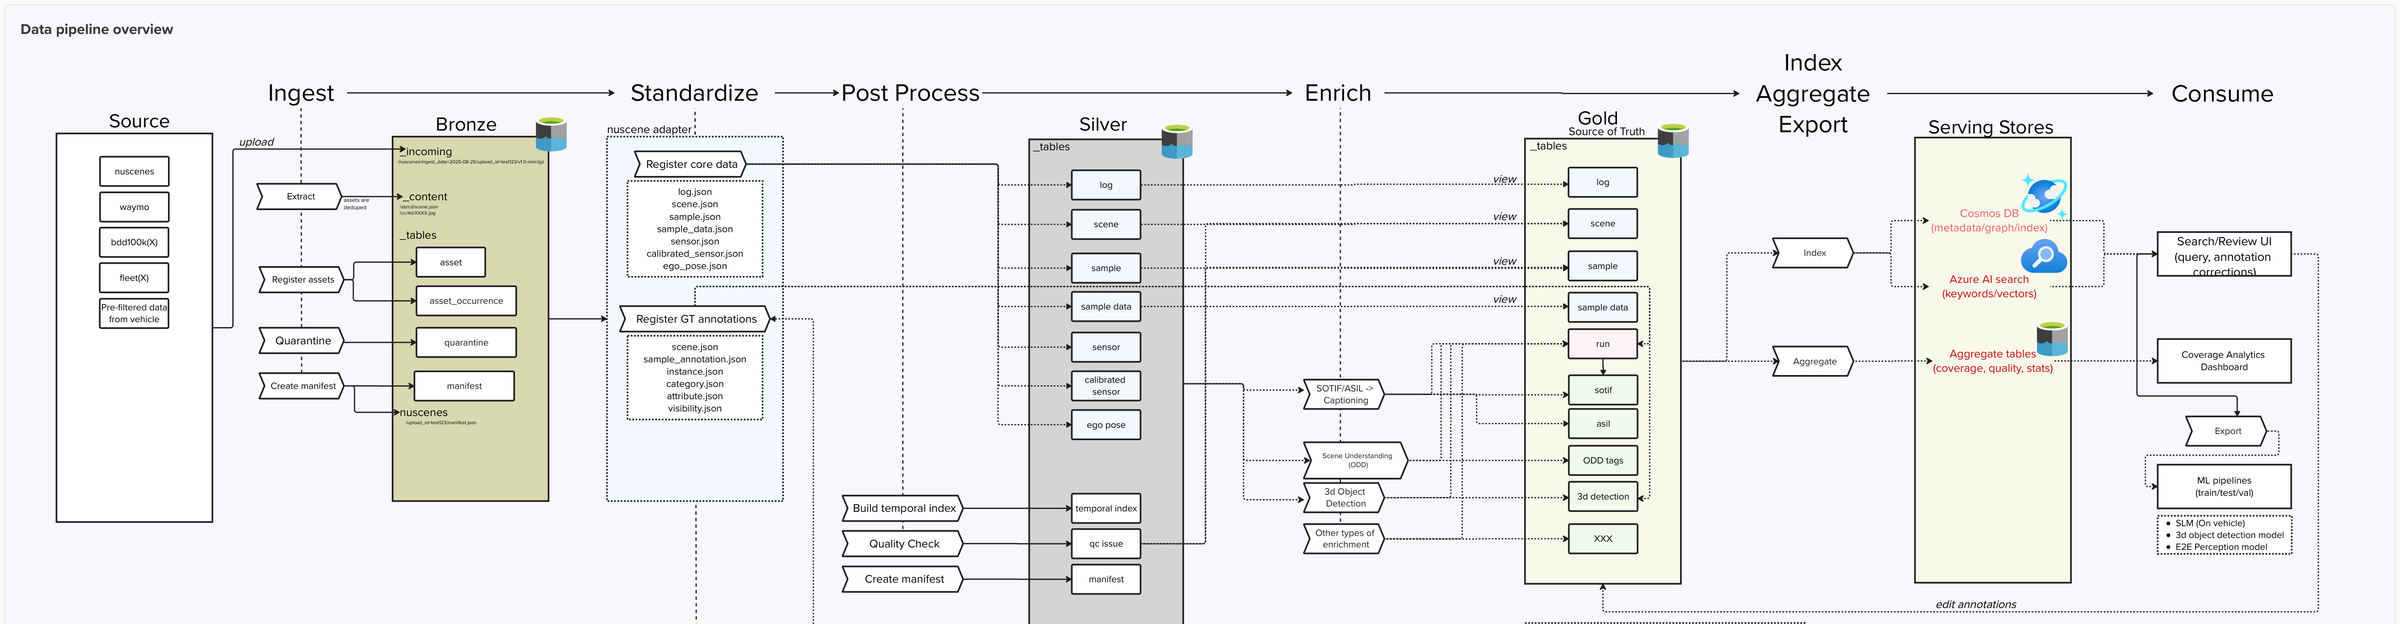
그림 2. Scene Library 데이터 파이프라인
Scene Library는 네 계층의 스키마로 구성했습니다. 원본을 해시 기반으로 중복 제거해 적재하고(Bronze), 어댑터를 거쳐 정규 스키마로 변환하고(Silver), 자동 어노테이션으로 정보를 보강한 뒤(Gold), 검색과 분석을 위해 색인합니다(Index). 이때 Gold를 단일 진실 공급원(source of truth)으로 두고 하위 계층은 필요할 때 다시 생성하도록 해, 색인 스키마가 바뀌어도 파이프라인 전체를 손대지 않도록 했습니다.
Data Ingestion: AI가 프레임 단위로 위험 등급을 매기는 자동 분석
두 번째 핵심 기능은 Data Ingestion입니다. 적재된 클립에 AI 모델이 직접 어노테이션을 붙이는 단계입니다. 분석을 실행하면 전면 카메라 이미지와 주행 데이터를 함께 VLM(Vision Language Model, 비전 언어 모델)에 입력합니다. VLM은 프레임마다 장면 설명과 관련 객체, 위험을 유발하는 조건(trigger condition)을 추출한 뒤, 심각도(S)·노출 빈도(E)·제어 가능성(C) 세 축으로 등급을 매기고 그렇게 판단한 근거까지 문장으로 남깁니다.
여기서 기준이 되는 것이 SOTIF(Safety of the Intended Functionality, ISO 21448)입니다. 기존 기능안전 표준인 ISO 26262가 센서 고장이나 회로 결함처럼 결함으로 인한 위험을 다룬다면, SOTIF는 결함이 없는데도 의도한 기능을 충분히 수행하지 못해 발생하는 위험을 다룹니다. 눈이 쌓여 차선이 가려진 도로에서 인식이 실패하는 상황이 대표적입니다. 그래서 모델에게 “이 장면이 위험한가”를 묻는 대신 “무엇이 기능을 무너뜨릴 수 있는가”를 묻고, 그 답을 등급화합니다.
세 값이 나오면 판정표를 거쳐 위험 등급(ASIL)이 계산되고, 위험한 프레임은 critical로 강조되어 20초 길이의 클립 안에서 위험 구간이 어디에 몰려 있는지 한눈에 확인할 수 있습니다.
AVOps 플랫폼 산출물
최종 플랫폼의 형상은 다음과 같습니다.
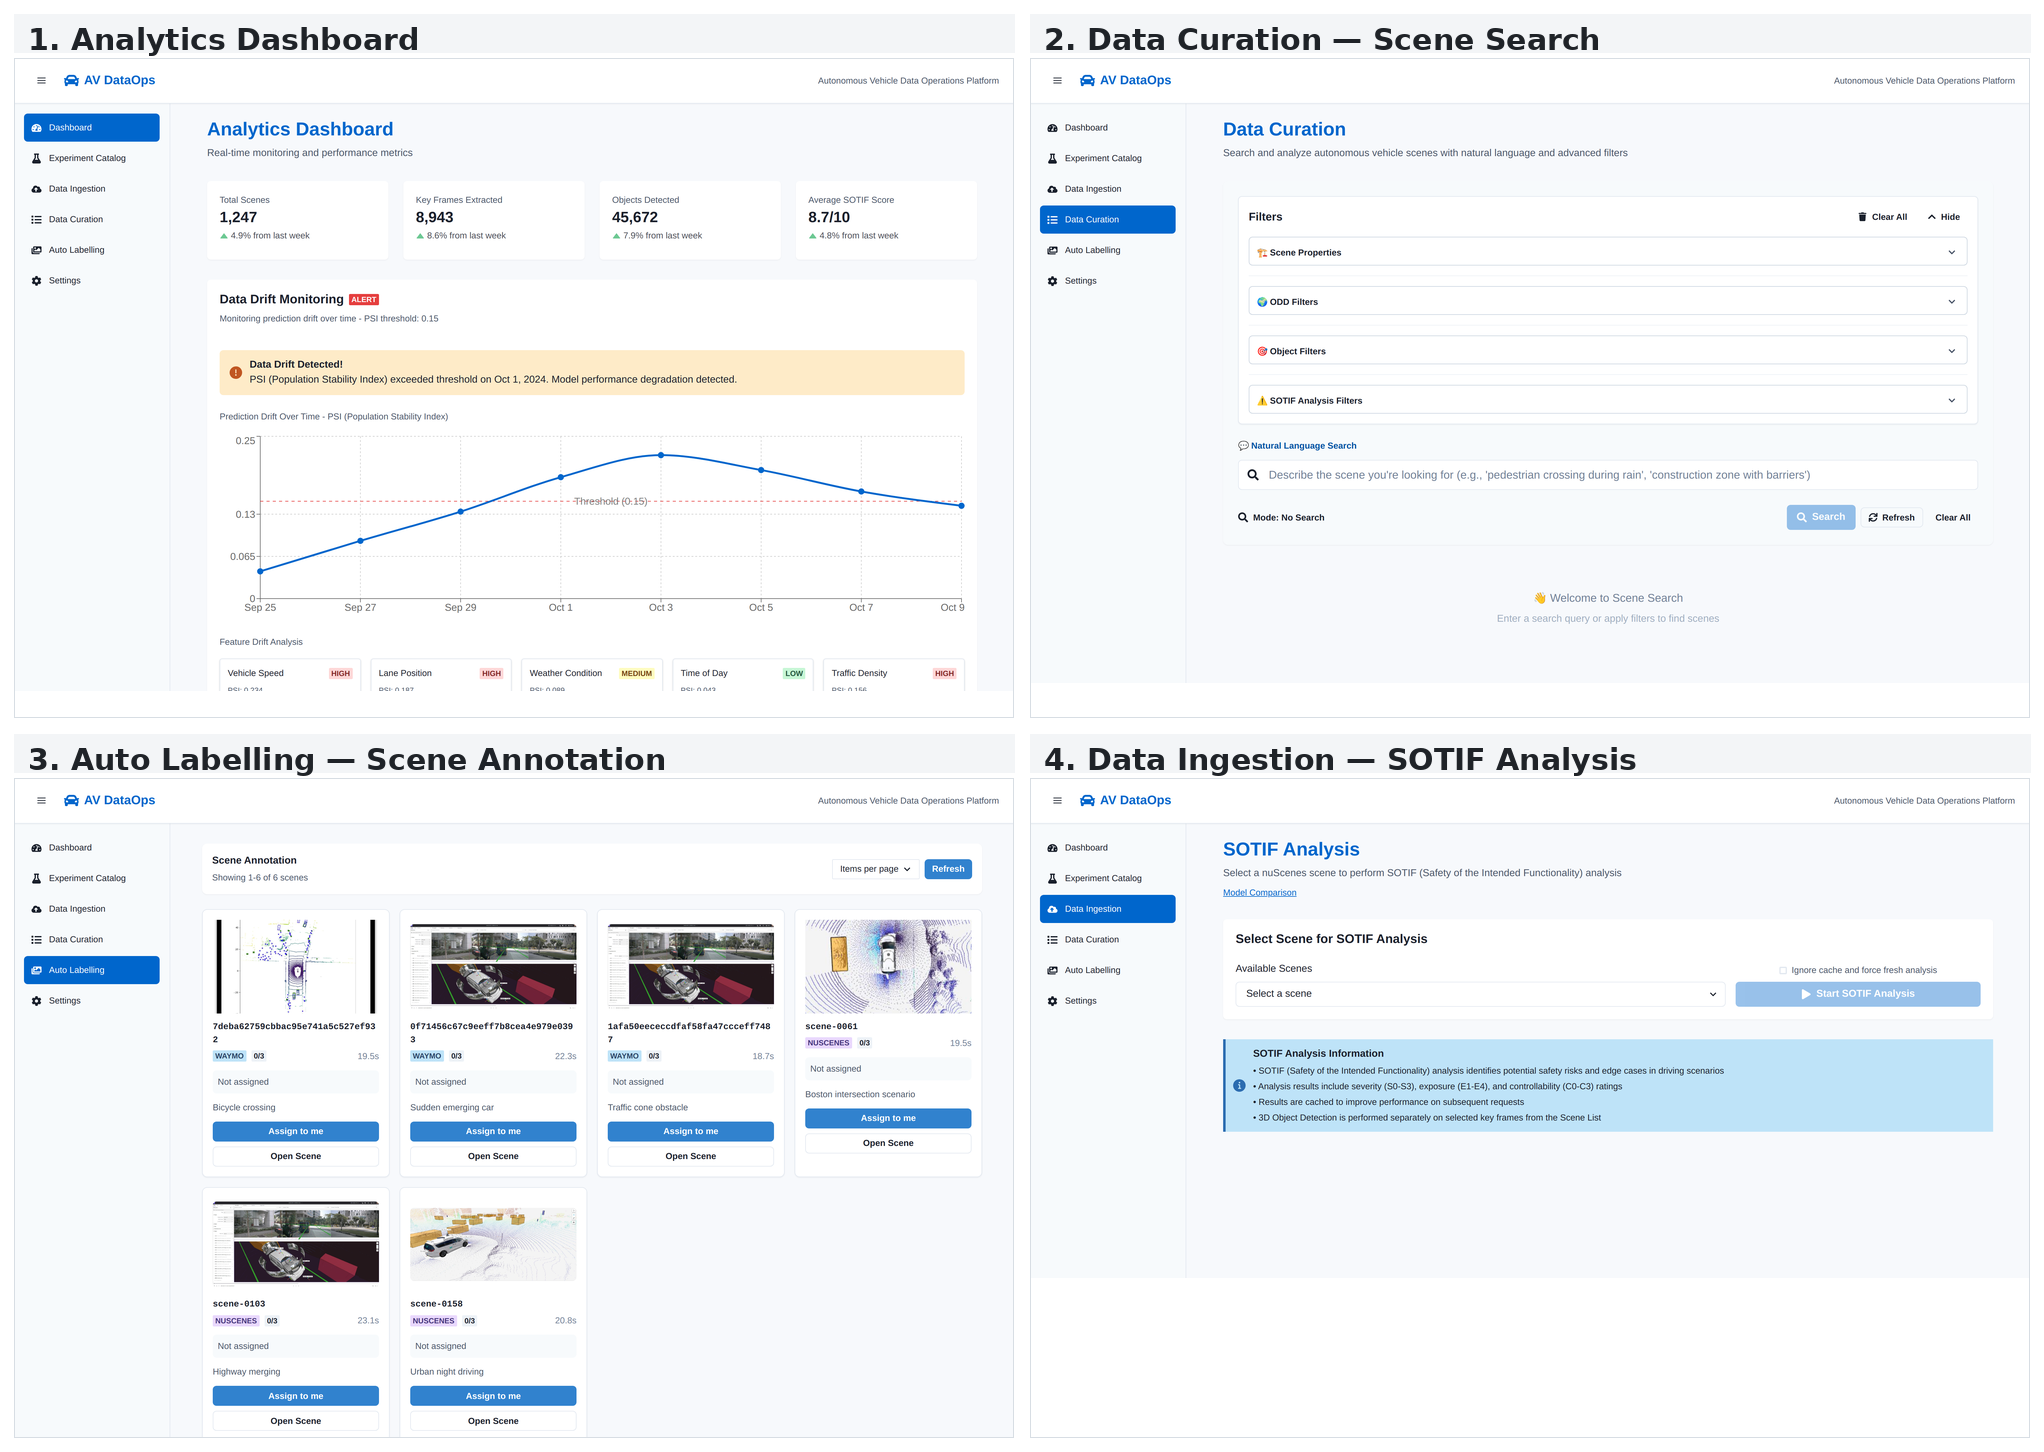
그림 3. AVOps 플랫폼 주요 화면
앞서 설명한 Scene Library와 Data Ingestion 외에도 몇 가지 기능이 더 있습니다. Analytics Dashboard는 수집 현황과 데이터 분포의 변화를 모니터링하는 화면입니다. Data Curation에서는 Data Ingestion이 부여한 위험 등급과 날씨·시간대 같은 주행 조건으로 범위를 좁힌 뒤, “비 오는 날 횡단하는 보행자”처럼 문장으로 특정 장면을 검색할 수 있습니다. Auto Labelling에서는 분석 결과를 사람이 검토하고 확정할 수 있습니다.
이 플랫폼을 활용하여 Microsoft Global Hackathon에 참가해 ISE Japan 어워드를 수상하는 성과를 얻었습니다. KT와 ISE 구성원에 더해 Microsoft의 자율주행 도메인 전문가들이 팀에 합류하면서, 데이터 설계와 시나리오 정의를 함께 검토하며 완성도를 끌어올릴 수 있었습니다. 현재 AVOps 플랫폼은 사내외 귀빈에게 KT의 AX 역량을 소개하는 공간인 KT 이노베이션 허브(West 타워 11층)에 전시되어 있습니다.
2. long-tail 시나리오 연구로의 확장
플랫폼을 1차 완성한 뒤, 저희는 AI 모델 기반의 long-tail 시나리오 탐지 연구에 관심을 갖게 되었습니다. Data Ingestion에서 프레임별 위험 등급을 매기는 VLM의 판단 품질을 높이는 일이 플랫폼 개발 중에도 가장 도전적인 과제였기 때문입니다. 위험 등급이나 주행 조건 같은 룰 기반 검색은 장면의 특징을 나열할 뿐, “왜 위험한가”에는 답하지 못합니다. 사고 영상을 프레임 단위로 훑으며 상황을 인과적으로 이해하고 추론하는 능력이 필요했습니다.
학계의 관심도 같은 방향으로 움직이고 있었습니다. 자율주행 사고 이해 과제는 “어떤 객체가 위험해 보이는가”를 넘어, 사고의 원인과 유형, 예방 조치까지 묻는 방향으로 확장되고 있습니다. 이 질문들에 답하려면 사고가 어떤 순서로 전개되었고 무엇이 결과를 결정했는지를 이해해야 합니다. 즉, 과제의 중심이 정지 이미지 단위의 객체 검출에서 시계열(temporal) 인과 추론으로 옮겨간 것입니다.
이에 AVOps를 함께 개발한 KT와 Microsoft ISE 구성원들은 프로젝트 종료 이후에도 이 주제를 사이드 프로젝트로 이어받아, VLM 기반 사고 이해 연구를 진행했습니다.
3. 첫 번째 연구: 프롬프팅을 넘어 구조화된 인과 추론으로
연구는 “VLM이 사고 장면을 제대로 읽지 못하는 것은 영상 속 대상의 위치를 정확히 파악하지 못하기 때문이며, 객체 검출 결과를 명시적으로 제공하면 성능이 개선될 것이다”라는 가설에서 출발했습니다.
이를 검증하기 위해 VRU(Vulnerable Road User, 보행자·자전거 이용자 등 사고에 취약한 도로 사용자)를 찾는 Detector 모듈, 프레임별 VRU의 바운딩 박스를 덧그리는 Visual Overlay 모듈, 검출 결과를 바탕으로 CoT(Chain-of-Thought) 추론을 이끄는 Reasoning 모듈을 VLM에 결합했습니다. 검출(Detection)과 추론(Reasoning)을 결합해 VLM을 보강한다는 뜻에서 이 파이프라인을 DRIVE(Detection-Reasoning Integrated VLM Enhancement)라고 이름 붙였습니다. DRIVE는 사고 영상에 대한 객관식 질의응답 벤치마크인 VRU-Accident에서 전체 정확도 74.62%로 당시 기준 최고 성능을 기록했습니다.
오답에서 발견한 구조
최고 성능을 기록했지만, 오답을 분석한 결과, 틀린 이유가 몇 가지 패턴에 집중되어 있다는 사실을 확인했습니다. DRIVE가 틀린 278건은 네 가지 유형으로 나뉘었고 그중 상위 세 유형이 전체의 86%를 차지했습니다.
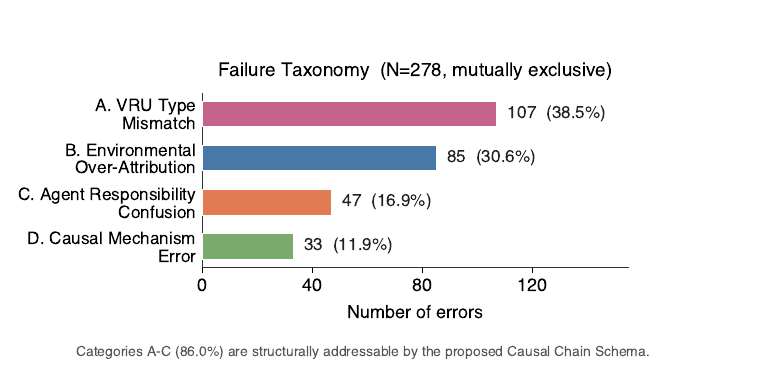
그림 4. DRIVE 오답 278건의 유형별 분류
세 유형은 각각 VRU의 종류를 혼동하거나(보행자만 검출된 장면에서 “자전거 이용자가 알아채지 못했다”를 선택), 환경에 원인을 과도하게 돌리거나(비가 보이면 정답이 “운전자 부주의”인데도 “노면 불량”을 선택), 자차와 VRU의 책임을 뒤바꾸는 경우였습니다. 공통점은 원인을 따져 묻는 과정이라면 당연히 거쳐야 할 중간 추론 단계가 빠져 있다는 것입니다. 날씨나 도로 유형 같은 정보를 더 제공해도 개선 효과는 미미했습니다. 문제는 모델이 무엇을 보는지가 아니라 어떻게 추론하는지에 있었습니다.
추론을 다섯 단계로 분해하다
이에 따라 사고 원인 추론을 다섯 단계로 나누고, 각 단계에서 정해진 선택지 중에서만 고르도록 한 파이프라인을 제안했습니다. 앞 단계의 결과가 다음 단계의 선택지를 좁히는 구조입니다.
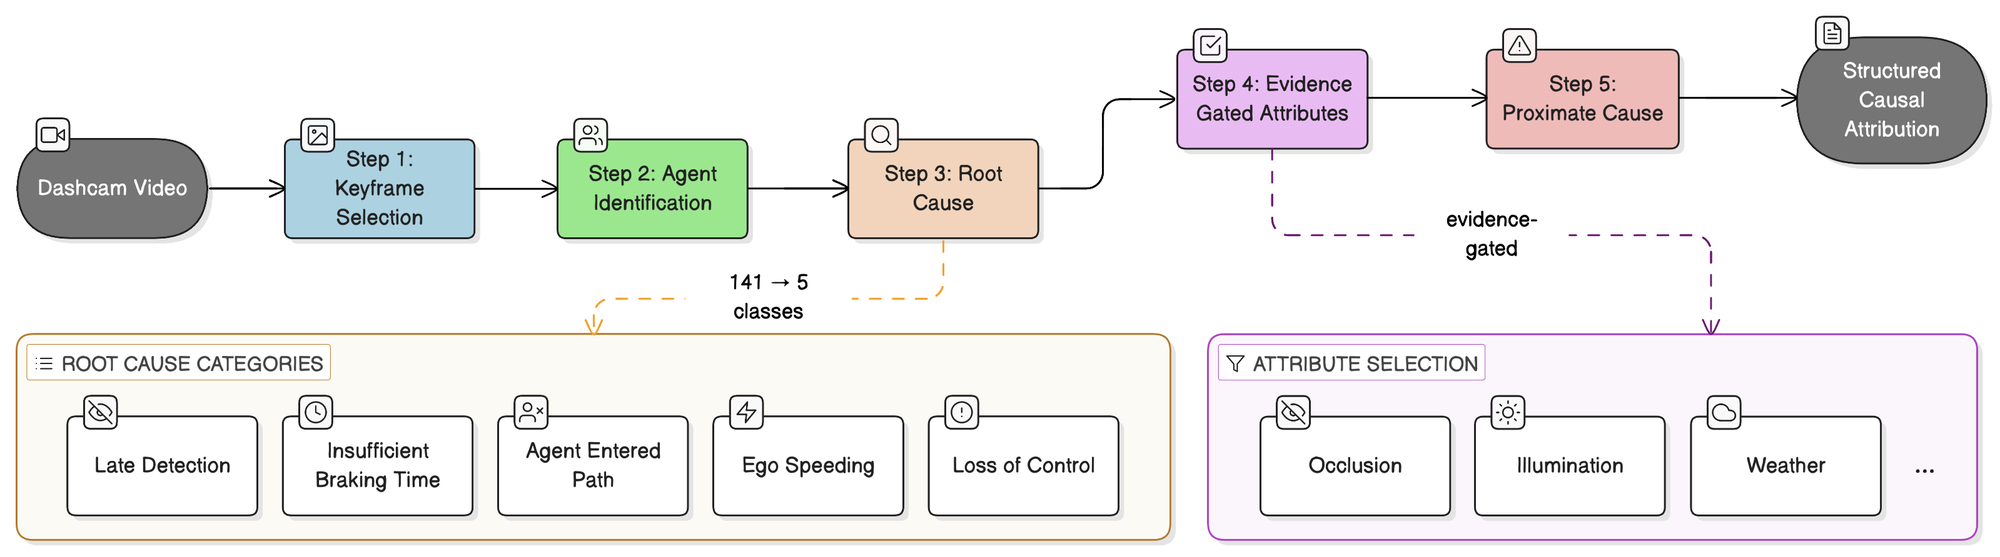
그림 5. Structured Causal Chain 5단계 파이프라인
사고의 결과가 결정된 키프레임을 찾고, 그 시점에 결과에 영향을 준 행위 주체를 선택한 뒤, 사고 원인을 다섯 가지 유형으로 분류합니다. 가장 중요한 장치는 네 번째 단계의 증거 게이팅입니다. ‘제어 상실’을 원인으로 선택하려면 미끄러짐 같은 증거를 먼저 확인해야 하고, 증거가 없으면 게이트가 이 원인을 차단하고 VLM의 재추론을 유도합니다. 앞서 본 “환경에 원인을 과도하게 돌리는” 오류를 구조적으로 막는 장치입니다. 이 구조는 SOTIF 기반 위험 분석에서 착안한 것으로, AVOps에서의 경험이 연구 설계에 적용된 지점입니다.
다섯 단계 중 앞의 두 단계, 즉 키프레임과 행위 주체 정보를 제공했을 때의 성능 개선은 다음과 같습니다. 두 단계만으로도 뚜렷한 개선이 나타났습니다.
| 조건 | 사고 원인 정확도 | 기준선 대비 |
|---|---|---|
| 기준선 (DRIVE) | 71.58% | — |
| + 키프레임 | 76.84% | +5.26 |
| + 행위 주체 | 77.89% | +6.32 |
| + 키프레임 & 행위 주체 | 78.95% | +7.37 |
두 단계를 합쳤을 때의 개선 폭이 개별 개선 폭의 합보다 작다는 점이 흥미로웠습니다. 키프레임이 정확히 잡히면 그 시점의 중요한 행위 주체가 이미 시각적으로 두드러지기 때문에, 주체를 명시하는 효과가 그만큼 줄어드는 것으로 해석됩니다.
이 결과를 정리한 논문 Beyond Prompting: Structured Causal Chain Reasoning for VRU Accident Understanding in Vision Language Models는 CVPR 2026의 자율주행 워크숍인 AUTOPILOT에 채택되었습니다.
4. 두 번째 연구: Look or Read, VLM은 무엇을 근거로 판단하는가
첫 번째 연구가 VLM의 사고 이해 성능을 높이는 파이프라인을 구축하는 일이었다면, 두 번째 연구는 그 VLM이 내부적으로 어떻게 판단하는지를 분석하는 일이었습니다.
검출 결과를 텍스트로 함께 제공하는 파이프라인에서 VLM은 두 종류의 정보를 받습니다. 영상 프레임의 픽셀(영상 채널)과, 검출기가 찾아낸 내용을 옮긴 문장(텍스트 채널)입니다. 두 채널이 서로 다른 형태로 같은 장면을 기술하는 만큼, 모델이 실제로 어느 쪽에 의존해 답하는지는 정확도만으로는 알 수 없습니다. 이 구분은 실무적으로도 중요합니다. 성능이 같은 두 파이프라인 중 어느 쪽을 차량에 올릴지, 카메라와 검출기 중 무엇을 먼저 개선할지 결정하려면 답이 어디에서 나왔는지를 알아야 하기 때문입니다.
행동과 내부 메커니즘, 세 가지 분석
모델이 사고를 이해할 때 어느 정보에 의존하는지 파악하기 위해, 저희는 겉으로 드러나는 행동과 Transformer 내부의 메커니즘을 나누어 살펴보는 세 가지 분석을 제안했습니다.
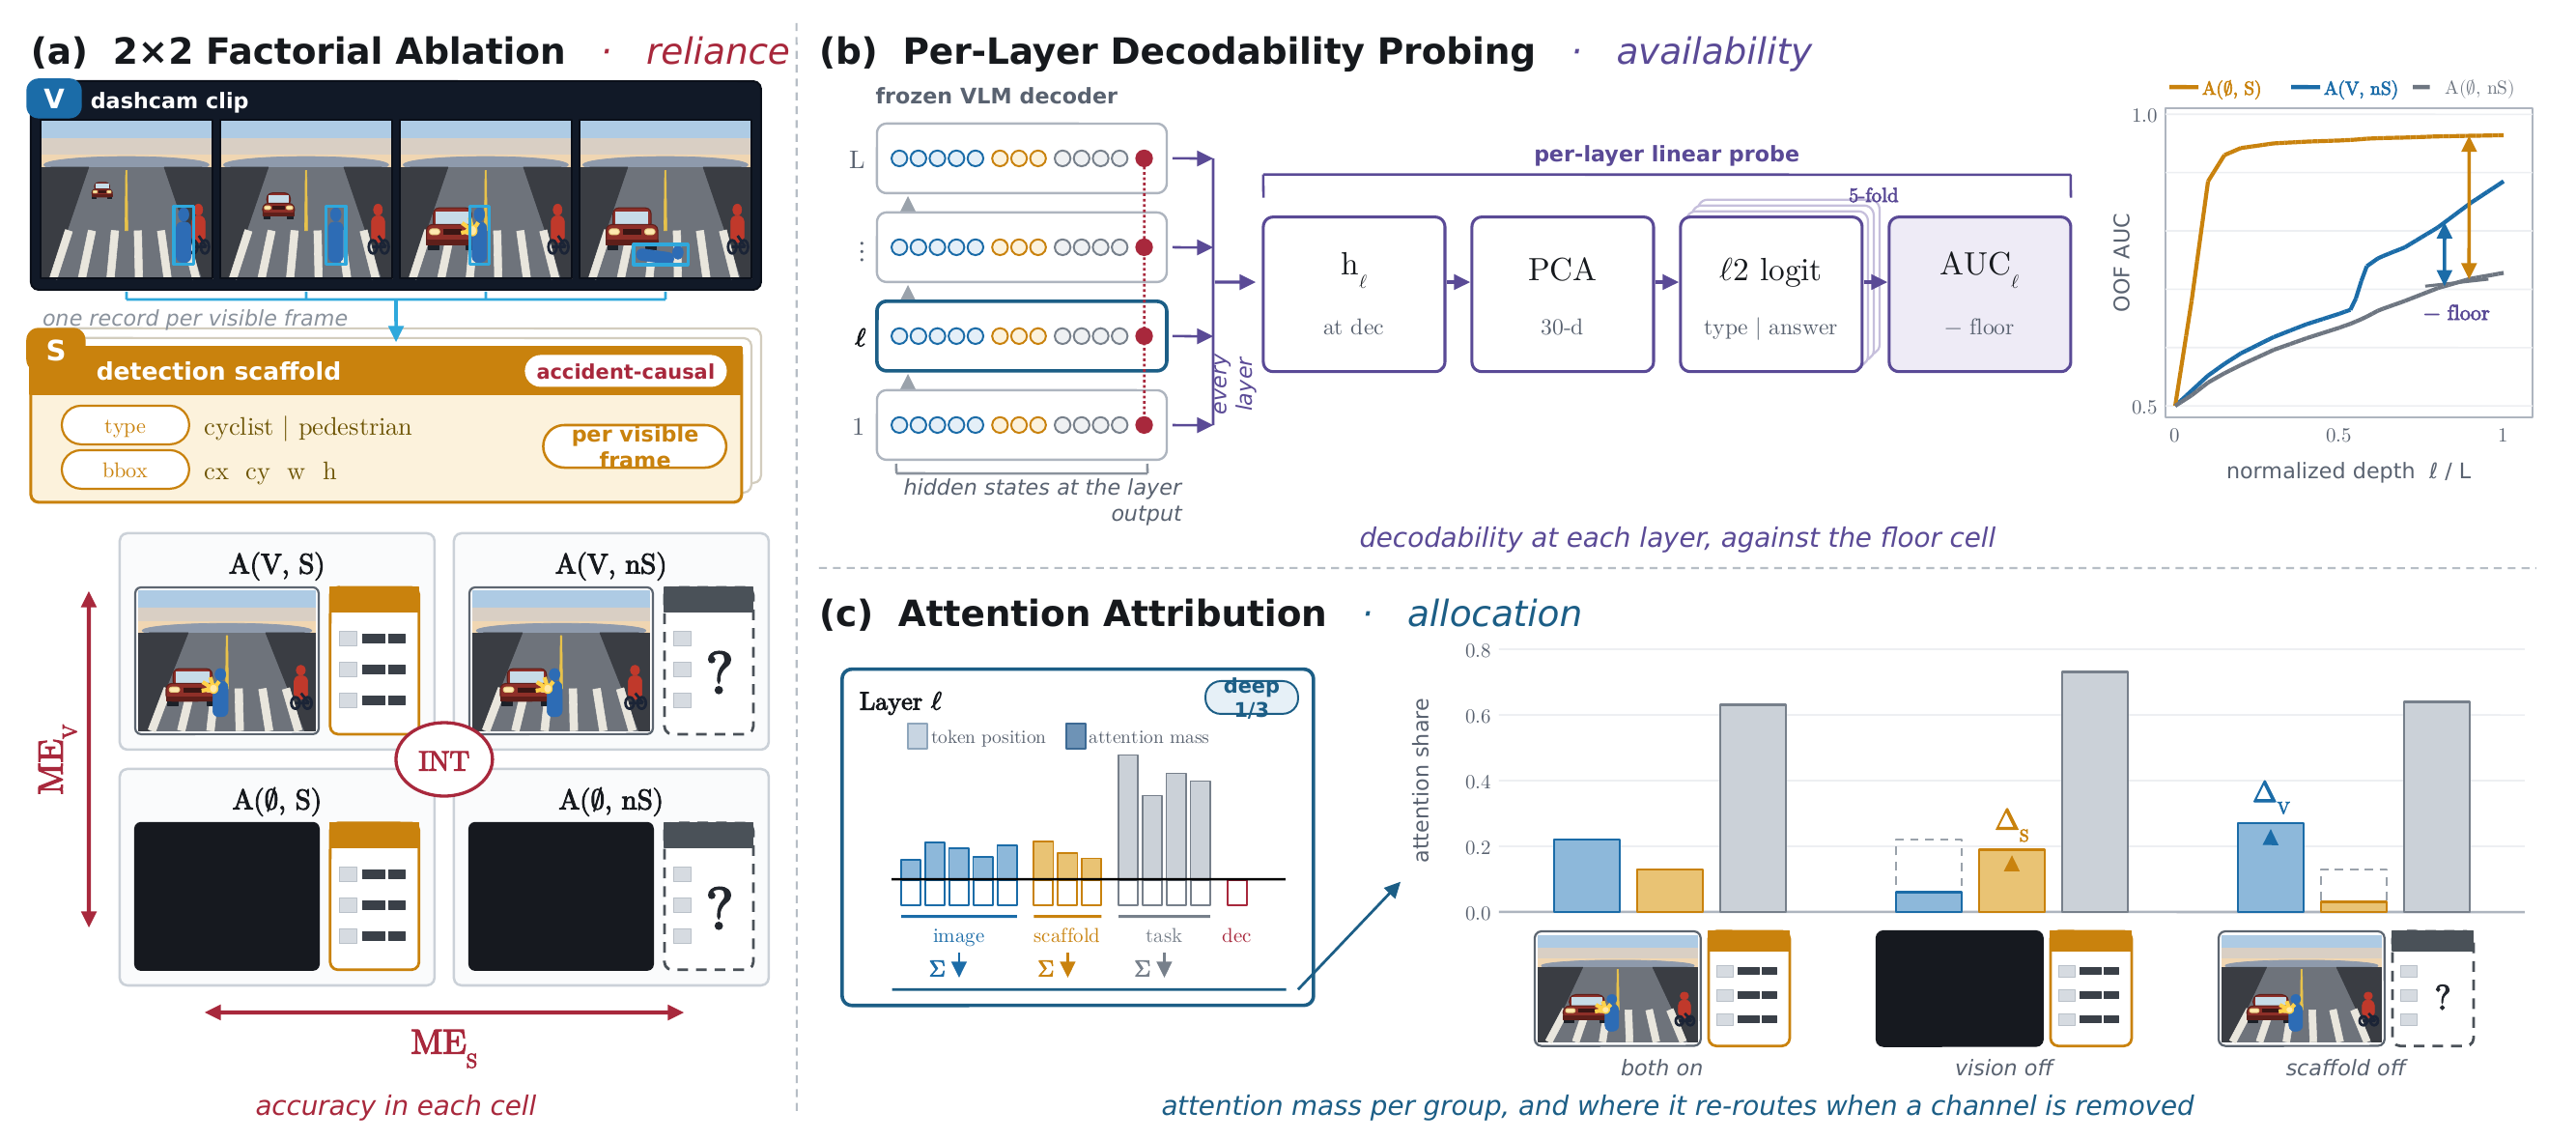
그림 6. 세 가지 분석의 구조: (a) 2×2 요인 제거 실험, (b) 깊이별 프로빙, (c) 어텐션 귀인
- 2×2 요인 제거 실험 (행동) — 영상과 텍스트 채널을 각각 켜고 끄는 네 가지 조합에서 정답률을 측정합니다. 영상을 끌 때는 프레임을 검은 화면으로 바꾸고, 텍스트를 끌 때는 검출 값만 물음표로 가립니다. 각 채널이 정답률에 미친 효과와 두 채널의 상호작용을 계산할 수 있습니다.
- 깊이별 프로빙 (내부) — 모델이 답을 내기 직전 토큰의 은닉 상태(hidden state)를 층마다 추출하고, PCA로 차원을 줄인 뒤 로지스틱 회귀로 “이 층에서 정답을 읽어낼 수 있는가”를 측정합니다. 어느 깊이에서 정보가 읽히기 시작하는지 확인하는 방법입니다.
- 어텐션 귀인 (내부) — 같은 토큰의 어텐션이 영상 토큰, 검출 텍스트, 질문 텍스트 중 어디에 얼마나 실리는지, 그리고 한 채널을 없앴을 때 어디로 옮겨가는지 측정합니다.
세 분석 모두 같은 클립, 동일한 프롬프트, 동일한 채널 on/off 조합에서 수행한 것이 핵심입니다. 그래야 세 관점이 같은 답을 주는지, 서로 다른 답을 주는지를 직접 비교할 수 있습니다.
주요 발견
이 분석을 5개의 VLM과 두 개의 사고 이해 벤치마크에 적용한 결과, 다음 세 가지를 확인했습니다.
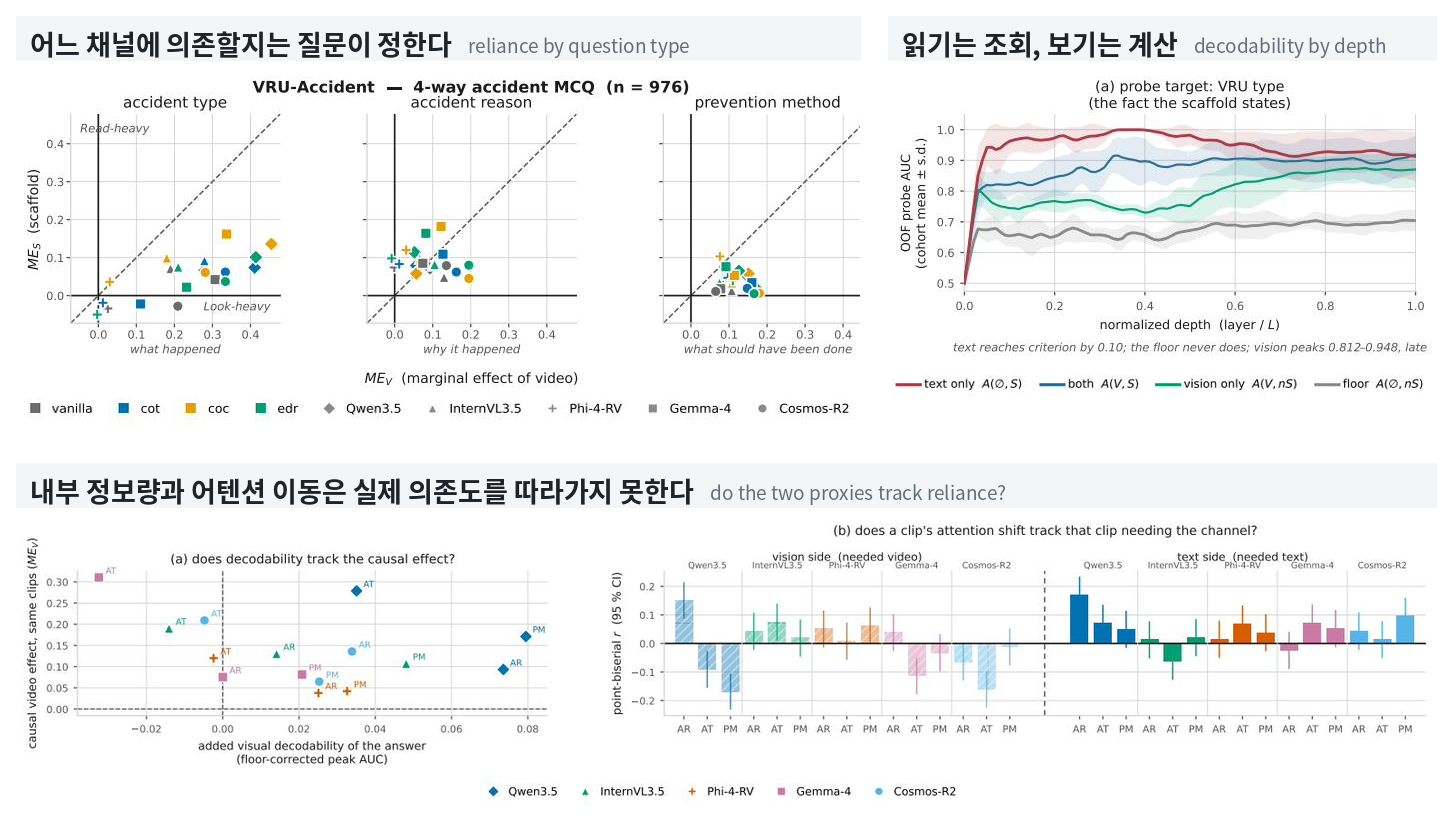
그림 7. 질문별 채널 의존도(상단 좌), 깊이별 디코딩(상단 우), 대리 지표 검증(하단)
모델이 영상을 볼지 텍스트를 읽을지는 질문이 정합니다. 같은 클립, 같은 프롬프트, 같은 모델을 두고도 “어떤 사고가 일어났는가”를 물으면 영상 채널의 영향이 텍스트 채널보다 약 5배 컸지만, “왜 일어났는가”를 물으면 두 채널이 대등해졌습니다. 이 패턴은 모델을 바꾸어도 벤치마크를 바꾸어도 유지되었습니다. 흔히 “이 모델은 시각 정보를 잘 활용한다”처럼 모델의 성질로 이야기하지만, 실제로는 질문에 따라 달라지는 것입니다.
검출 텍스트는 성능을 더하는 장치라기보다 보험에 가깝습니다. 두 채널의 효과는 더해지기보다 서로를 대체하는 쪽에 가까웠습니다. 텍스트 채널이 정답률에 기여하는 크기는 영상이 정상일 때보다 영상을 검은 화면으로 가렸을 때 약 4배 컸습니다. 카메라가 제대로 작동할 때 텍스트 채널은 작은 이득을 더하는 정도지만, 카메라 정보가 사라졌을 때는 손실을 크게 메워줍니다. 카메라 정보가 불완전한 상황을 대비하는 안전장치로서 검출 텍스트의 역할이 분명해진 것입니다.
읽기는 조회이고, 보기는 계산입니다. 깊이별 프로빙 결과, 텍스트로 들어온 사실은 네트워크 깊이의 앞쪽 10% 안에서 이미 읽어낼 수 있었습니다. 반면 같은 사실을 픽셀에서 읽어내는 정확도는 네트워크의 거의 끝까지 계속 올라갔습니다. 텍스트는 이미 정리된 답을 조회하는 것에 가깝고, 영상은 층을 거치며 답을 계산해 나가는 과정이었습니다. 정리하면, 모델은 답에 더 빨리 닿는 쪽을 택합니다. 질문이 요구하는 정보가 텍스트에 그대로 적혀 있으면 읽고, 영상을 봐야만 알 수 있으면 봅니다. 첫 번째 발견에서 질문에 따라 우세한 채널이 달라진 이유가 여기에 있습니다.
이 결과가 말해주는 것은 세 관점이 서로를 대체할 수 없다는 점입니다. 어텐션은 모델이 어디를 보는지를, 프로빙은 어떤 정보가 내부에 있는지를 알려주지만, 답이 무엇에 의존했는지는 실제로 채널을 껐을 때의 변화로만 확인할 수 있었습니다. 세 관점을 같은 조건에서 함께 읽어야 모델의 판단 근거를 온전히 이해할 수 있습니다. 이 연구는 현재 top-tier 컨퍼런스 투고를 준비하며 다듬고 있습니다.
5. 마치며
돌아보면 플랫폼에서 원천기술로 넘어간 것은 거창한 계획이 아니라 엔지니어로서의 호기심에서 시작된 일이었습니다. 직접 만든 플랫폼이 “이 장면이 위험한가”를 어떻게 판단하는지 궁금했고, 그 궁금증을 따라가다 보니 모델의 추론 구조를 다시 설계하게 되었고, 이어서 그 판단의 근거까지 들여다보게 되었습니다. 이런 시도를 사이드 프로젝트로 이어갈 수 있었던 것은 새로운 기술을 먼저 찾아보고 공유하는 팀의 문화 덕분이기도 합니다.
그 과정에서 글로벌 협업과 국제 학회라는 무대에서 저희의 엔지니어링 역량을 검증받는 경험도 얻었습니다. 사업 이행 조직이 원천기술 연구까지 다룰 수 있다는 것을 작게나마 보여준 사례가 되었기를 바랍니다.
고객의 AX 요구가 다각화되는 만큼 사업 이행과 원천기술 연구는 점점 떼어놓기 어려워지고 있습니다. 앞으로도 자율주행과 Physical AI 영역에서 다양한 연구·개발 활동을 이어가려 합니다.
읽어주셔서 감사합니다.
참조
[1] Microsoft Learn, Reference architecture for autonomous vehicle operations (AVOps). https://learn.microsoft.com/en-us/industry/mobility/architecture/ra-mobility-avops
[2] ISO 21448:2022, Road vehicles — Safety of the intended functionality (SOTIF).
[3] AUTOPILOT Workshop @ CVPR 2026. https://www.autopilot-cvpr.net/