
KT Evidence Unit과 Document AI 연구 동향
먼저, 이 글의 전체 흐름
| 장 |
내용 |
|---|---|
| 1장 |
ICDAR 2026 학회 소개 및 주요 연구 분야 |
| 2장 |
키노트가 제시한 Document AI의 방향 |
| 3장 |
KT 연구 성과 소개 |
| 4장 |
현장에서 확인한 최신 연구 동향 |
이 글이 다루려는 질문은 하나입니다.
"파싱을 아무리 잘해도 생성형 AI의 답변이 틀리는 이유는 무엇인가?"
결론부터 말씀드리면, 원인은 파서의 정확도 뿐만 아니라 파싱 결과를 검색 단위로 묶는 방식에 있었습니다. 이 글을 다 읽으시면 (1) 요소 단위 청킹이 왜 구조적으로 오답을 만드는지, (2) 다양한 파서에서 흔들리지 않는 청킹을 어떻게 설계했는지, (3) 그 결과 검색·답변 품질이 각각 얼마나 향상됐는지를 구체적인 수치와 함께 확인하실 수 있습니다.
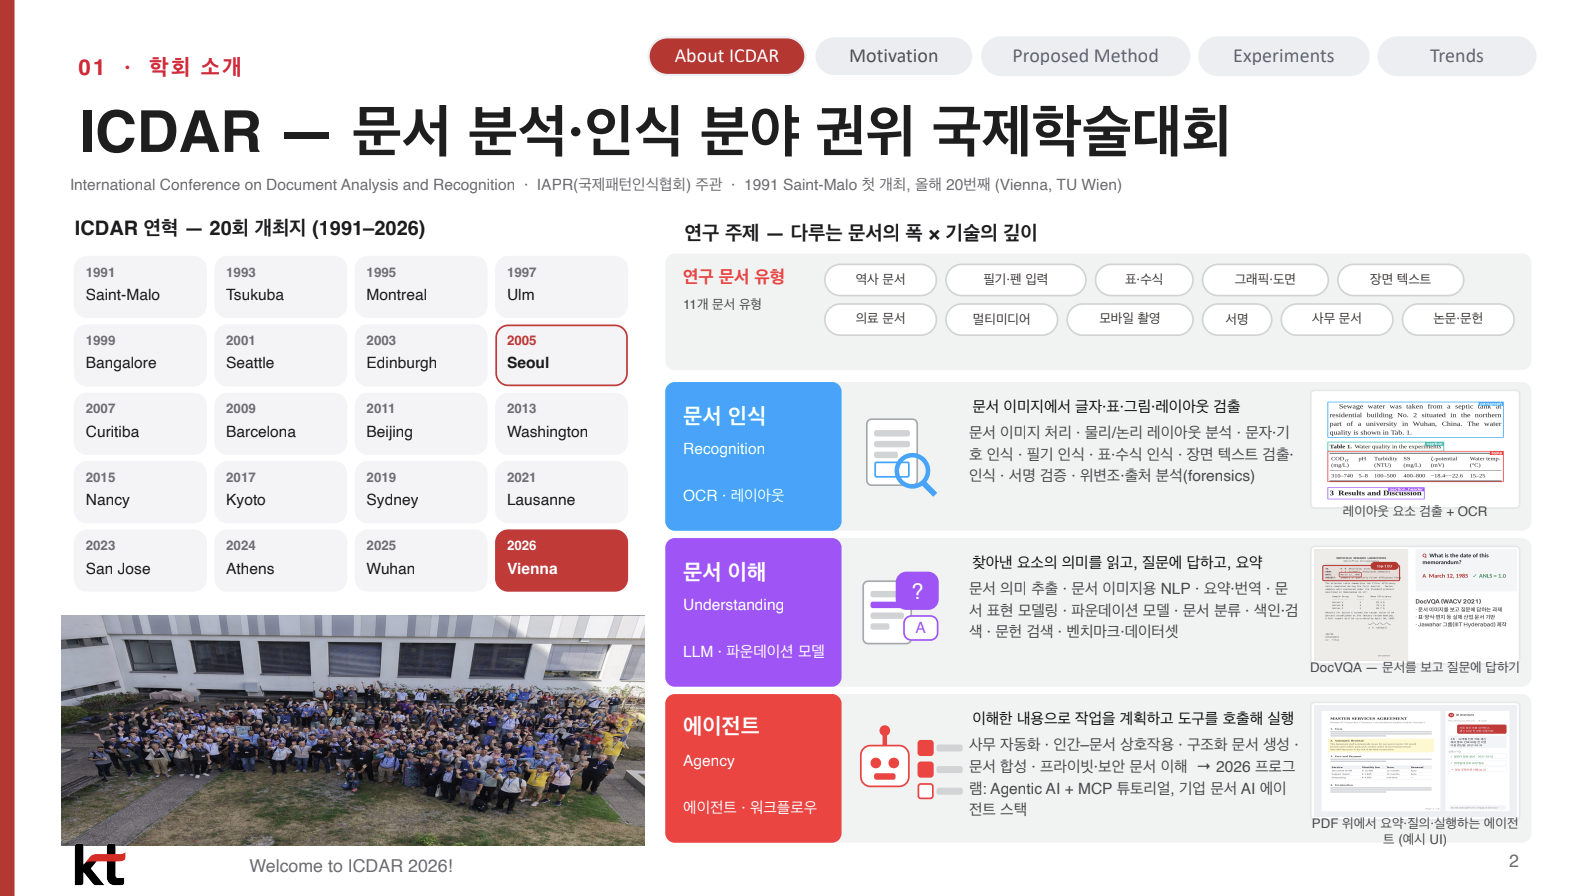
1. 학회 소개 — ICDAR 2026 @ TU Wien
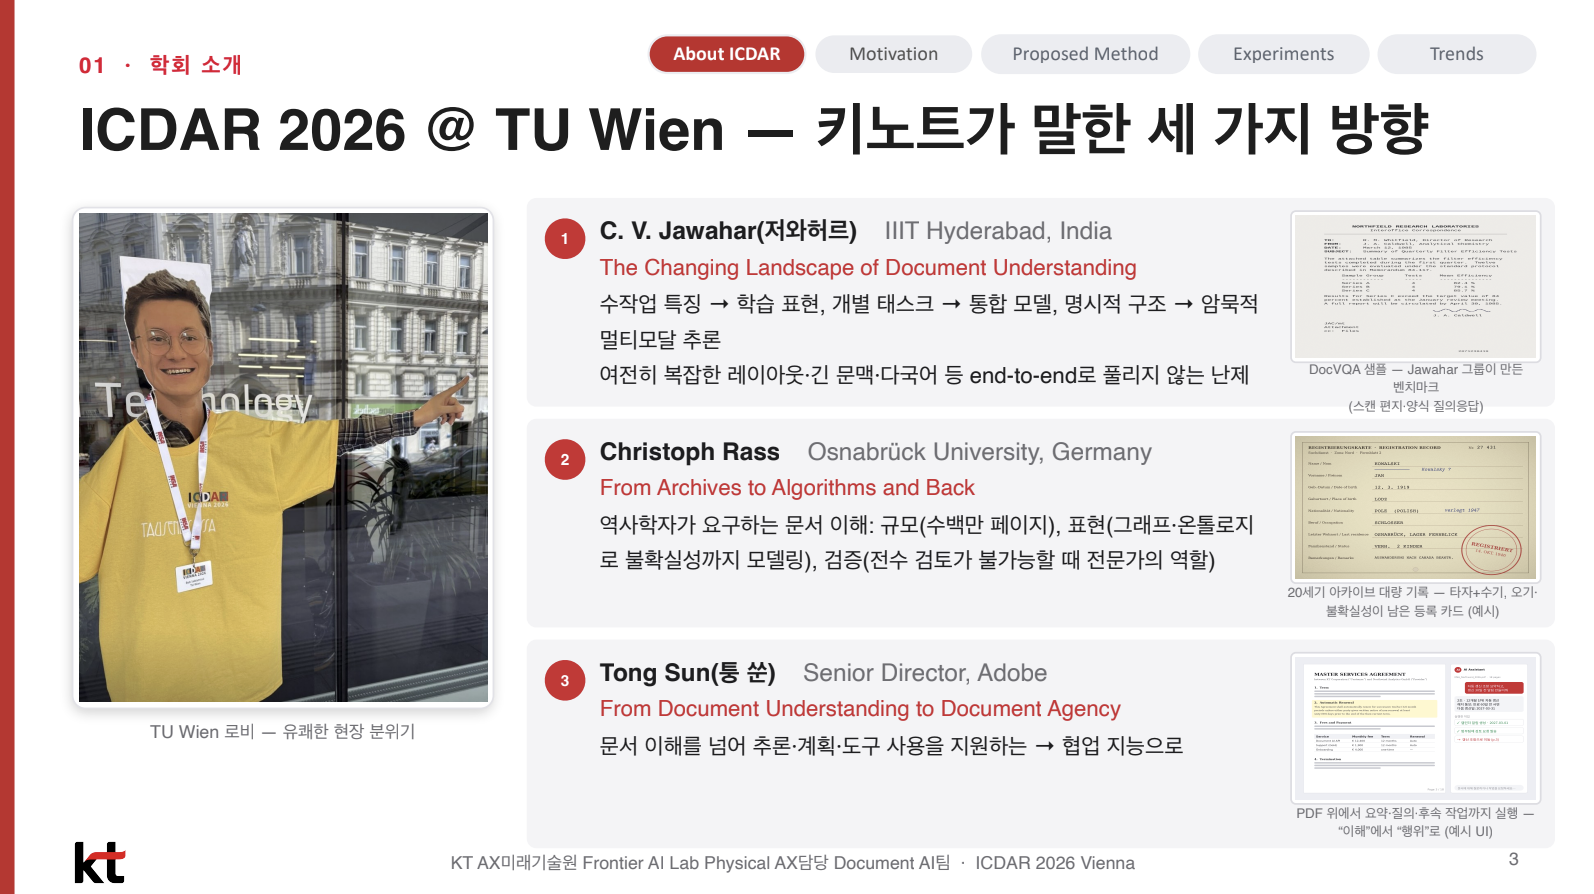
2. 키노트가 제시한 Document AI의 방향
3. KT 발표 논문 — Ontology-grounded Chunking for Parser-Independent Retrieval
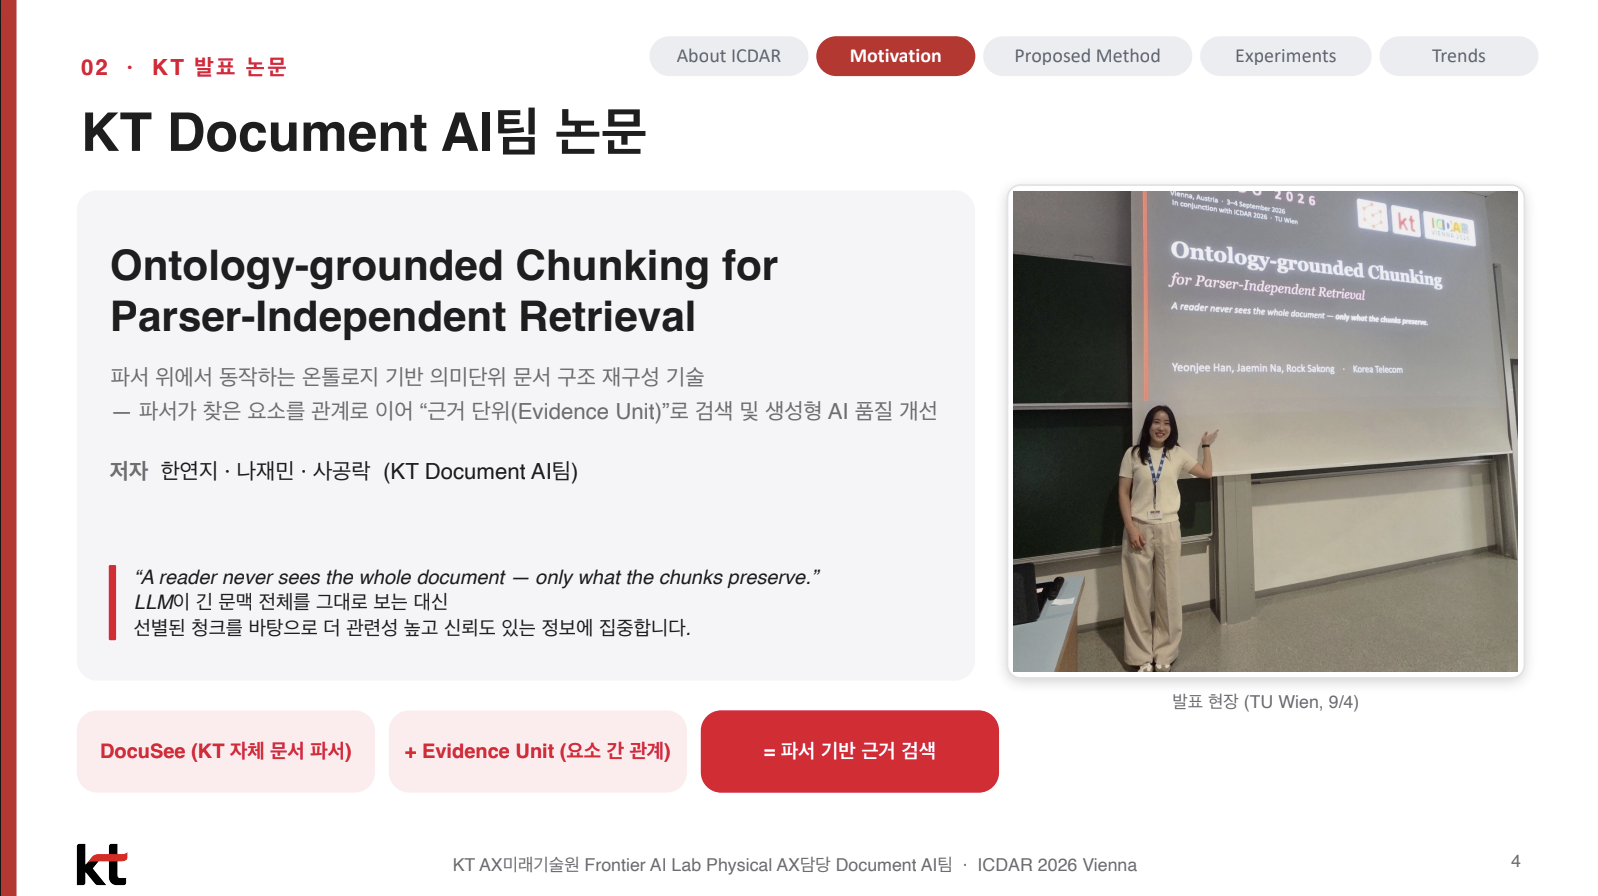
"A reader never sees the whole document — only what the chunks preserve." 리더(LLM)는 문서 전체를 보지 않습니다. 청크가 보존한 것만 봅니다.
저자: 한연지 · 나재민 · 사공락 (KT Frontier AI Lab Physical AX담당)
한 줄 요약: 파서 위에서 동작하는 온톨로지 기반 의미단위 문서 구조 재구성 기술 — 파서가 찾은 요소를 관계로 이어 근거 단위(Evidence Unit) 로 검색합니다.
3-1. 연구 배경 ① — 의미 파편화(semantic fragmentation)
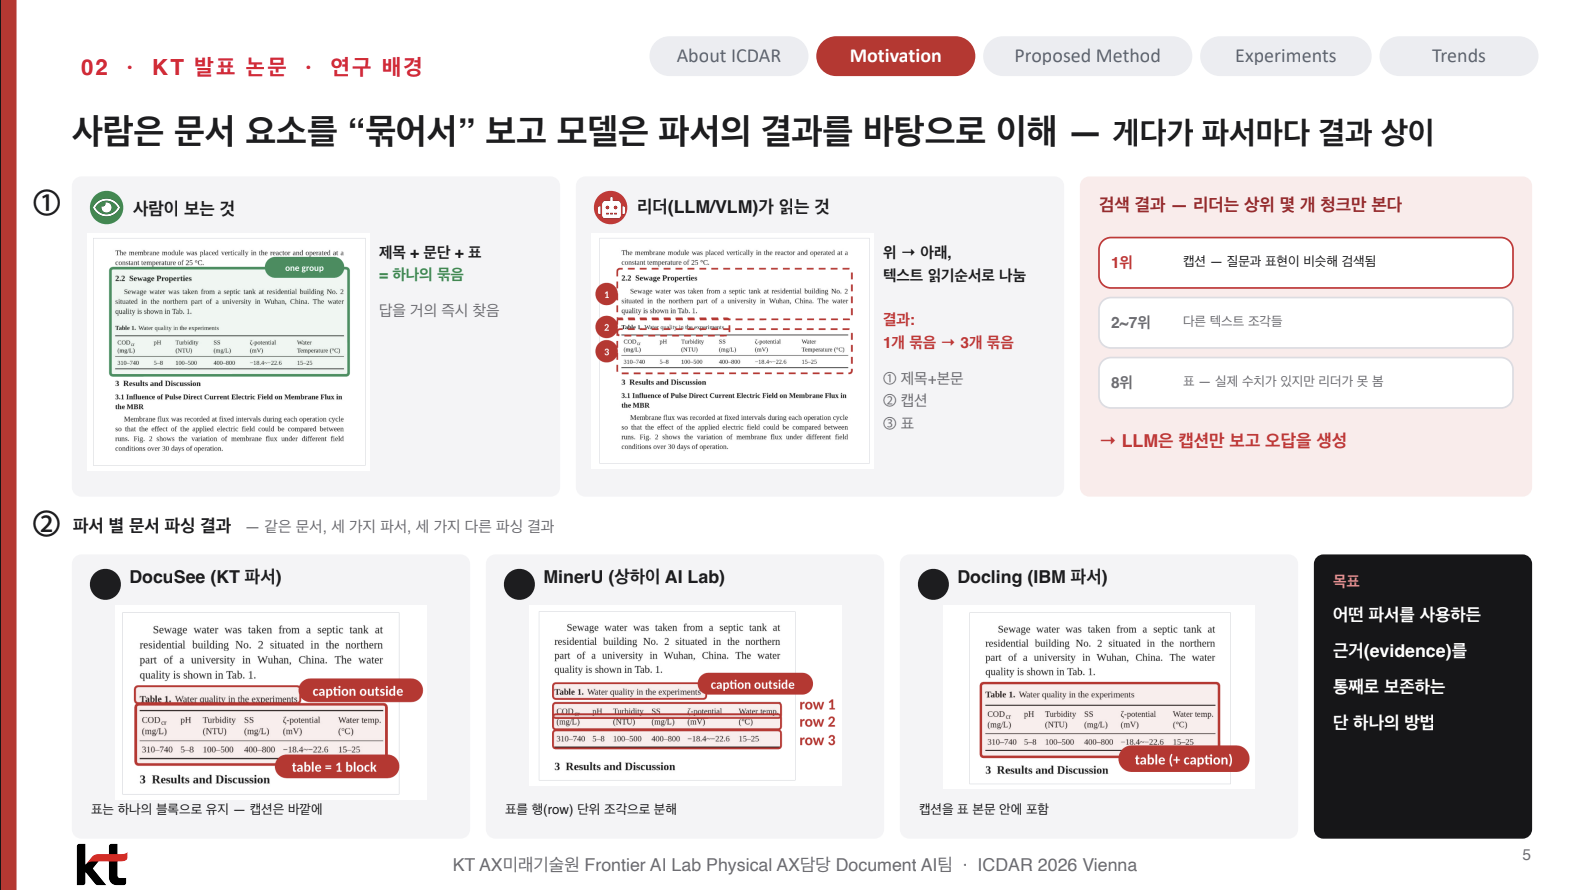
사람은 문서에서 "실험에 사용한 수질 조건"을 찾을 때 제목 +본문 + 표를 한 덩어리로 보고 거의 즉시 답을 찾습니다. 반면 파서 출력을 그대로 청킹하면 하나의 영역을 여러개로 쪼갤 수 있습니다.
쪼개진 청킹의 문제는 검색 단계에서 나타납니다. 질문 "What were the water quality conditions used in the experiments?" 를 하면, 리더(LLM or VLM)는 top-k(보통 3)만 봅니다. 그래서 캡션만 읽고, 정답인 수치는 보지 못한 채 답을 생성합니다. 정답이 문서 안에 분명히 있는데도 도달 불가능(answer unreachable) 한 상태가 되는 것이죠. 파싱은 완벽했지만 청킹이 근거를 끊어 놓은 경우입니다.
3-2. 연구 배경 ② — 파서마다 다른 출력
또 다른 문제는 한 파서에 맞춰 튜닝한 청커가 다른 파서에서는 동작하지 않는다는 점입니다. 같은 문서를 세 파서에 넣으면 결과가 이렇게 갈립니다.
| 파서 |
표 처리 방식 |
캡션 처리 |
|---|---|---|
| DocuSee (KT 자체 파서) |
표를 하나의 블록으로 유지 |
표 바깥에 분리 |
| MinerU (상하이 AI Lab) |
표를 행(row) 단위 조각으로 분리 |
표 바깥에 분리 |
| Docling (IBM) |
표를 하나의 블록으로 유지 |
캡션을 표 본문 안에 포함 |
같은 페이지인데 청크 경계가 세 파서 모두 다릅니다. 여기서 연구 목표가 정해졌습니다.
3-3. 제안 방법 — Evidence Unit(EU)
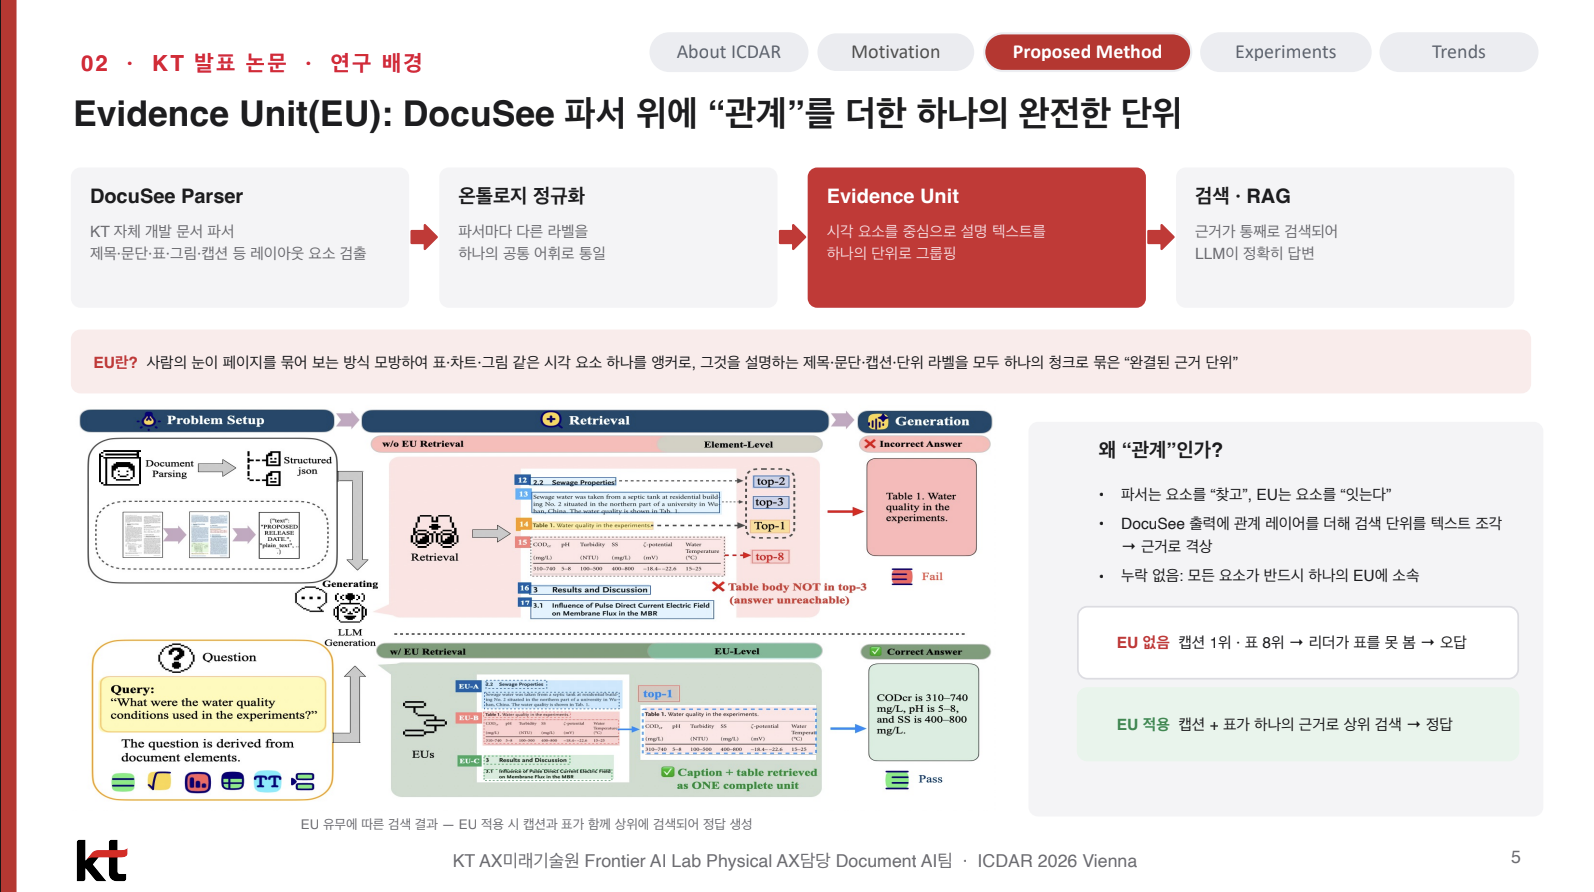
Evidence Unit(EU)은 사람의 눈이 페이지를 묶어 보는 방식을 모방해, 표·차트·그림 같은 시각 요소 하나를 앵커로 두고 그것을 설명하는 제목·문단·캡션·단위 라벨을 모두 하나의 청크로 묶은 "완결된 근거 단위" 입니다. 핵심은 파서를 교체하는 것이 아니라 파서 출력 위에 관계(relation) 레이어를 한 겹 올리는 것입니다.
설계 원칙은 세 가지입니다.
- 파서는 요소를 "찾고", EU는 요소를 "잇는다" — 역할을 분리합니다.
- 검색 단위를 텍스트 조각에서 근거로 재구성합니다.
- 누락 없음 — 모든 요소는 반드시 정확히 하나의 EU에 소속됩니다.
3-4. 1단계 — 역할 정규화(Normalization)
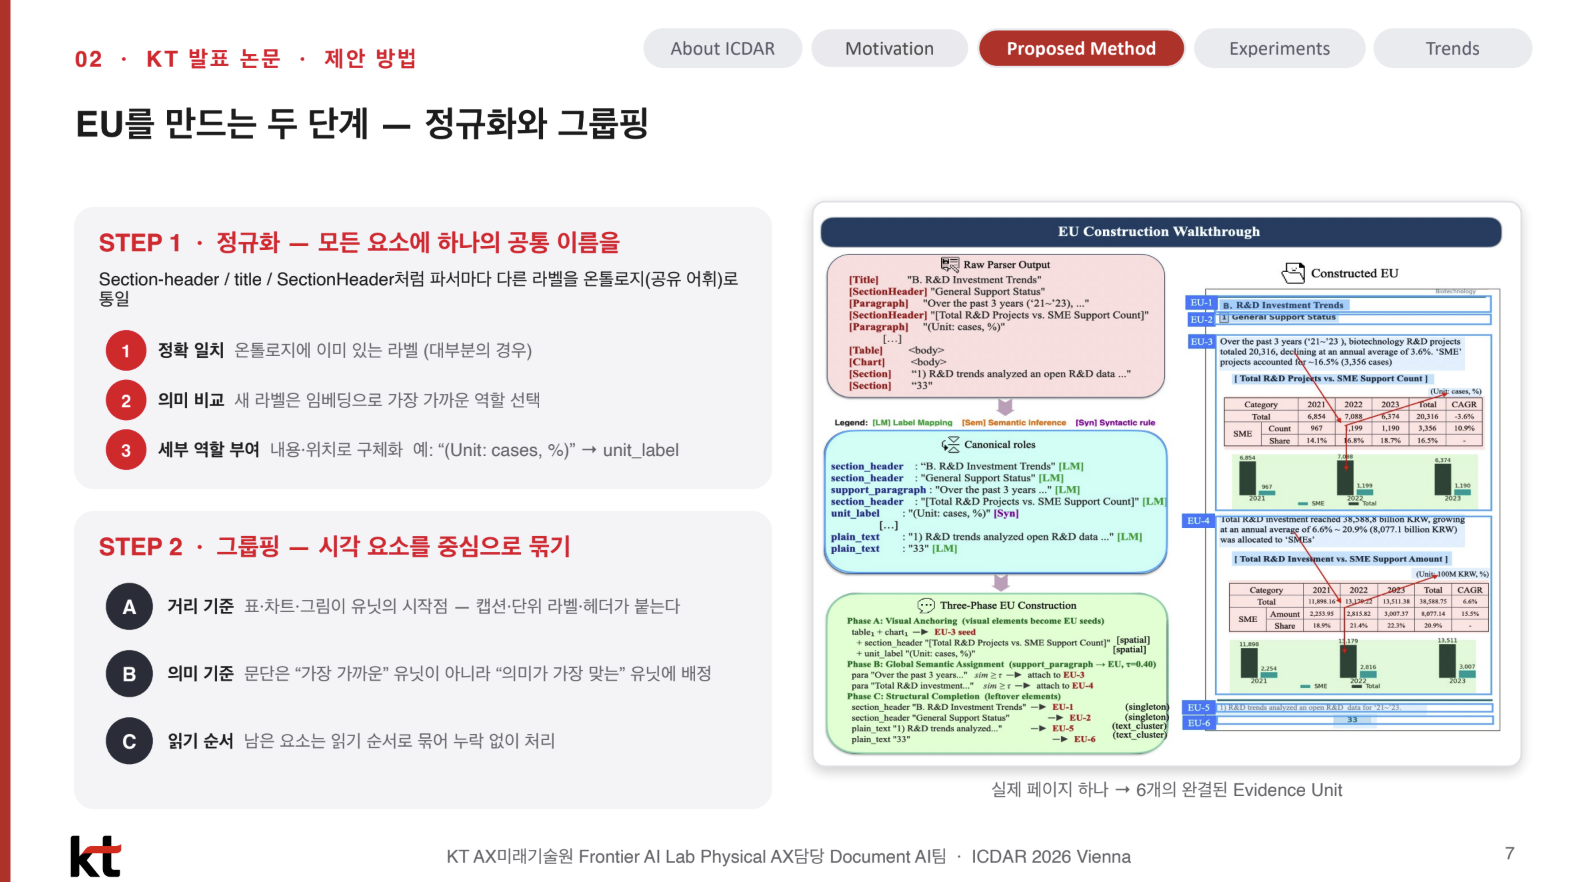
- 정확 매칭 — DSO 온톨로지의 skos:altLabel을 조회합니다. 대부분의 요소가 여기서 커버됩니다.
- 의미 추론 — 온톨로지에 없는 새 라벨은 임베딩으로 가장 가까운 역할에 매칭합니다 (cos ≥ 0.80).
- 내용 기반 보정 — 내용과 위치로 역할을 구체화합니다. 예를들어, 표 위에 붙은 짧은 표기 "(Unit: cases, %)" 는 본문(plain_text)이 아니라 unit_label로 재지정됩니다.
3-5. 2단계 — 3-Phase 그룹핑(Grouping)
d_spatial = gapY + diffX < τ ⟹ 같은 Evidence Unit
argmax_j max_k cos(e_para, e_member_k^(j)), τ_sem = 0.40
3-6. 실험 결과
| 지표 |
의미 |
w/o EU |
w/ EU |
변화 Δ |
|---|---|---|---|---|
| Avg LCS (Coverage) |
관련 근거가 얼마나 함께 묶였나 |
0.5006 |
0.7968 |
+59% (상대) |
| Recall@1 |
올바른 근거가 1위로 나오는 비율 |
0.150 |
0.507 |
3.4배 |
| Recall@3 |
0.686 |
0.852 |
+0.166 |
|
| Recall@5 |
0.834 |
0.914 |
+0.080 |
|
| MinK ↓ |
올바른 근거까지 몇 개를 봐야 하나 |
2.58 |
1.74 |
-33% |
B. 다양한 파서 — 세 파서 모두 같은 방향으로 개선
| 트랙 |
ΔLCS |
ΔR@1 |
ΔMinK |
|---|---|---|---|
| 어노테이션(정답 레이아웃) |
+0.30 | +0.36 | −0.84 |
| Docling |
+0.23 | +0.30 |
-0.82 |
| MinerU | +0.26 |
+0.38 |
-0.91 |
| DocuSee |
+0.28 |
+0.38 |
-0.96 |
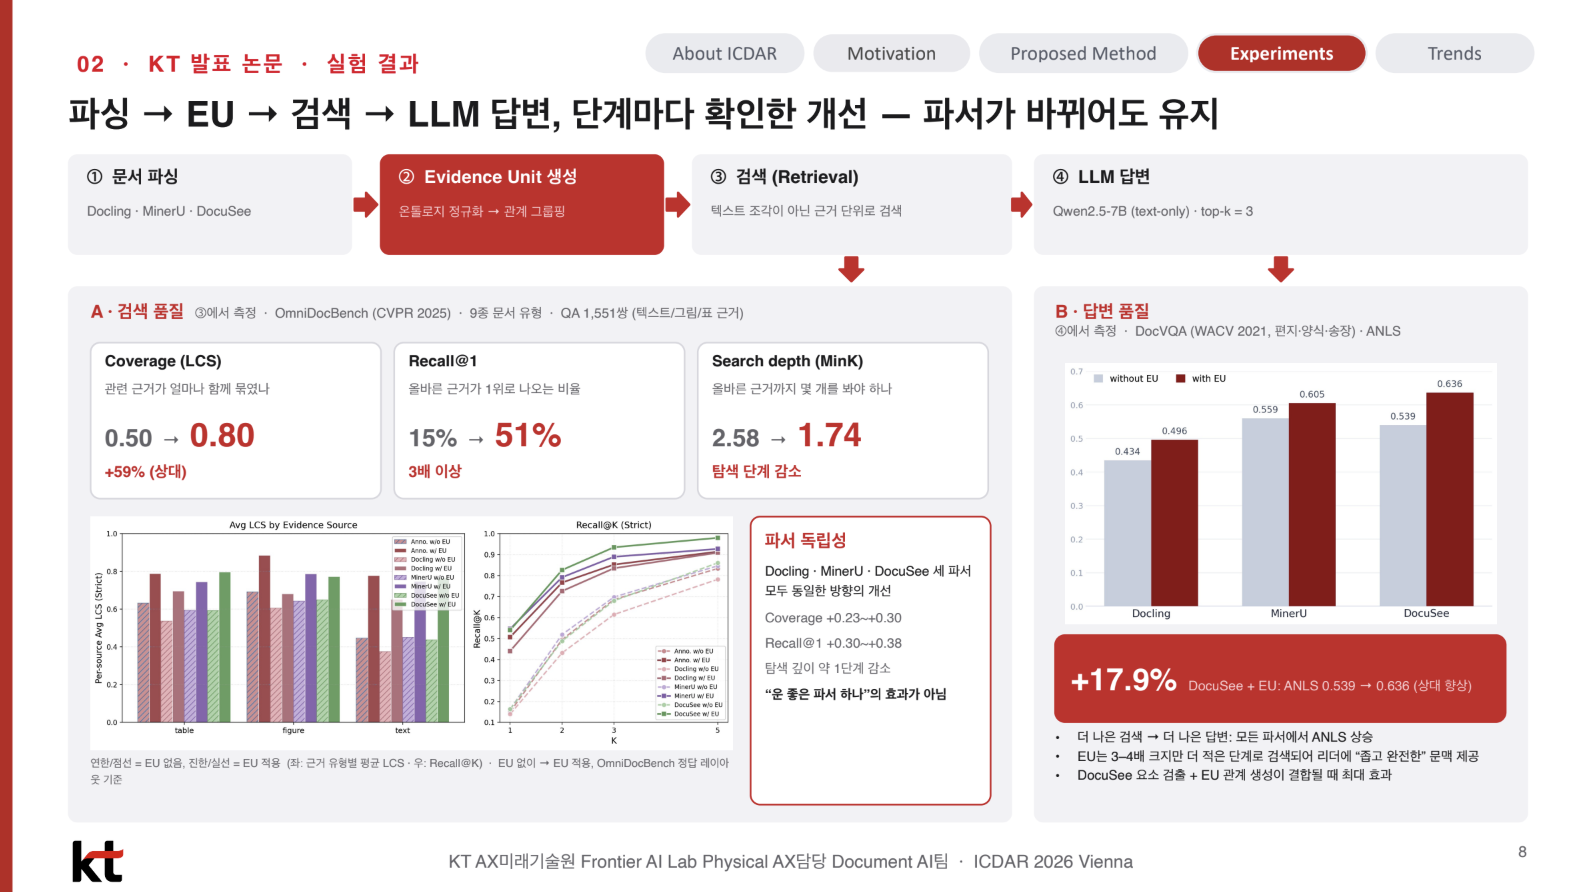
정답 레이아웃뿐 아니라 실제 파서 세 개 모두에서 향상 폭이 유지되었습니다. "운 좋게 파서 하나"의 효과가 아니라 Evidence Unit 구축 자체의 효과라는 의미입니다.
C. End-to-End 답변 품질 — DocVQA(WACV 2021, 편지·양식·송장), ANLS
| 파서 |
w/o EU |
w/ EU |
상대 향상 |
|---|---|---|---|
| Docling |
0.434 |
0.496 |
+14.3% |
| MinerU |
0.559 |
0.605 |
+8.2% |
| DocuSee |
0.539 |
0.636 |
+17.9% |
Evidence Unit 적용 후 세 파서 모두에서 End-to-End 답변 품질이 향상되었습니다. 특히 DocuSee는 ANLS가 0.539에서 0.636으로 상승해 17.9%의 가장 큰 상대 향상을 보였습니다. 이는 EU가 검색 단계의 근거 품질 개선에 그치지 않고 최종 LLM 답변 품질 향상까지 이어졌음을 보여줍니다.
4. 현장에서 확인한 4대 연구 트렌드
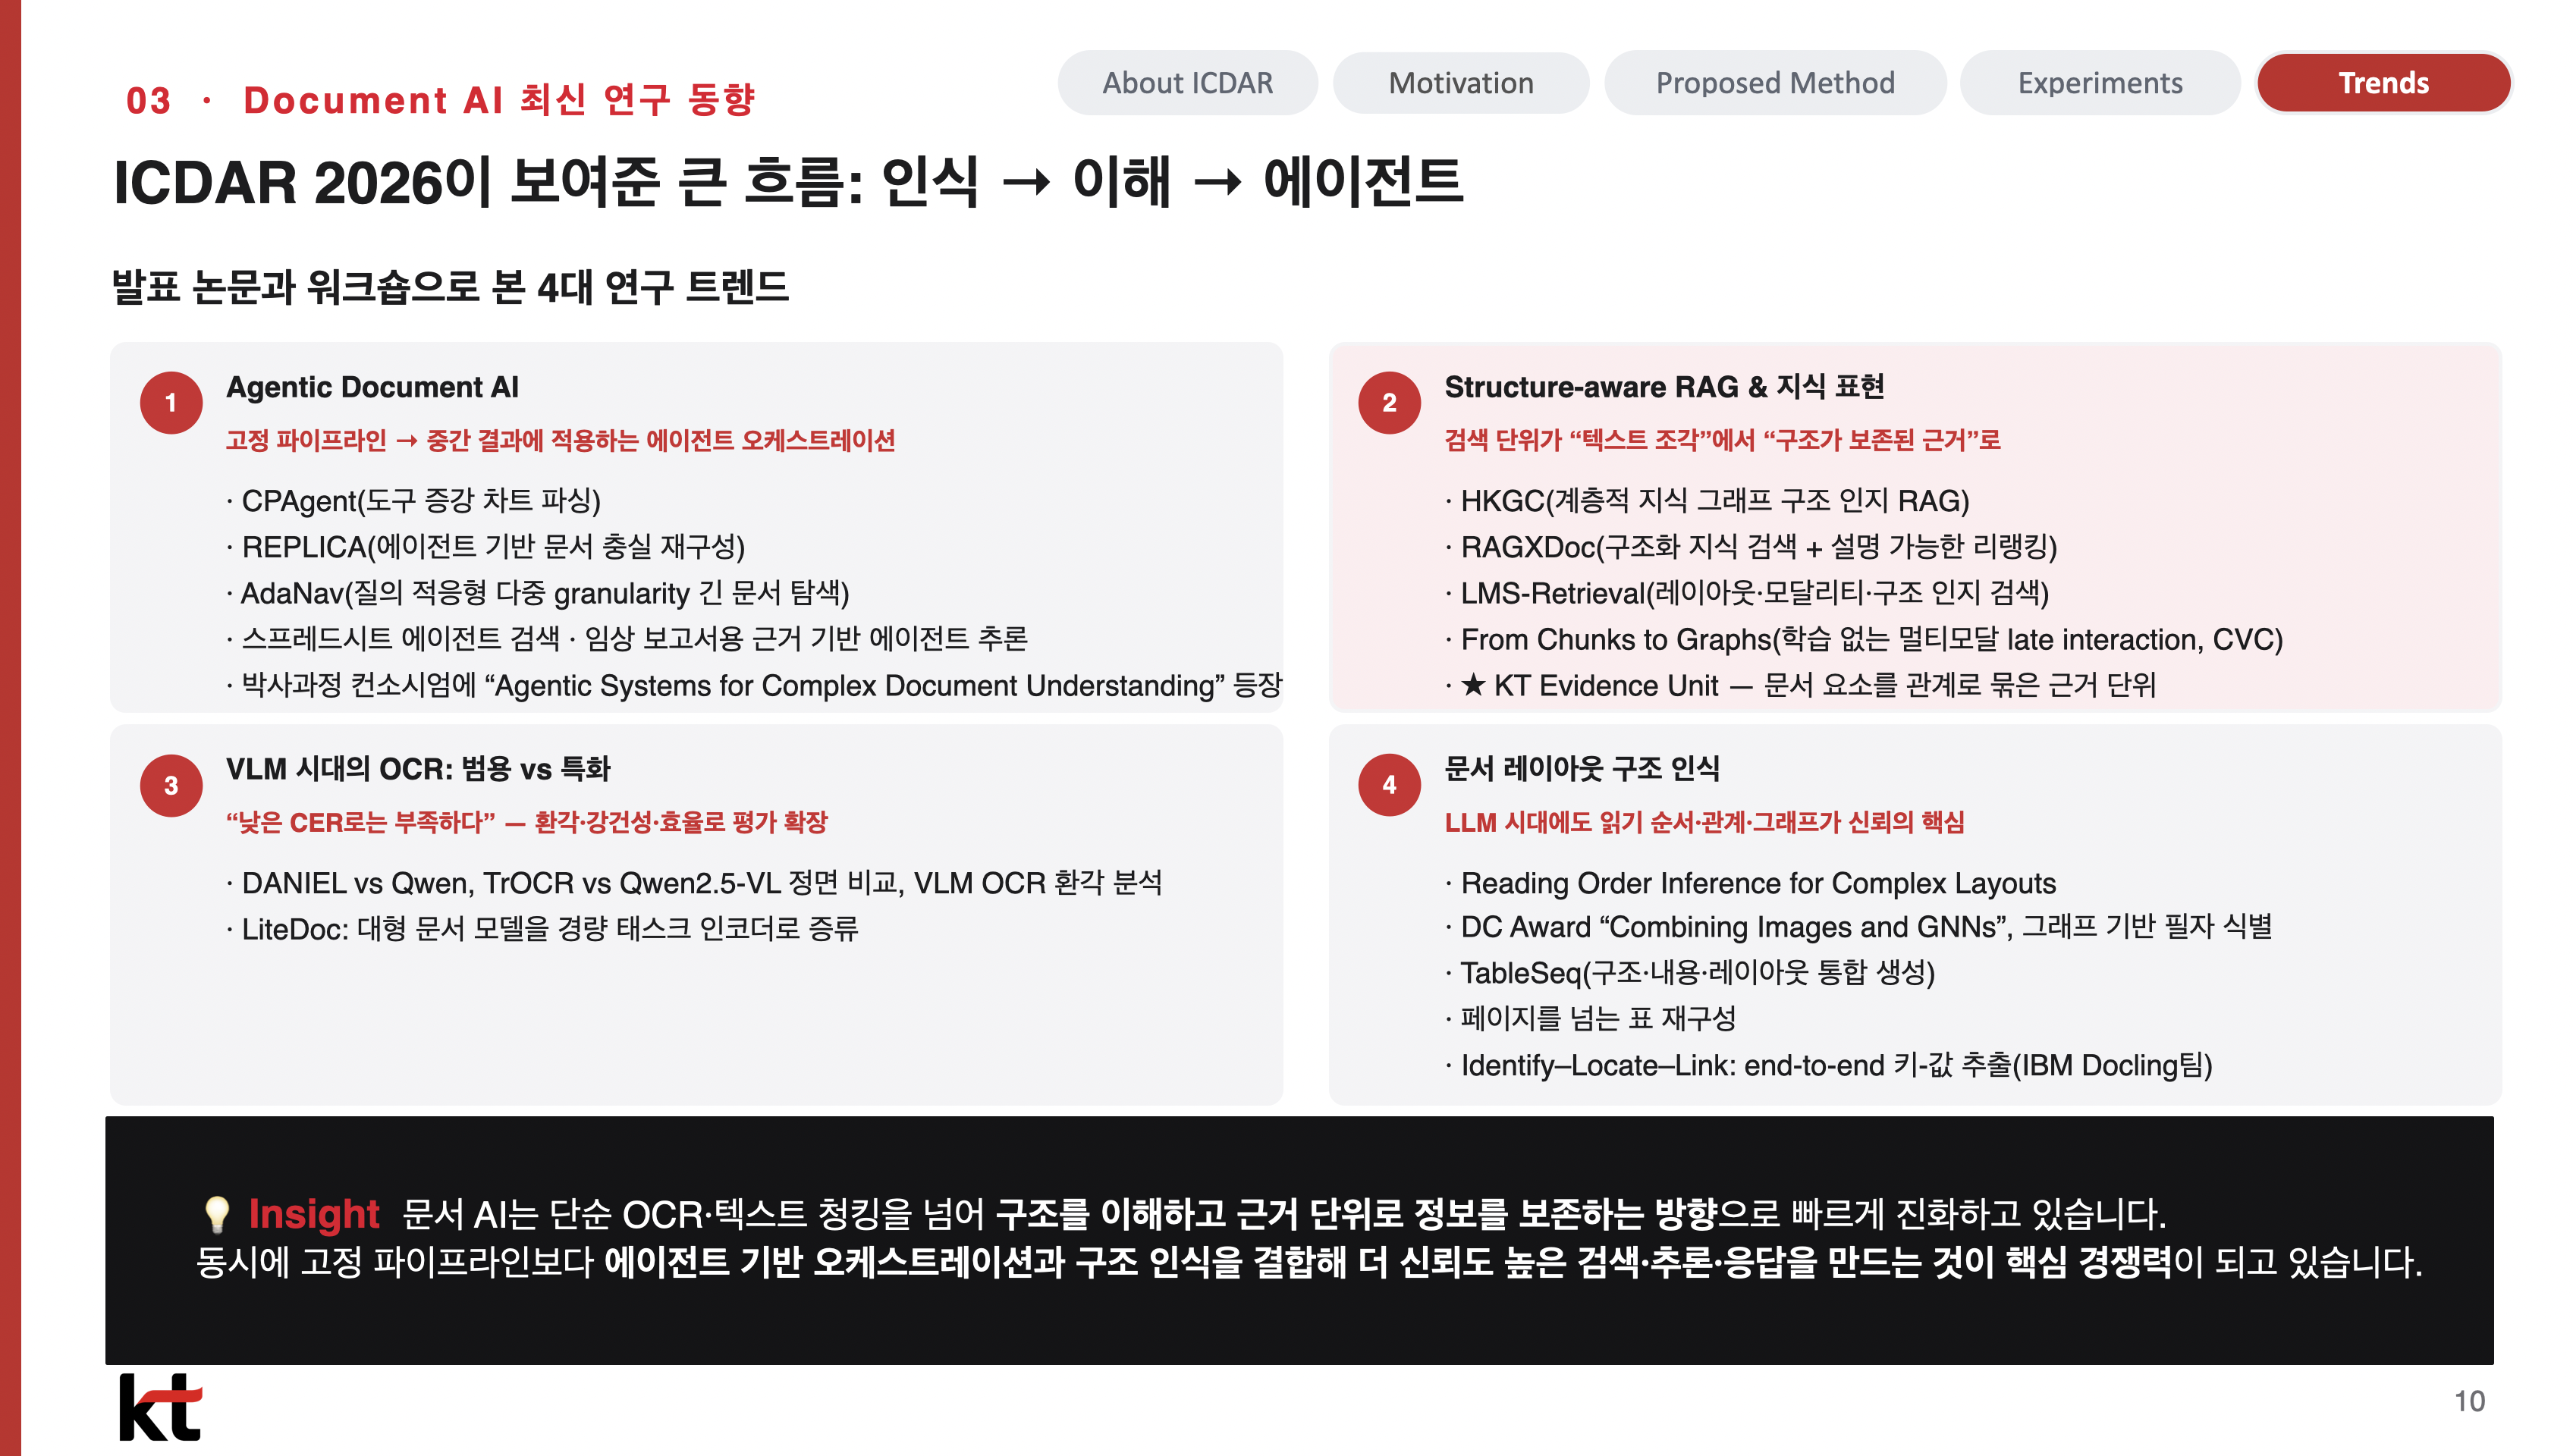
이번 ICDAR 2026을 한 문장으로 요약하면 인식(Recognition) → 이해(Understanding) → 에이전트(Agency) 로의 이동이었습니다. 발표 논문과 워크숍에서 관찰한 네 가지 흐름을 공유드립니다.
① Agentic Document AI — 고정 파이프라인에서 오케스트레이션으로
파싱 → 검색 → 생성과 같은 고정 파이프라인 대신 중간 결과를 보고 다음 행동을 결정하는 에이전트 구조에 대한 연구가 늘었습니다.
- CPAgent — 도구 증강 차트 파싱
- REPLICA — 에이전트 기반 문서 충실 재구성
- AdaNav — 질의 적응형 다중 granularity 긴 문서 탐색
- 스프레드시트 에이전트 검색, 임상 보고서용 근거 기반 에이전트 추론
- 박사과정 컨소시엄에 "Agentic Systems for Complex Document Understanding" 주제 등장
② Structure-aware RAG & 지식 표현 — 검색 단위의 재정의
검색 단위가 "텍스트 조각"에서 "구조가 보존된 근거" 로 옮겨가고 있었습니다. 저희 연구와 가장 가까운 트랙입니다.
- HKGC — 계층적 지식 그래프 구조 인지 RAG
- RAGXDoc — 구조화 지식 검색 + 설명 가능한 리랭킹
- LMS-Retrieval — 레이아웃·모달리티·구조 인지 검색
- From Chunks to Graphs — 학습 없는 멀티모달 late interaction (CVC)
- ★ KT Evidence Unit — 문서 요소를 관계로 묶은 근거 단위
③ VLM 시대의 OCR — 범용 vs 특화
"낮은 CER만으로는 부족하다" 는 문제의식이 공유되면서, 평가축이 환각·강건성·효율로 확장되고 있었습니다.
- DANIEL vs Qwen, TrOCR vs Qwen2.5-VL 정면 비교, VLM OCR 환각 분석
- LiteDoc — 대형 문서 모델을 경량 태스크 인코더로 증류
④ 문서 레이아웃 구조 인식 — LLM 시대에도 구조가 신뢰의 핵심
- Reading Order Inference for Complex Layouts
- DC Award "Combining Images and GNNs" — 그래프 기반 필자 식별
- TableSeq — 구조·내용·레이아웃 통합 생성
- 페이지를 넘는 표 재구성
- Identify–Locate–Link — end-to-end 키-값 추출 (IBM Docling팀)
Insight. 문서 AI는 단순 OCR·텍스트 청킹을 넘어, 구조를 이해하고 근거 단위로 정보를 보존하는 방향으로 빠르게 진화하고 있습니다. 동시에 고정 파이프라인보다 에이전트 기반 오케스트레이션과 구조 인식을 결합해 더 신뢰도 높은 검색·추론·응답을 만드는 것이 핵심 경쟁력이 되고 있습니다.
5. 맺음말과 다음 단계
"A document is not just text to cut — it is evidence to keep together." 문서는 단순히 잘라낼 텍스트가 아니라, 함께 지켜야 할 근거입니다.
- 문서·페이지를 넘는 EU — 상호참조와 인용 연결을 이용해 여러 페이지에 걸친 근거를 하나로 구성
- EU + 크로스인코더 리랭커 — 근거 단위 수준의 정밀 재정렬
- EU 수준 청킹 벤치마크 구축 — 현재는 청킹 품질을 직접 측정할 표준 벤치마크가 없어 LCS·MinK 같은 지표를 자체 정의해 사용했습니다. 이 부분을 공개 가능한 형태로 정리하는 것이 목표입니다.