들어가며
안녕하세요. KT AX사업부문 AX Engineering본부에서 B2B AX 사업 이행(Delivery)을 담당하고 있는 김민재입니다.
최근 몇 년 사이 고객사의 AX 요구사항은 크게 다각화되었습니다. 얼마 전까지 Multi-Agent 서비스를 어떻게 구축할 것인가가 논의의 중심이었다면, 지금은 Harness와 Ontology, Physical AI까지 범위가 넓어졌습니다. 이러한 요구에 대응하기 위해 저희 팀에서도 최신 AI 기술을 꾸준히 조사하고 내부에 공유하는 활동을 이어오고 있습니다.
저는 그 일환으로 자율주행과 Physical AI에 관심 있는 팀원들과 함께, 사이드 프로젝트로 자율주행 원천기술 연구를 진행해 왔습니다. 연구의 출발점은 AI가 교통사고 영상을 얼마나 깊이 이해하는지, 그리고 그 판단이 무엇에 근거하는지에 대한 질문이었습니다.
이 글에서는 이 주제로 진행한 두 건의 연구를 차례로 소개하겠습니다. 첫 번째는 AI가 사고 원인을 단계적으로 추론하도록 설계한 사고 이해 파이프라인이고, 두 번째는 AI 모델이 실제로 무엇을 근거로 판단하는지를 분석한 연구입니다.
1. 연구 배경: long-tail 시나리오와 사고 이해
자율주행 모델의 성능에는 학습 데이터의 품질이 결정적입니다. 그런데 테스트 차량이 하루에 수집하는 주행 데이터는 대부분 중복됩니다. 직진과 정속 주행, 무난한 차선 유지가 반복되기 때문에, 수집량을 늘리는 것만으로는 모델이 새로 배울 것이 많지 않습니다.
학습 가치는 오히려 드물게 나타나는 장면에 집중되어 있습니다. 흔한 직진 주행 영상 1만 건보다 갑자기 도로로 뛰어드는 보행자 한 건이 모델 학습에 더 가치가 있습니다. 이렇게 드물지만 중요한 상황을 long-tail 시나리오라고 부릅니다.
방대한 주행 데이터에서 이런 장면을 찾아내려면 날씨나 객체 수 같은 조건 검색만으로는 부족합니다. 이러한 조건은 장면의 특징을 나열할 뿐, “왜 위험한가”에는 답하지 못하기 때문입니다. 사고 영상을 프레임 단위로 훑으며 상황을 인과적으로 이해하고 추론하는 AI 모델이 필요합니다.
학계의 관심도 같은 방향으로 움직이고 있습니다. 자율주행 사고 이해 과제는 “어떤 객체가 위험해 보이는가”를 넘어, 사고의 원인과 유형, 예방 조치까지 묻는 방향으로 확장되고 있습니다. 이 질문들에 답하려면 사고가 어떤 순서로 전개되었고 무엇이 결과를 결정했는지를 이해해야 합니다. 즉, 과제의 중심이 정지 이미지 단위의 객체 검출에서 시계열(temporal) 인과 추론으로 옮겨간 것입니다.
저희는 이러한 문제의식에서 출발해 VLM(Vision Language Model, 비전 언어 모델)을 활용한 사고 이해 연구를 진행했습니다.
2. 첫 번째 연구: 프롬프팅을 넘어 구조화된 인과 추론으로
연구는 “VLM이 사고 장면을 제대로 읽지 못하는 것은 영상 속 대상의 위치를 정확히 파악하지 못하기 때문이며, 객체 검출 결과를 명시적으로 제공하면 성능이 개선될 것이다”라는 가설에서 출발했습니다.
이를 검증하기 위해 VRU(Vulnerable Road User, 보행자·자전거 이용자 등 사고에 취약한 도로 사용자)를 찾는 Detector 모듈, 프레임별 VRU의 바운딩 박스를 덧그리는 Visual Overlay 모듈, 검출 결과를 바탕으로 CoT(Chain-of-Thought) 추론을 이끄는 Reasoning 모듈을 VLM에 결합했습니다. 검출(Detection)과 추론(Reasoning)을 결합해 VLM을 보강한다는 뜻에서 이 파이프라인을 DRIVE(Detection-Reasoning Integrated VLM Enhancement)라고 이름 붙였습니다. DRIVE는 사고 영상에 대한 객관식 질의응답 벤치마크인 VRU-Accident에서 전체 정확도 74.62%로 당시 기준 최고 성능을 기록했습니다.
오답에서 발견한 구조
최고 성능을 기록했지만, 오답을 분석한 결과 틀린 이유가 몇 가지 패턴에 집중되어 있다는 사실을 확인했습니다. DRIVE가 틀린 278건은 네 가지 유형으로 나뉘었고 그중 상위 세 유형이 전체의 86%를 차지했습니다.
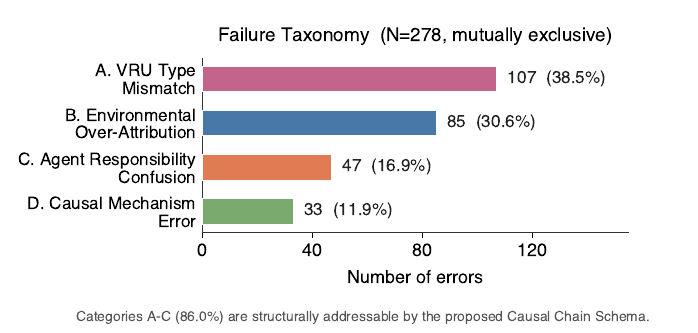
그림 1. DRIVE 오답 278건의 유형별 분류
세 유형은 각각 VRU의 종류를 혼동하거나(보행자만 검출된 장면에서 “자전거 이용자가 알아채지 못했다”를 선택), 환경에 원인을 과도하게 돌리거나(비가 보이면 정답이 “운전자 부주의”인데도 “노면 불량”을 선택), 자차와 VRU의 책임을 뒤바꾸는 경우였습니다. 공통점은 원인을 따져 묻는 과정이라면 당연히 거쳐야 할 중간 추론 단계가 빠져 있다는 것입니다. 날씨나 도로 유형 같은 정보를 더 제공해도 개선 효과는 미미했습니다. 문제는 모델이 무엇을 보는지가 아니라 어떻게 추론하는지에 있었습니다.
추론을 다섯 단계로 분해하다
이에 따라 사고 원인 추론을 다섯 단계로 나누고, 각 단계에서 정해진 선택지 중에서만 고르도록 한 파이프라인을 제안했습니다. 앞 단계의 결과가 다음 단계의 선택지를 좁히는 구조입니다.
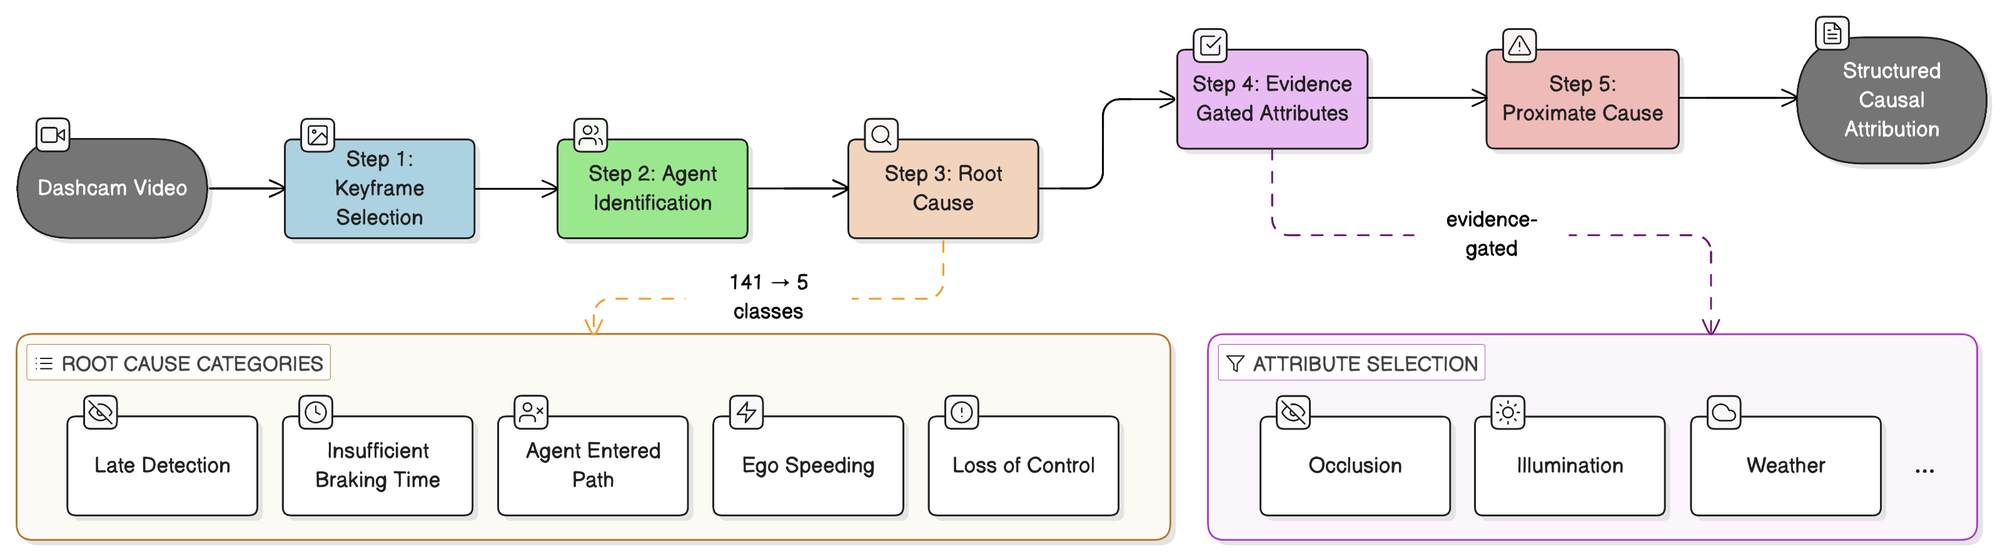
그림 2. Structured Causal Chain 5단계 파이프라인
사고의 결과가 결정된 키프레임을 찾고, 그 시점에 결과에 영향을 준 행위 주체를 선택한 뒤, 사고 원인을 다섯 가지 유형으로 분류합니다. 가장 중요한 장치는 네 번째 단계의 증거 게이팅입니다. ‘제어 상실’을 원인으로 선택하려면 미끄러짐 같은 증거를 먼저 확인해야 하고, 증거가 없으면 게이트가 이 원인을 차단하고 VLM의 재추론을 유도합니다. 앞서 본 “환경에 원인을 과도하게 돌리는” 오류를 구조적으로 막는 장치입니다.
이 구조는 자율주행 안전 표준인 SOTIF(Safety of the Intended Functionality, ISO 21448)[1]의 위험 분석 절차에서 착안했습니다. SOTIF는 고장이 없는데도 의도한 기능을 충분히 수행하지 못해 발생하는 위험을 다루는 표준으로, 위험을 촉발한 조건을 찾아 그 원인을 따져 보는 절차를 갖고 있습니다.
다섯 단계 중 앞의 두 단계, 즉 키프레임과 행위 주체 정보를 제공했을 때의 성능 개선은 다음과 같습니다. 두 단계만으로도 뚜렷한 개선이 나타났습니다.
|
조건 |
사고 원인 정확도 |
기준선 대비 |
|---|---|---|
|
기준선 (DRIVE) |
71.58% |
- |
|
+ 키프레임 |
76.84% |
+5.26 |
|
+ 행위 주체 |
77.89% |
+6.32 |
|
+ 키프레임 & 행위 주체 |
78.95% |
+7.37 |
두 단계를 합쳤을 때의 개선 폭이 개별 개선 폭의 합보다 작다는 점이 흥미로웠습니다. 키프레임이 정확히 잡히면 그 시점의 중요한 행위 주체가 이미 시각적으로 두드러지기 때문에, 주체를 명시하는 효과가 그만큼 줄어드는 것으로 해석됩니다.
이 결과를 정리한 논문 Beyond Prompting: Structured Causal Chain Reasoning for VRU Accident Understanding in Vision Language Models는 CVPR 2026의 자율주행 워크숍인 AUTOPILOT[2]에 채택되었습니다.
3. 두 번째 연구: Look or Read, VLM은 무엇을 근거로 판단하는가
첫 번째 연구가 VLM의 사고 이해 성능을 높이는 파이프라인을 구축하는 일이었다면, 두 번째 연구는 그 VLM이 내부적으로 어떻게 판단하는지를 분석하는 일이었습니다.
검출 결과를 텍스트로 함께 제공하는 파이프라인에서 VLM은 두 종류의 정보를 받습니다. 영상 프레임의 픽셀(영상 채널)과, 검출기가 찾아낸 내용을 옮긴 문장(텍스트 채널)입니다. 두 채널이 서로 다른 형태로 같은 장면을 기술하는 만큼, 모델이 실제로 어느 쪽에 의존해 답하는지는 정확도만으로는 알 수 없습니다. 이 구분은 실무적으로도 중요합니다. 성능이 같은 두 파이프라인 중 어느 쪽을 차량에 올릴지, 카메라와 검출기 중 무엇을 먼저 개선할지 결정하려면 답이 어디에서 나왔는지를 알아야 하기 때문입니다.
행동과 내부 메커니즘, 세 가지 분석
모델이 사고를 이해할 때 어느 정보에 의존하는지 파악하기 위해, 저희는 겉으로 드러나는 행동과 Transformer 내부의 메커니즘을 나누어 살펴보는 세 가지 분석을 제안했습니다.
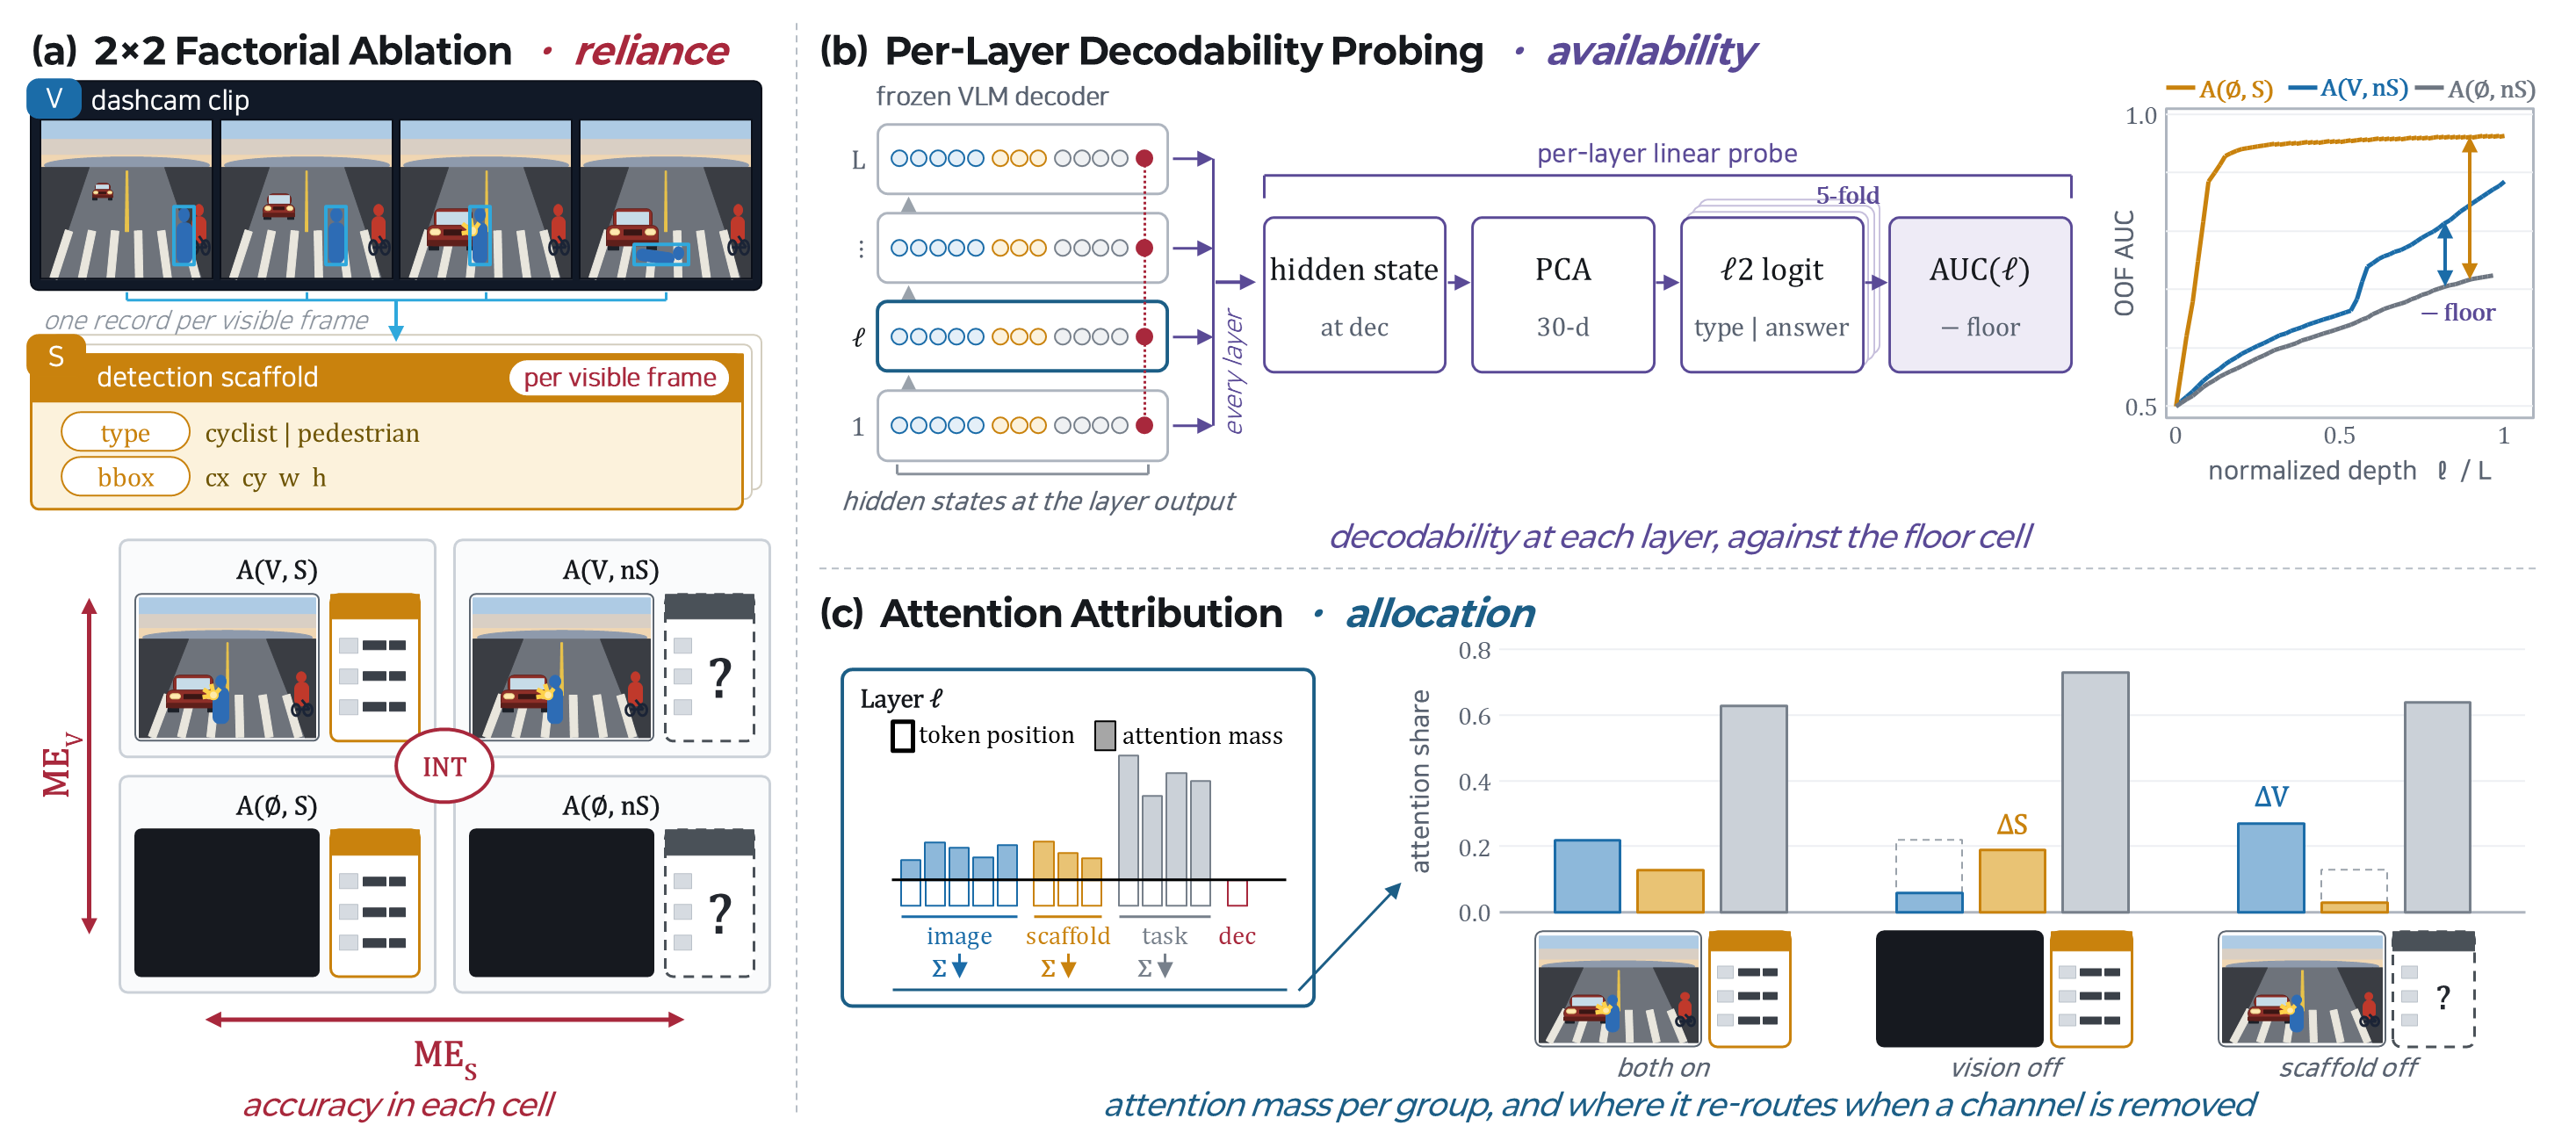
그림 3. 세 가지 분석의 구조: (a) 2×2 요인 제거 실험, (b) 깊이별 프로빙, (c) 어텐션 귀인
- 2×2 요인 제거 실험(행동): 영상과 텍스트 채널을 각각 켜고 끄는 네 가지 조합에서 정답률을 측정합니다. 영상을 끌 때는 프레임을 검은 화면으로 바꾸고, 텍스트를 끌 때는 검출 값만 물음표로 가립니다. 이를 통해 각 채널이 정답률에 미친 효과와 두 채널의 상호작용을 계산할 수 있습니다.
- 깊이별 프로빙(내부): 모델이 답을 내기 직전 토큰의 은닉 상태(hidden state)를 층마다 추출하고, PCA로 차원을 줄인 뒤 로지스틱 회귀로 “이 층에서 VRU의 종류나 정답을 읽어낼 수 있는가”를 측정합니다. 이를 통해 어느 깊이에서 정보가 읽히기 시작하는지 확인할 수 있습니다.
- 어텐션 귀인(내부): 같은 토큰의 어텐션이 영상 토큰, 검출 텍스트, 질문 텍스트 중 어디에 얼마나 실리는지, 그리고 한 채널을 없앴을 때 어디로 옮겨가는지 측정합니다.
세 분석 모두 같은 클립, 동일한 프롬프트, 동일한 채널 on/off 조합에서 수행한 것이 핵심입니다. 그래야 세 관점이 같은 답을 주는지, 서로 다른 답을 주는지를 직접 비교할 수 있습니다.
주요 발견
이 분석을 5개의 VLM과 두 개의 벤치마크에 적용했습니다. 앞서 소개한 VRU-Accident와 함께, 도로 사용자의 이동 의도를 가로 방향과 세로 방향 두 축으로 묻는 DRAMA-X를 사용했으며, 그 결과 다음 세 가지를 확인했습니다.
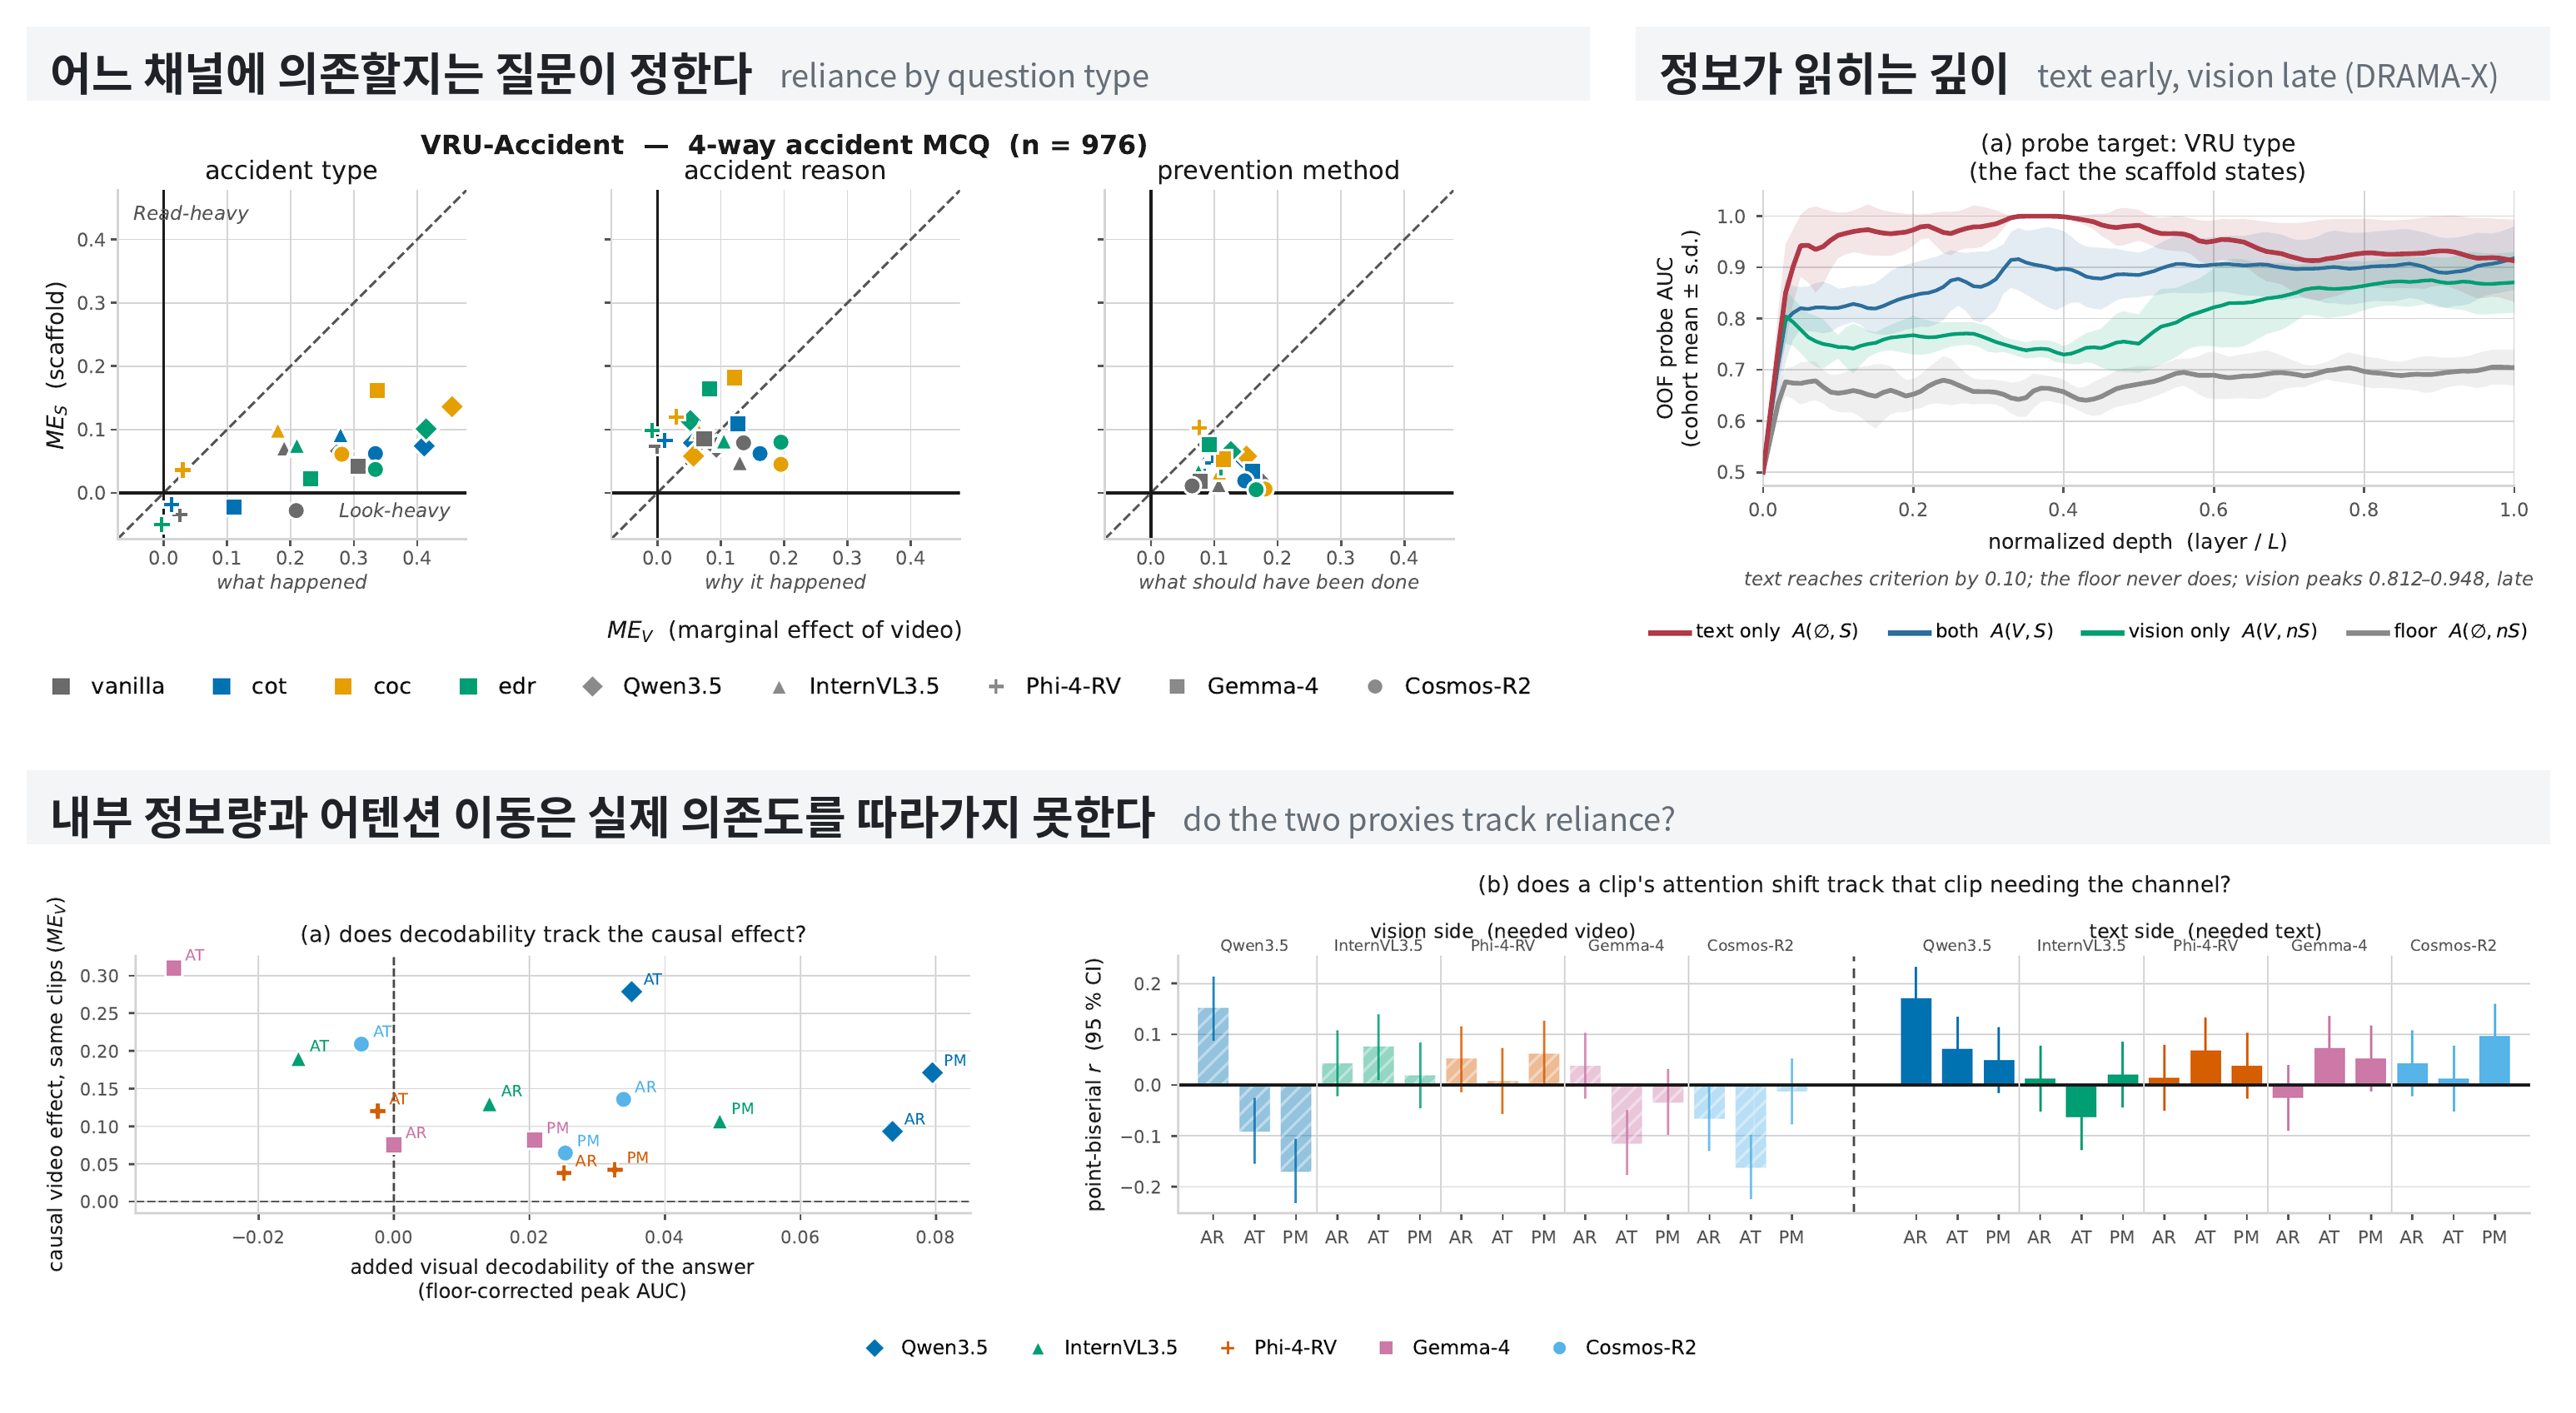
그림 4. 질문별 채널 의존도(상단 좌), 정보가 읽히는 깊이(상단 우), 대리 지표 검증(하단)
모델이 영상을 볼지 텍스트를 읽을지는 질문이 정합니다. 같은 클립과 같은 프롬프트로 “어떤 사고가 일어났는가”를 물으면 영상 채널의 영향이 텍스트 채널보다 평균 약 5배 컸지만, “왜 일어났는가”를 물으면 두 채널이 대등해졌습니다. 이 경향은 모델을 바꾸어도 유지되었고, DRAMA-X에서는 하나의 답 안에서도 가로 방향과 세로 방향에 따라 우세한 채널이 갈렸습니다. 흔히 “이 모델은 시각 정보를 잘 활용한다”처럼 모델의 성질로 이야기하지만, 실제로는 질문에 따라 달라지는 것입니다.
검출 텍스트는 성능을 더하는 장치라기보다 보험에 가깝습니다. 두 채널의 효과는 더해지기보다 서로를 대체하는 쪽에 가까웠습니다. 텍스트 채널이 정답률에 기여하는 크기는 영상이 정상일 때보다 영상을 검은 화면으로 가렸을 때 약 4배 컸습니다. 카메라가 제대로 작동할 때 텍스트 채널은 작은 이득을 더하는 정도지만, 카메라 정보가 사라졌을 때는 손실을 크게 메워줍니다. 검출 결과가 정확하다는 전제에서, 카메라 정보가 불완전한 상황에 대비하는 안전장치로서 검출 텍스트의 역할이 분명해진 것입니다.
텍스트로 들어온 정보는 네트워크 앞쪽에서, 영상의 정보는 뒤쪽에서 읽힙니다. DRAMA-X에서 깊이별 프로빙을 해 보니, 텍스트로 들어온 사실은 네트워크 깊이의 앞쪽 10% 안에서 이미 읽어낼 수 있었습니다. 반면 같은 사실을 픽셀에서 읽어내는 정확도는 네트워크의 거의 끝까지 계속 올라갔습니다. 저희는 이 결과를 “읽기는 조회, 보기는 계산”이라는 가설로 해석하고 있습니다. 텍스트는 이미 정리된 답을 조회하는 것에 가깝고, 영상은 층을 거치며 답을 계산해 나가는 과정이라는 것입니다. 이 가설이 맞다면 모델은 답에 더 빨리 닿는 쪽을 택합니다. 질문이 요구하는 정보가 텍스트에 그대로 적혀 있으면 읽고, 영상을 봐야만 알 수 있으면 보는 것입니다. 질문에 따라 우세한 채널이 달라진 첫 번째 발견도 이렇게 설명할 수 있습니다. 다만 정보가 앞쪽에서 읽힌다고 해서 모델이 그 정보를 실제로 사용하거나 더 적은 계산으로 답한다고 단정할 수는 없기 때문에, 이를 직접 검증하는 실험은 후속 과제로 남겨 두었습니다.
이 결과가 말해주는 것은 세 관점이 서로를 대체할 수 없다는 점입니다. 어텐션은 모델이 어디를 보는지를, 프로빙은 어떤 정보가 내부에 있는지를 알려주지만, 답이 무엇에 의존했는지는 실제로 채널을 껐을 때의 변화로만 확인할 수 있었습니다. 세 관점을 같은 조건에서 함께 읽어야 모델의 판단 근거를 온전히 이해할 수 있습니다.
이 연구는 NeurIPS 2026에서 VLM의 근거 기반 판단과 신뢰성을 다루는 워크숍인 VLM4RWD[3]에 채택되었습니다. 이후 워크숍 리뷰 의견을 반영해 보완한 버전을 top-tier 학회에 제출했습니다.
4. 마치며
돌아보면 이 연구들은 거창한 계획이 아니라 엔지니어로서의 호기심에서 시작된 일이었습니다. AI가 “이 장면이 위험한가”를 어떻게 판단하는지 궁금했고, 그 궁금증을 따라가다 보니 모델의 추론 구조를 다시 설계하게 되었고, 이어서 그 판단의 근거까지 들여다보게 되었습니다. 이런 시도를 사이드 프로젝트로 이어갈 수 있었던 것은 새로운 기술을 먼저 찾아보고 공유하는 팀의 문화 덕분이기도 합니다.
그 과정에서 글로벌 협업과 국제 학회라는 무대에서 저희의 엔지니어링 역량을 검증받는 경험도 얻었습니다. 사업 이행 조직이 원천기술 연구까지 다룰 수 있다는 것을 작게나마 보여준 사례가 되었기를 바랍니다.
고객의 AX 요구가 다각화되는 만큼 사업 이행과 원천기술 연구는 점점 떼어놓기 어려워지고 있습니다. 앞으로도 자율주행과 Physical AI 영역에서 다양한 연구·개발 활동을 이어가려 합니다.
읽어주셔서 감사합니다.
참조
[1] ISO 21448:2022, Road vehicles: Safety of the intended functionality (SOTIF).
[2] AUTOPILOT Workshop @ CVPR 2026. https://www.autopilot-cvpr.net/
[3] VLM4RWD Workshop @ NeurIPS 2026. https://vlm4rwd.github.io/