들어가며
안녕하세요?
AX플랫폼본부 플랫폼개발담당 서동희입니다.
저는 '26년 8월 27일 코엑스에서 진행된 Snowflake의 브레이크아웃 세션 발표자로 참여하여 KT의 BIDW Modern. 사업 여정과 겪었던 고민, 차세대 AI Ready 데이터 플랫폼으로 진화 과정에 대해 발표하였습니다.
이 글에서는 발표했던 내용에 대해 설명드리고 발표하며 느꼈던 후기를 정리해 보았습니다.
KT BIDW 현황과 한계, 그리고 전환 전략
KT BIDW는 전 직원의 1/4 이상이 사용하는 시스템입니다. 약 20만 개의 Active 리포트가 운영되고, 월 50만 회의 리포트 실행이 발생하는 매우 큰 규모의, 그리고 매우 Active한 시스템입니다. 그러나 시스템을 오래 운영하다 보니 세 가지 한계가 뚜렷하게 나타났습니다.
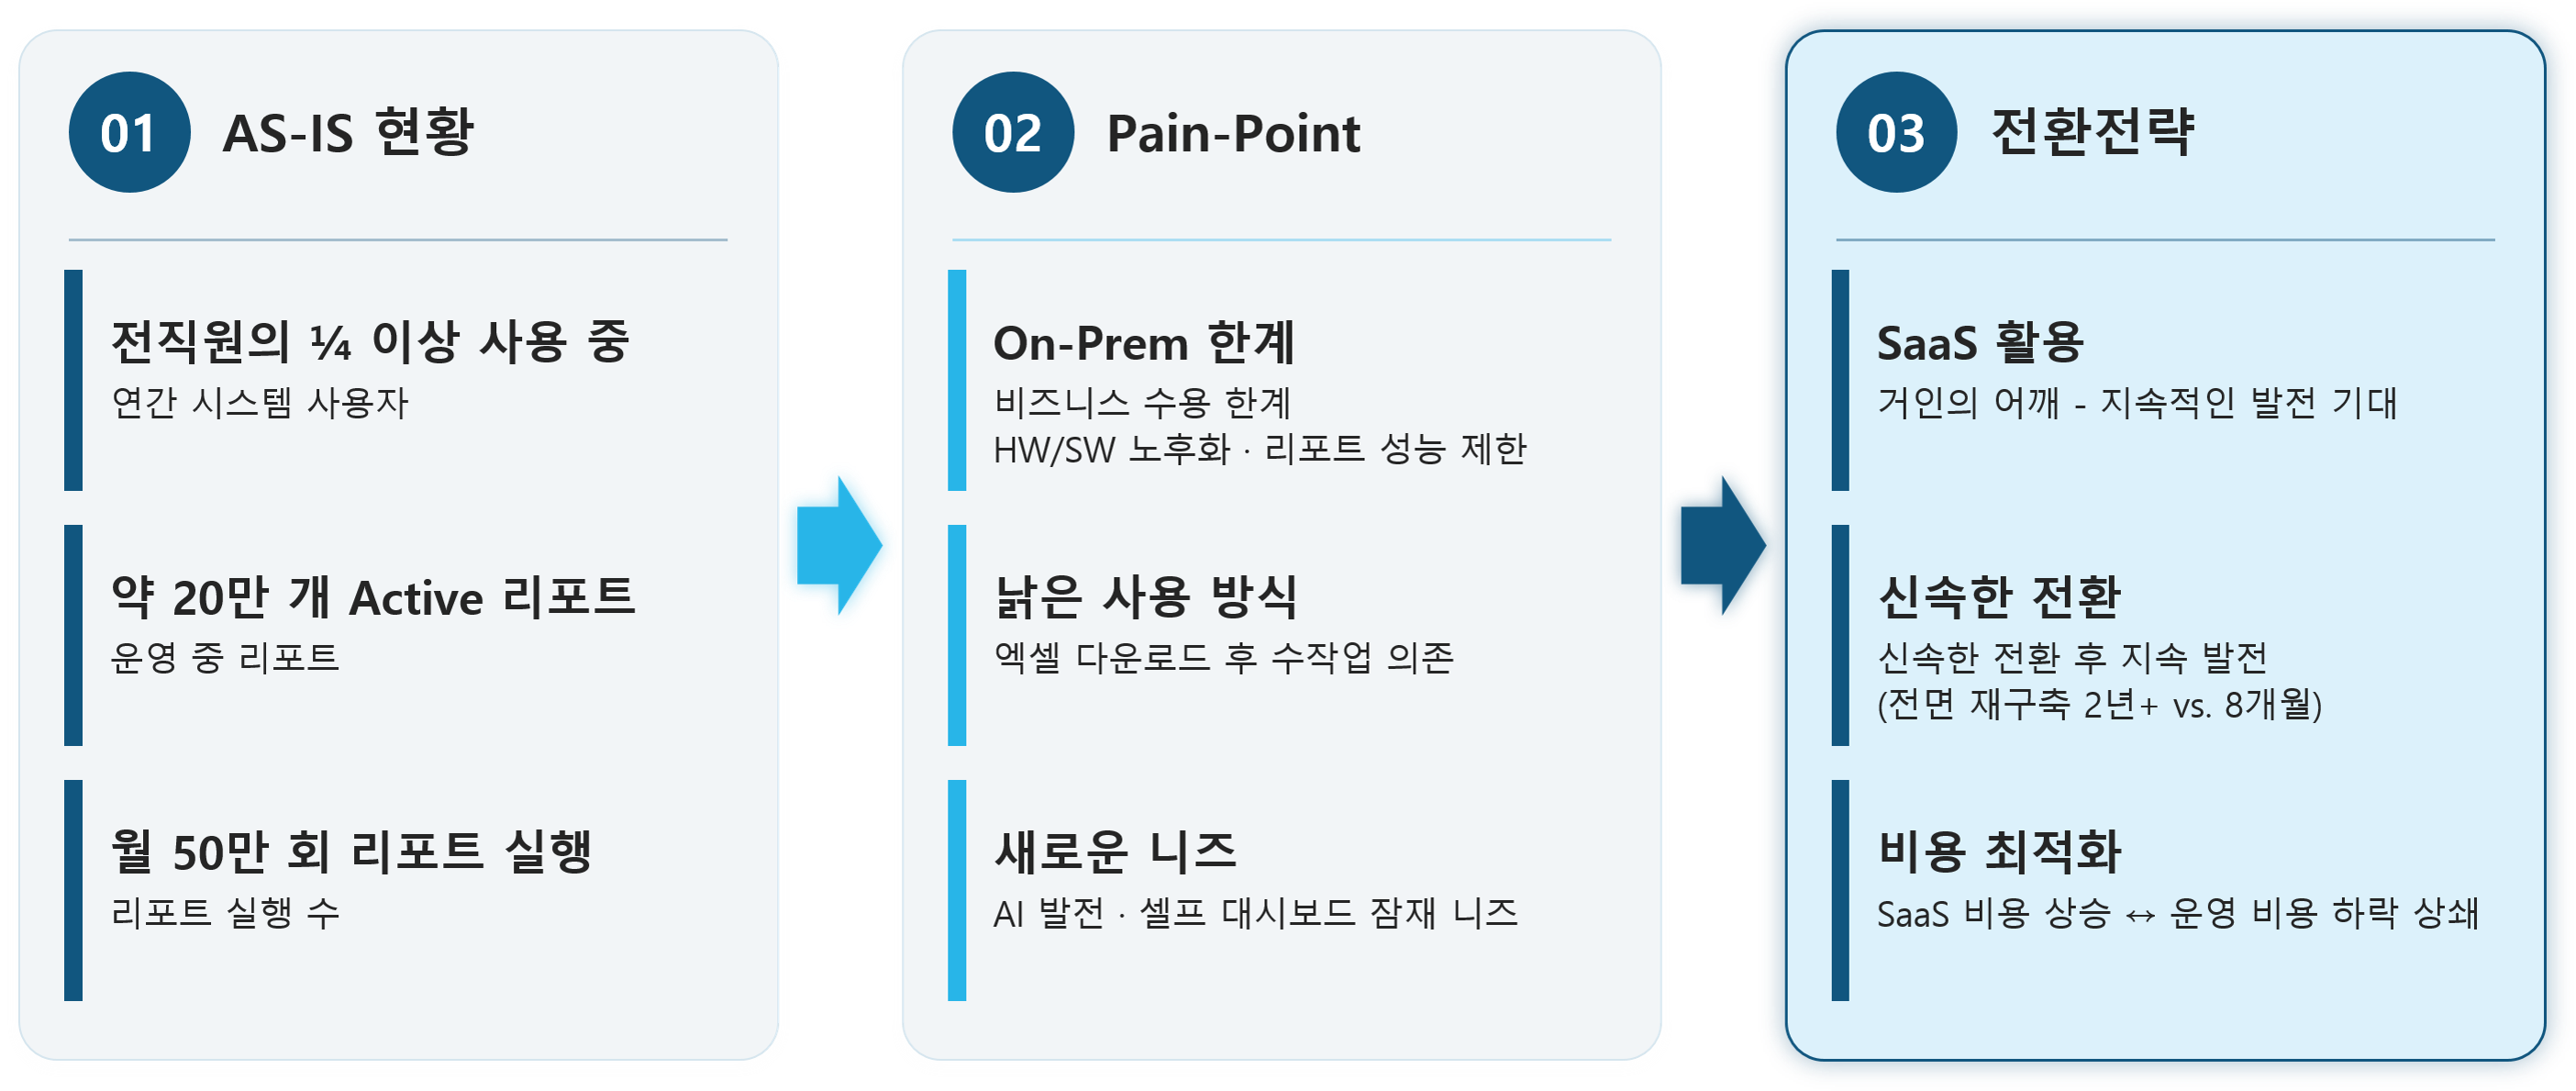
첫째는 온프레미스 인프라의 한계입니다. 사용자는 점점 늘어나는 추세에서 비즈니스 요구와 시스템 사용량이 증가하고 있었습니다. 그러나 수용은 커녕 HW/SW 노후화로 조회 성능을 의도적으로 제한해야만 했습니다.
둘째는 사용 방식입니다. 리포트를 엑셀로 내려받아 수작업으로 가공하는 패턴은 이제 낡은 사용 방식이 되었습니다.
셋째는 새로운 니즈입니다. LLM에 익숙해진 일부 현업 사용자들이 셀프로 대시보드를 만든 뒤, IT 조직에 "이 수준으로 만들어 달라"고 역제안하는 상황까지 왔습니다.
이 글은 그 한계를 SaaS 기반 전환으로 풀어내고, 최종적으로 "AI가 데이터를 이해하게 만드는" 지점까지 도달한 과정의 기술적 의사결정 기록입니다. 특히 프로젝트 중반에 마주친 Semantic Layer 파편화라는 난제와, 그것을 오픈 포맷 표준으로 해결한 이야기가 핵심입니다.
전환 전략 — 왜 전면 재구축이 아니라 SaaS였나
전면 재구축은 2년 이상이 필요했지만, SaaS 기반 전환은 8개월로 가능했습니다. 단순히 빠르기 때문만은 아니었습니다. 판단 근거는 세 가지였습니다.
• 거인의 어깨 - 글로벌 SaaS를 쓰면 플랫폼 자체의 발전을 지속적으로 흡수할 수 있습니다. 인프라를 밑바닥부터 다시 쌓는 대신 애플리케이션과 분석 환경 고도화에 자원을 집중할 수 있습니다.
• 신속한 전환 후 지속 발전 - 전환을 끝점이 아니라 시작점으로 설계했습니다.
• 비용 상쇄 구조 - SaaS 라이선스 비용은 늘지만 온프레미스 운영·유지보수 비용이 크게 줄어, TCO 관점에서 상쇄됩니다. 비용을 줄이지 못하더라도 SaaS가 제공하는 각종 이점들이 가성비 측면에서도 우수했습니다.
전환이 8개월에 가능했던 진짜 배경은 따로 있습니다. 이미 2024년부터 Azure Databricks 기반 레이크하우스 플랫폼(MAGMA)을 선제적으로 구축해 두었기 때문입니다. 이 플랫폼은 구축 당시부터 전사 데이터 표준화 체계를 확보했고, Unity Catalog를 통해 한 벌의 데이터를 다수 서비스가 함께 활용하는 구조를 갖추고 있었습니다. 이번 BIDW 통합으로 MAGMA의 사용자 규모는 기존 대비 5배 이상 확대되었습니다.
Best of Breed — 목적별 최적의 도구를 조합하다
BIDW 현대화를 추진하며 가장 핵심으로 삼은 전략은 Best of Breed, 즉 목적별로 가장 뛰어난 최적의 도구를 조합해 사용자에게 최고의 경험을 제공하는 것이었습니다.
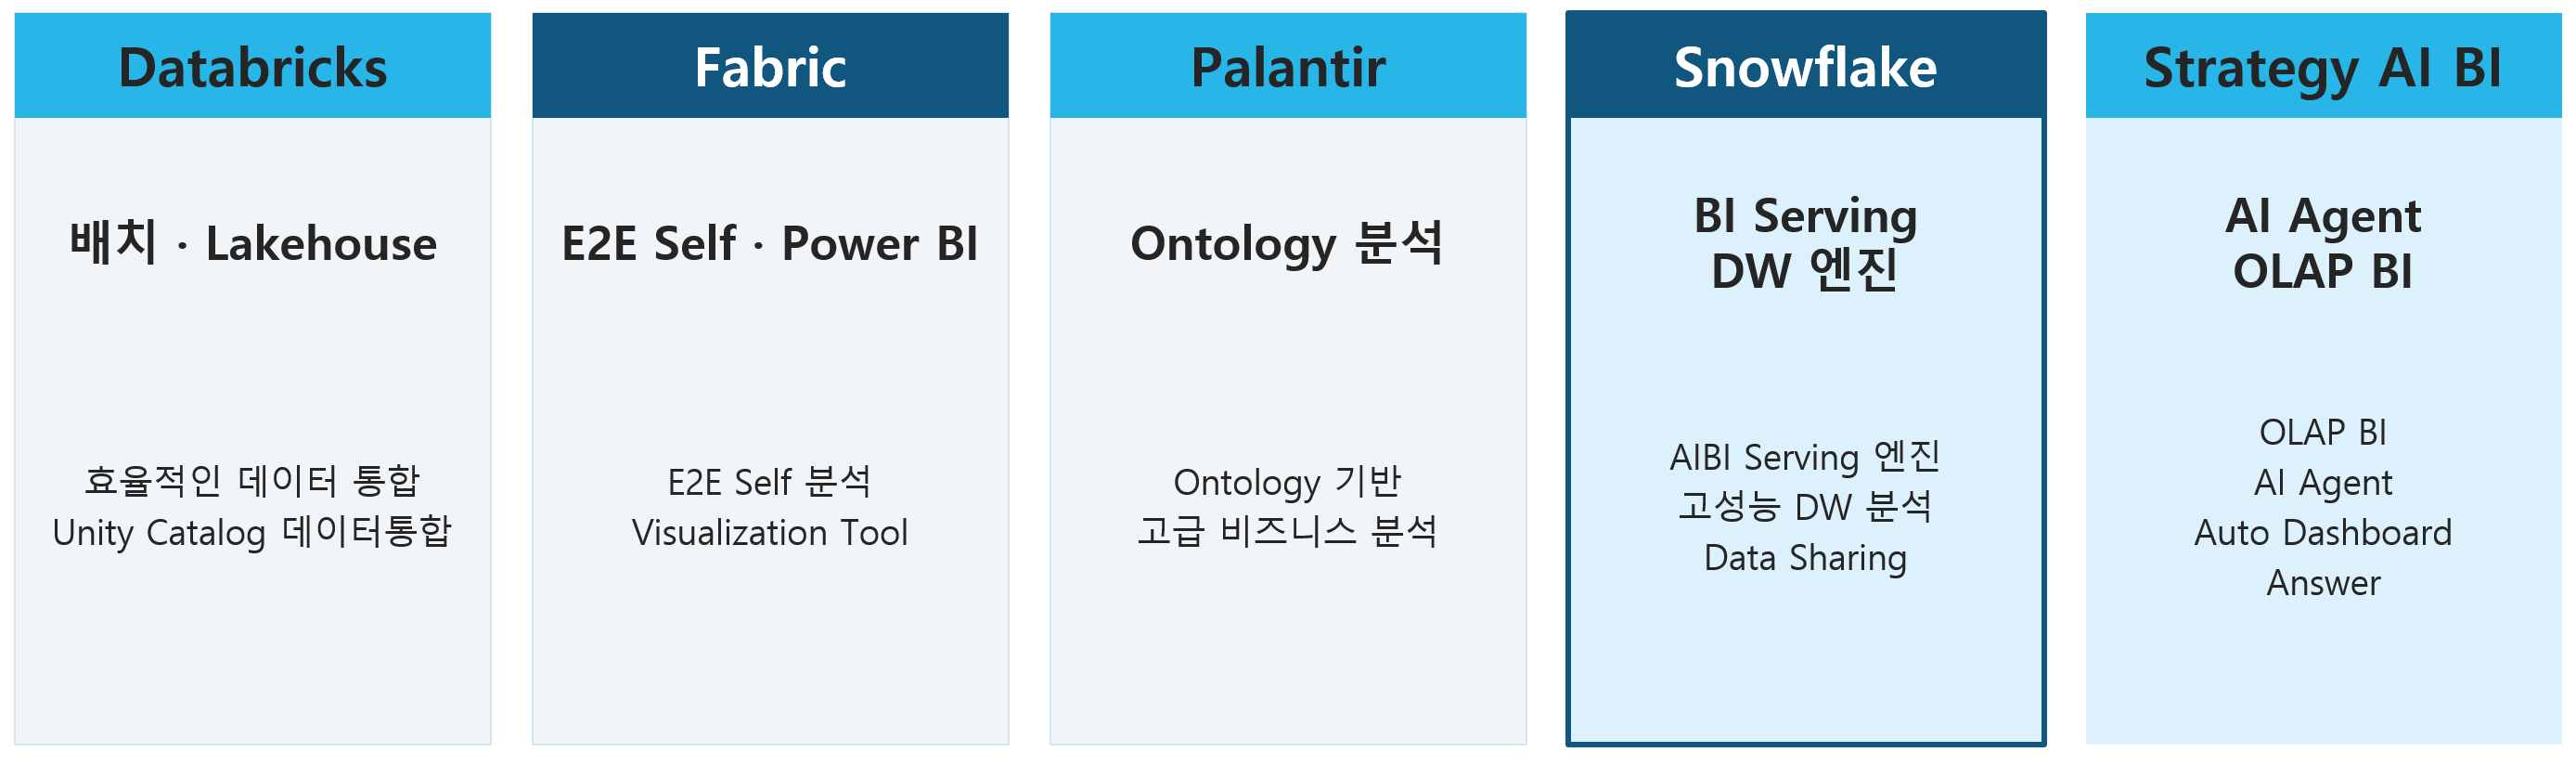
솔루션별 다양한 PoC를 진행하였고 아래와 같은 이유로 솔루션별 최적의 역할을 정의하였습니다.
Databricks 배치 - Lakehouse 대규모 가공/Batch에 따른 컴퓨팅 성능과 비용 효율
Snowflake BI Serving - DW 엔진 조회 속도와 동시성 최우선
Strategy OLAP BI - 기존 리포트 자산 승계 + 차세대 AI/BI 기능
Palantir Ontology - 고급 비즈니스 데이터 관계 모델링
Fabric E2E Self · Power BI 현업 셀프 분석 및 기존 Power BI 연계
Best of Breed의 그늘 — 개발 조직이 실제로 겪은 것
'Best of Breed' 전략은 사용자 입장에서는 최상의 경험을 주는 훌륭한 선택이었지만, 이를 구축하는 개발팀 입장에서는 상당한 도전 과제였습니다.
• Too Many - 기능이 유사하면서도 각기 다른 수많은 SaaS 솔루션 속에서 최적의 조합을 찾기 위해, 저희는 '제로 카피(Zero-Copy) 기반의 데이터 관리 및 서빙'이라는 명확한 원칙을 세우고 많은 PoC와 BMT를 통해 검증을 해야 했습니다.
• Too Fast - 그런데 이 검증 작업이 초기에 단 한 번으로 끝나지 않았습니다. SaaS 서비스들의 발전 속도가 워낙 빠르다 보니, 프로젝트 수행 도중에도 매력적인 신기능들이 쏟아져 나왔기 때문입니다. 예를 들어 Snowflake의 Coco나 Adaptive Computing 같은 기능이 국내에 새롭게 릴리즈되고, BI 영역에서도 새로운 분석 기능들이 출시되었습니다. 성능과 생산성을 혁신할 수 있는 기능들이다 보니 검토를 안 하고 넘어갈 수가 없었고, 신기능을 다시 테스트하고 아키텍처에 반영하는 과정이 프로젝트 내내 반복되었습니다.
• Governance - 또한, 여러 SaaS 솔루션을 혼용하다 보니 데이터 거버넌스 구현 방식이 제각각인 점도 큰 과제였습니다. 예를 들어 데이터 보안의 핵심인 행 단위 접근 제어(Row-Level Security)만 하더라도 솔루션마다 지원 방식과 설정 체계가 완전히 달랐습니다. 이를 하나의 일관된 보안 거버넌스 체계로 통합하고 정합성을 맞추는 데에도 상당한 노력이 투입되었습니다.
최적의 아키텍처 — One Data, Multi Meta, Many Services
수많은 테스트와 깊이 있는 기술 검토 끝에, KT는 다양한 데이터 서비스를 가장 효율적으로 연계할 수 있는 최적의 아키텍처를 확정했습니다.
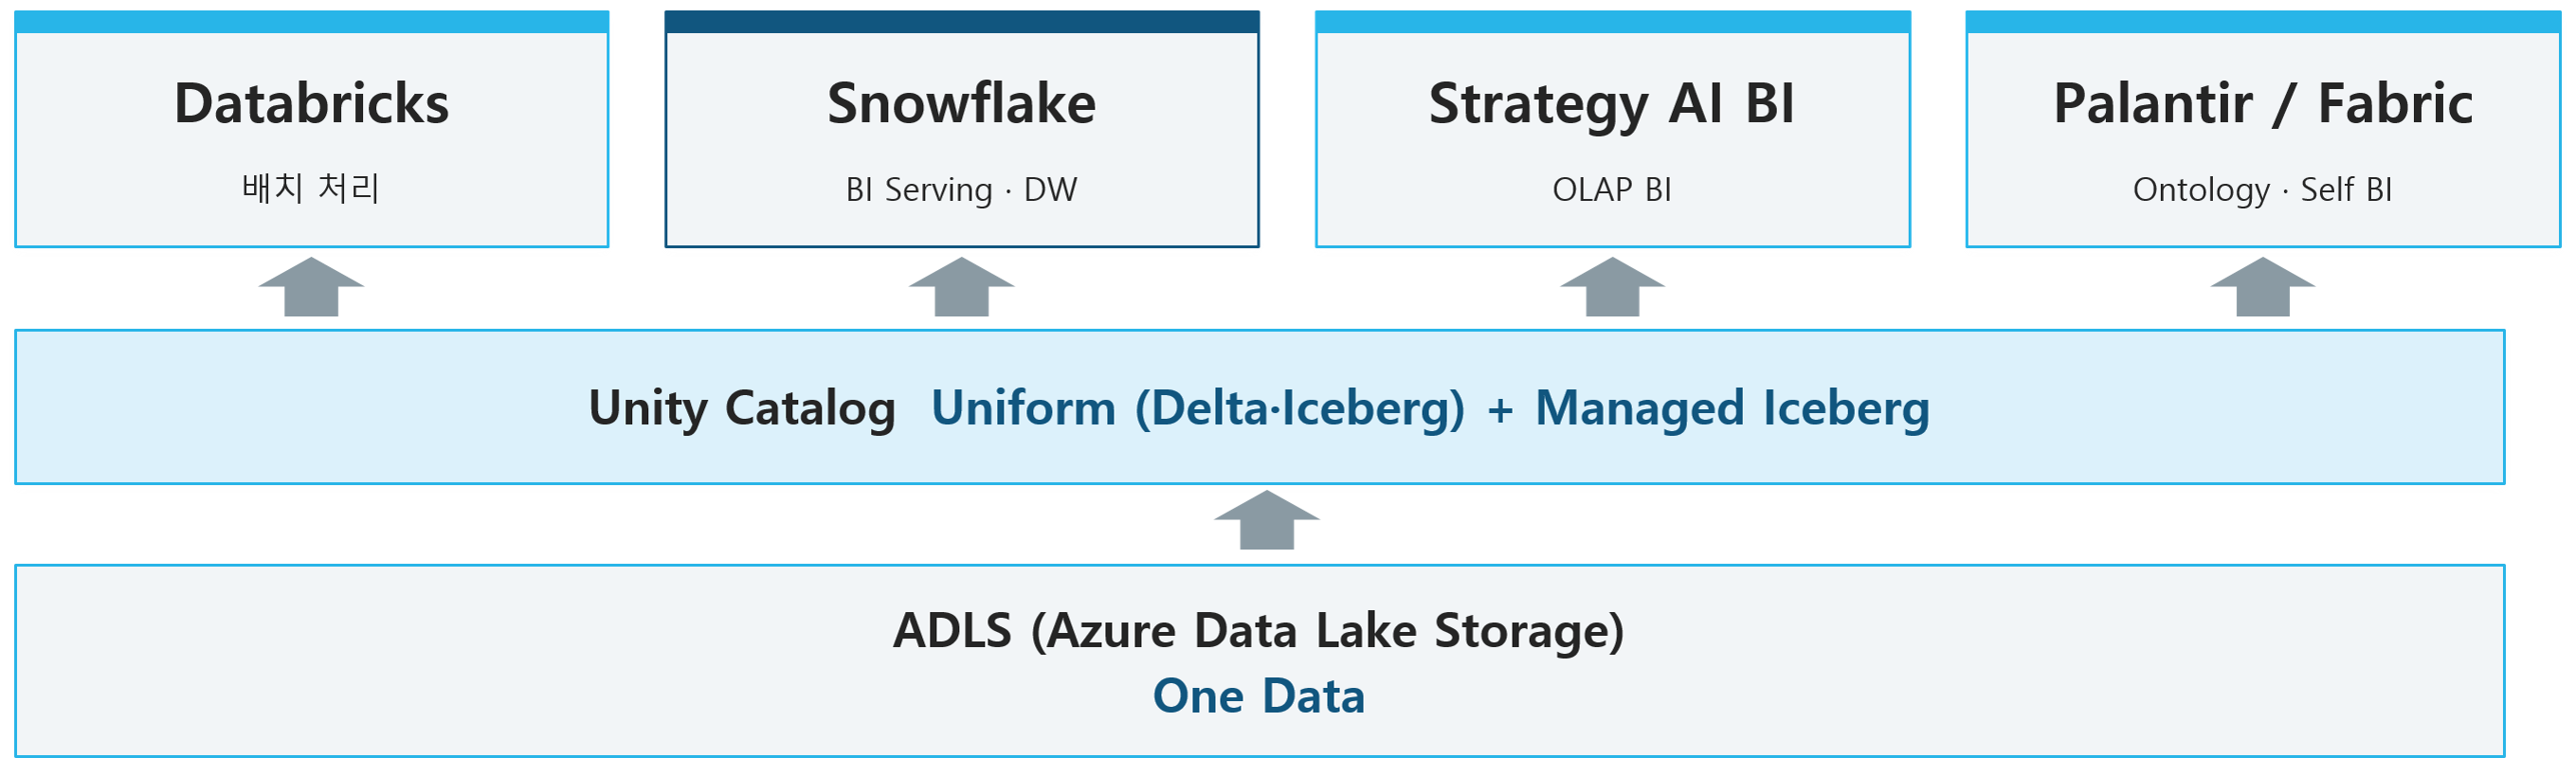
• 스토리지 - 모든 데이터는 ADLS(Azure Data Lake Storage) 에 단 한 번만 저장하는 ‘싱글 스토리지’ 원칙을 적용했습니다.
• 메타 - 메타데이터 관리는 Databricks의 Unity Catalog UniForm과 Managed Iceberg 형식을 활용해, 여러 SaaS 서비스가 데이터 복제 없이 동일한 데이터를 동시에 조회할 수 있는 ‘제로 카피’ 환경을 구현했습니다.
• DataWarehouse - 대규모 데이터 가공 및 배치 처리는 컴퓨팅 처리 성능과 비용 효율성을 종합적으로 고려해 Databricks를 전담 엔진으로 선택했습니다.
• BI Serving - 다수의 현업 사용자가 동시에 대량의 조회를 요청하더라도 지연 없이 즉각적인 응답 속도를 보장해야 하는 BI 서빙 DW 엔진은 성능을 최우선으로 고려하여 Snowflake를 채택했습니다.
• BI - 기존 수많은 사용자의 업무 친숙도를 유지하면서, 대규모 리포트를 안정적으로 일괄 서비스할 수 있는 핵심 OLAP 도구로 MicroStrategy를 선정했습니다.
• 온톨로지 - 복합 데이터 관계 모델링을 위한 온톨로지 분석에는 Palantir를, 현업 중심의 유연한 셀프 BI 및 시각화에는 MS Fabric을 각각 배치했습니다.
AI Ready로 가는 길 — Universal AI와 AI Mart
고객분석·재무·영업·네트워크 분석 등 핵심 도메인별로 약 20여 종의 Pre-built Agent를 만들어 선제적으로 사용자에게 AI 환경을 제공하기로 하였습니다. Agent 수는 운영하면서 점점 더 늘어나게 될 것입니다. 그러나 사용자가 Agent의 이름만 보고 목적에 맞는 정확한 Agent를 찾기 어려울 것이라는 문제가 동반될 것이라는 것도 바로 대응해야 했습니다.
이를 해결하기 위해 포털 검색창처럼 단일 창구에 자연어로 질문하면 의도를 파악해 적합한 Agent로 라우팅하고 답변을 종합하여 보여주는 Universal AI Interface를 Agent 개발과 병행하여 구축하였습니다.
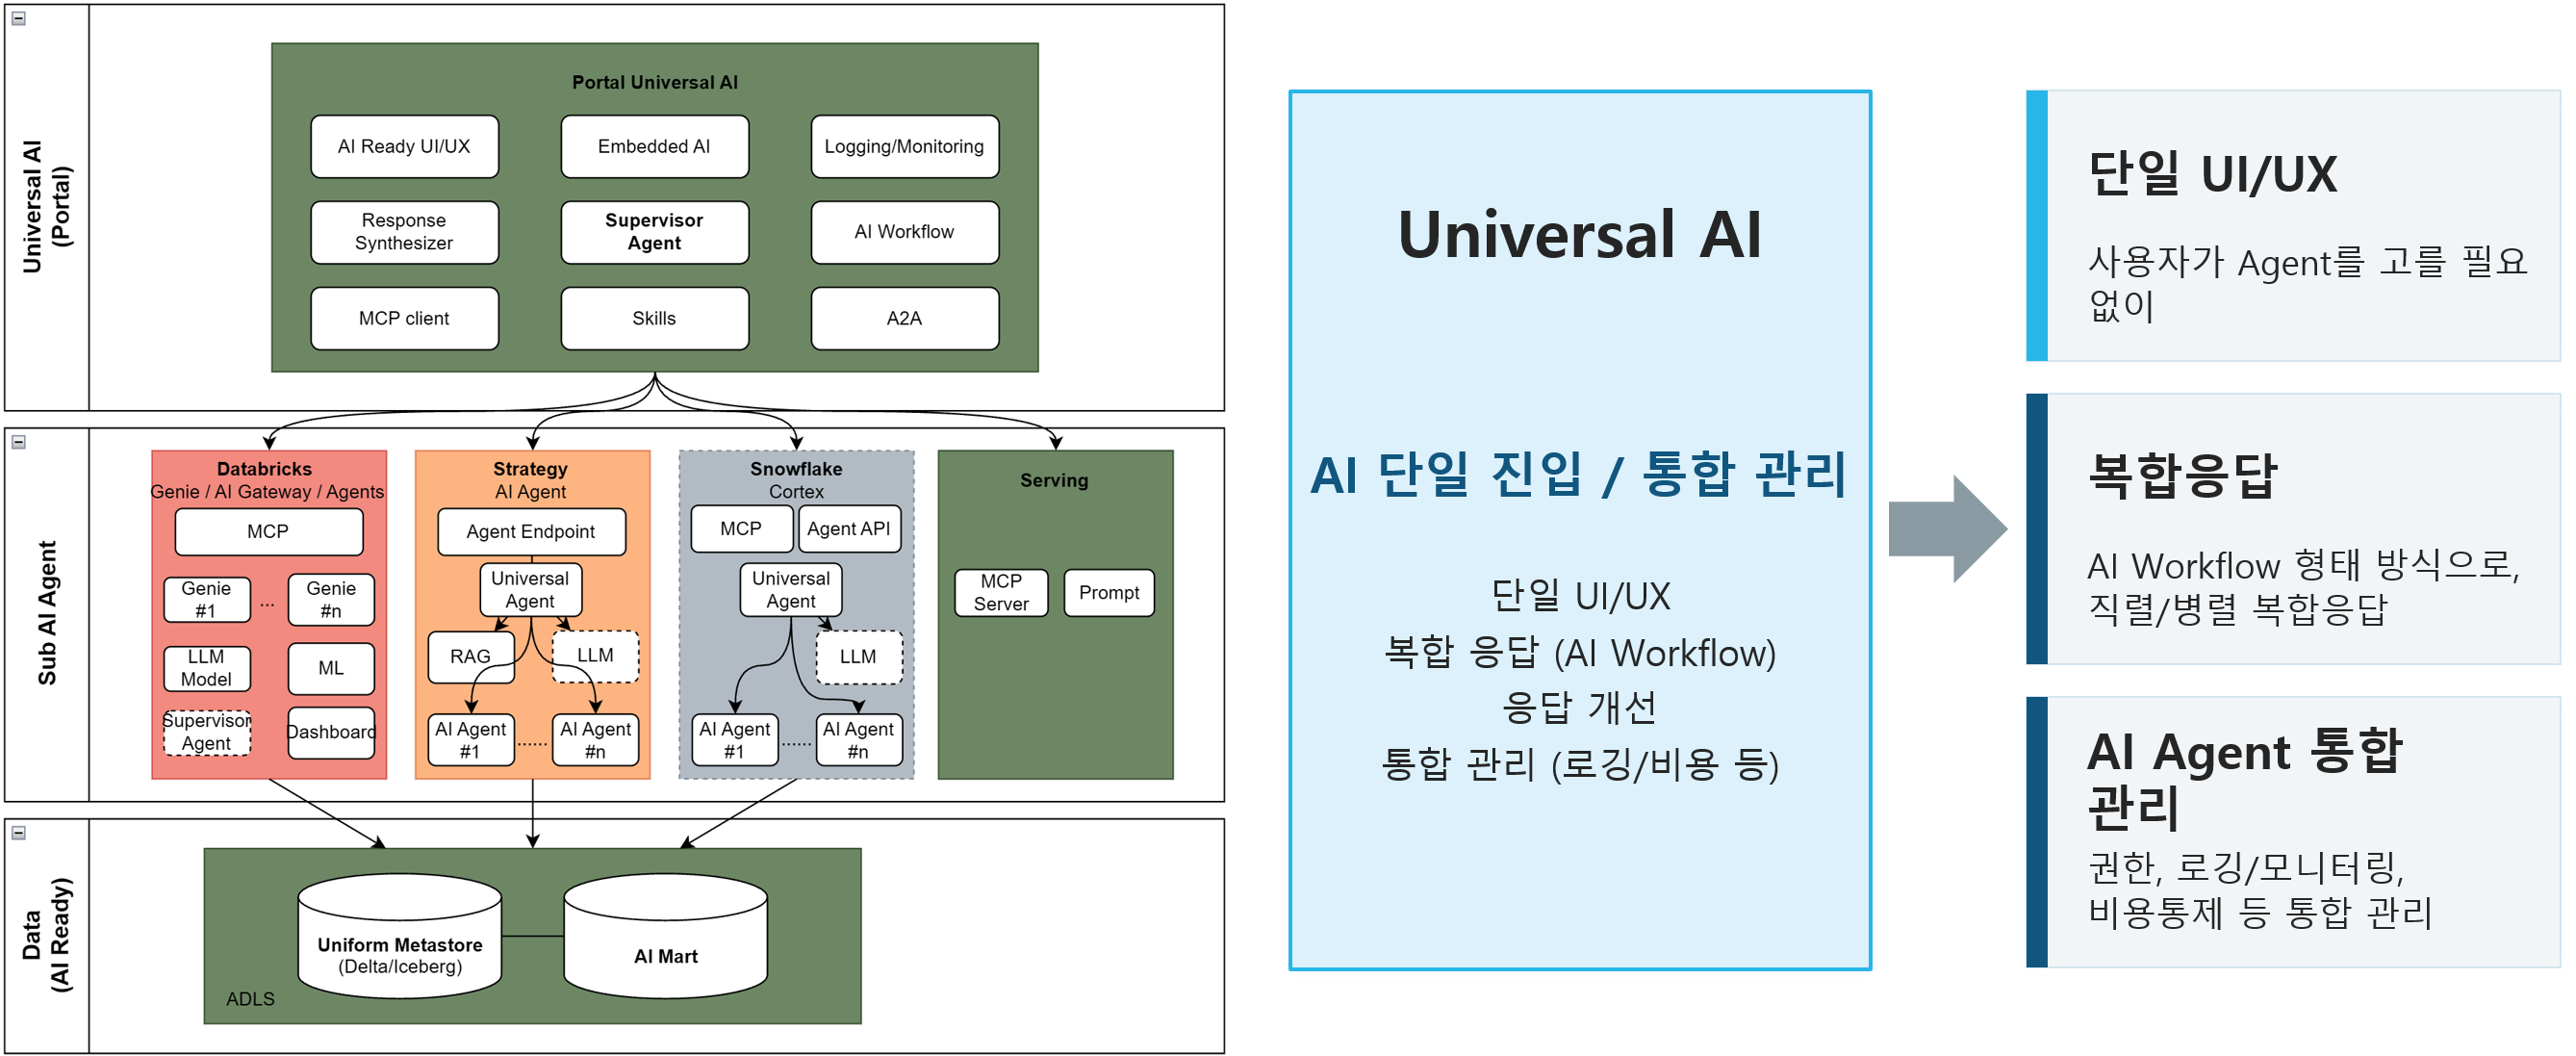
다시 Agent로 돌아오면, 데이터 쪽에서는 AI Mart를 별도로 구축했습니다. '어떻게 하면 최대한 많은 사용자가 Agent의 실질적인 혜택을 체감하게 할 것인가' 관점에서 고민하고 그 결과로 현업에서 가장 많이 활용되는 핵심 데이터와 리포트를 중심으로 데이터셋을 구성하게 되었습니다. 전사 주요 KPI 리포트와 사용률 상위 30% 리포트(가입자·매출·상품·VOC·할인 등)를 선별해 AI용 통계 마트로 정제하였습니다.
별도 구축의 핵심 이유는 응답의 정확도와 속도입니다. AI가 광범위한 DW를 탐색하게 두는 대신, 고빈도 핵심 데이터를 사전에 고품질로 정제해 두면 환각을 줄이고 응답을 빠르게 만들 수 있습니다.
Best of Breed의 두 번째 그늘 — Semantic Layer 파편화
AI Agent가 잘 동작하게 만들기 위한 작업을 하면서 또 다른 문제를 만나게 됩니다. 이 문제는 크게 3가지였는데 그 중 가장 어려운 문제가 세 번째 문제였습니다.
첫째, 자연어와 비즈니스 용어의 간극. 현업이 던지는 자연어 질문과 실제 테이블의 컬럼 정의 사이에는 상당한 괴리가 있습니다. AI가 문맥을 오해하지 않도록 방대한 비즈니스 용어집(Glossary) 등을 정의하고 중앙에서 지속 현행화하는 체계가 필요했습니다. 이를 Semantic Layer라고 하는데 여기서 관리해야 하는 것들이 용어, 용어간 관계, 지표에 대한 수식, 용어를 조회하기 위한 조건 등 다양한 정보들이 관리 대상입니다.
둘째, Agent 답변의 불투명성과 부정확성. 오답이 나왔을 때 어떤 근거와 추론을 거쳤는지 역추적하기가 매우 까다로웠습니다. 교정을 위해 시스템 프롬프트와 지침을 계속 덧붙이다 보니 지침 자체가 비대해져 오히려 모델이 혼란을 겪는 악순환이 생겼습니다. 게다가 AI가 지침 중 일부만 자의적으로 지키는 경우가 많아, 동일 프롬프트에도 답변이 통일되지 않는 일이 빈번했습니다.
그래도 위 두 가지는 프로젝트에서 사람이 해결할 수 있는 일이었으나 다음 문제는 아니었습니다.
셋째, Semantic Layer 파편화. 일반 현업보다 전문 분석가(Power User)들이 AI Agent를 훨씬 적극적으로 썼고, 각자 작업 환경에 맞춰 Snowflake·Databricks의 네이티브 Agent까지 직접 다루기를 원했습니다. 결과적으로 완전히 동일한 데이터셋을 두고 서비스마다 Semantic Layer를 중복 구축·관리해야 하는 상황에 직면했습니다. 서비스마다 반복작업을 할 수밖에 없는 상황에서 Snowflake가 해결자가 되어 주었습니다.
Why Snowflake — 네 가지 기술적 이유
KT가 Snowflake를 도입한 주요 이유는 아래 세 가지였습니다.
1. Open Access — MAGMA가 Iceberg 형식을 채택하고 있고, Snowflake가 Externally Managed Iceberg v3를 네이티브 지원하므로 복제·이동 없이 원천을 즉시 조회할 수 있습니다.
2. Trusted Governance — Strategy에서 쓰던 행 단위 접근 제어를 Snowflake의 RBAC 정책과 일관되게 연계할 수 있어 거버넌스 통합에 유리했습니다. Lineage 확보도 함께 고려했습니다.
3. Elastic Serving — 실제 트래픽을 가정한 PoC에서 동시다발 복합 쿼리 환경의 조회 속도와 동시성 처리가 가장 우수했습니다.
그런데 AI 시대에 가장 중요한 문제에 대한 해결책도 Snowflake가 제시해 주었습니다.
4. Shared Semantics — 앞서의 파편화 문제를 풀 수 있는 오픈 포맷 기반 공유 시맨틱을 지원합니다. 도입 초기 PoC 시점에는 예상하지 못했던 장점이었습니다.
이 오픈 포맷을 솔루션 레벨에서 지원해주어 프로젝트는 한 곳에서 Semantic Layer를 개발하여도 지원하는 모든 솔루션에서 바로 사용할 수 있게 되어 개발 생산성이 매우 높아졌습니다.
오픈 포맷 Semantic Layer와 Apache Ossie
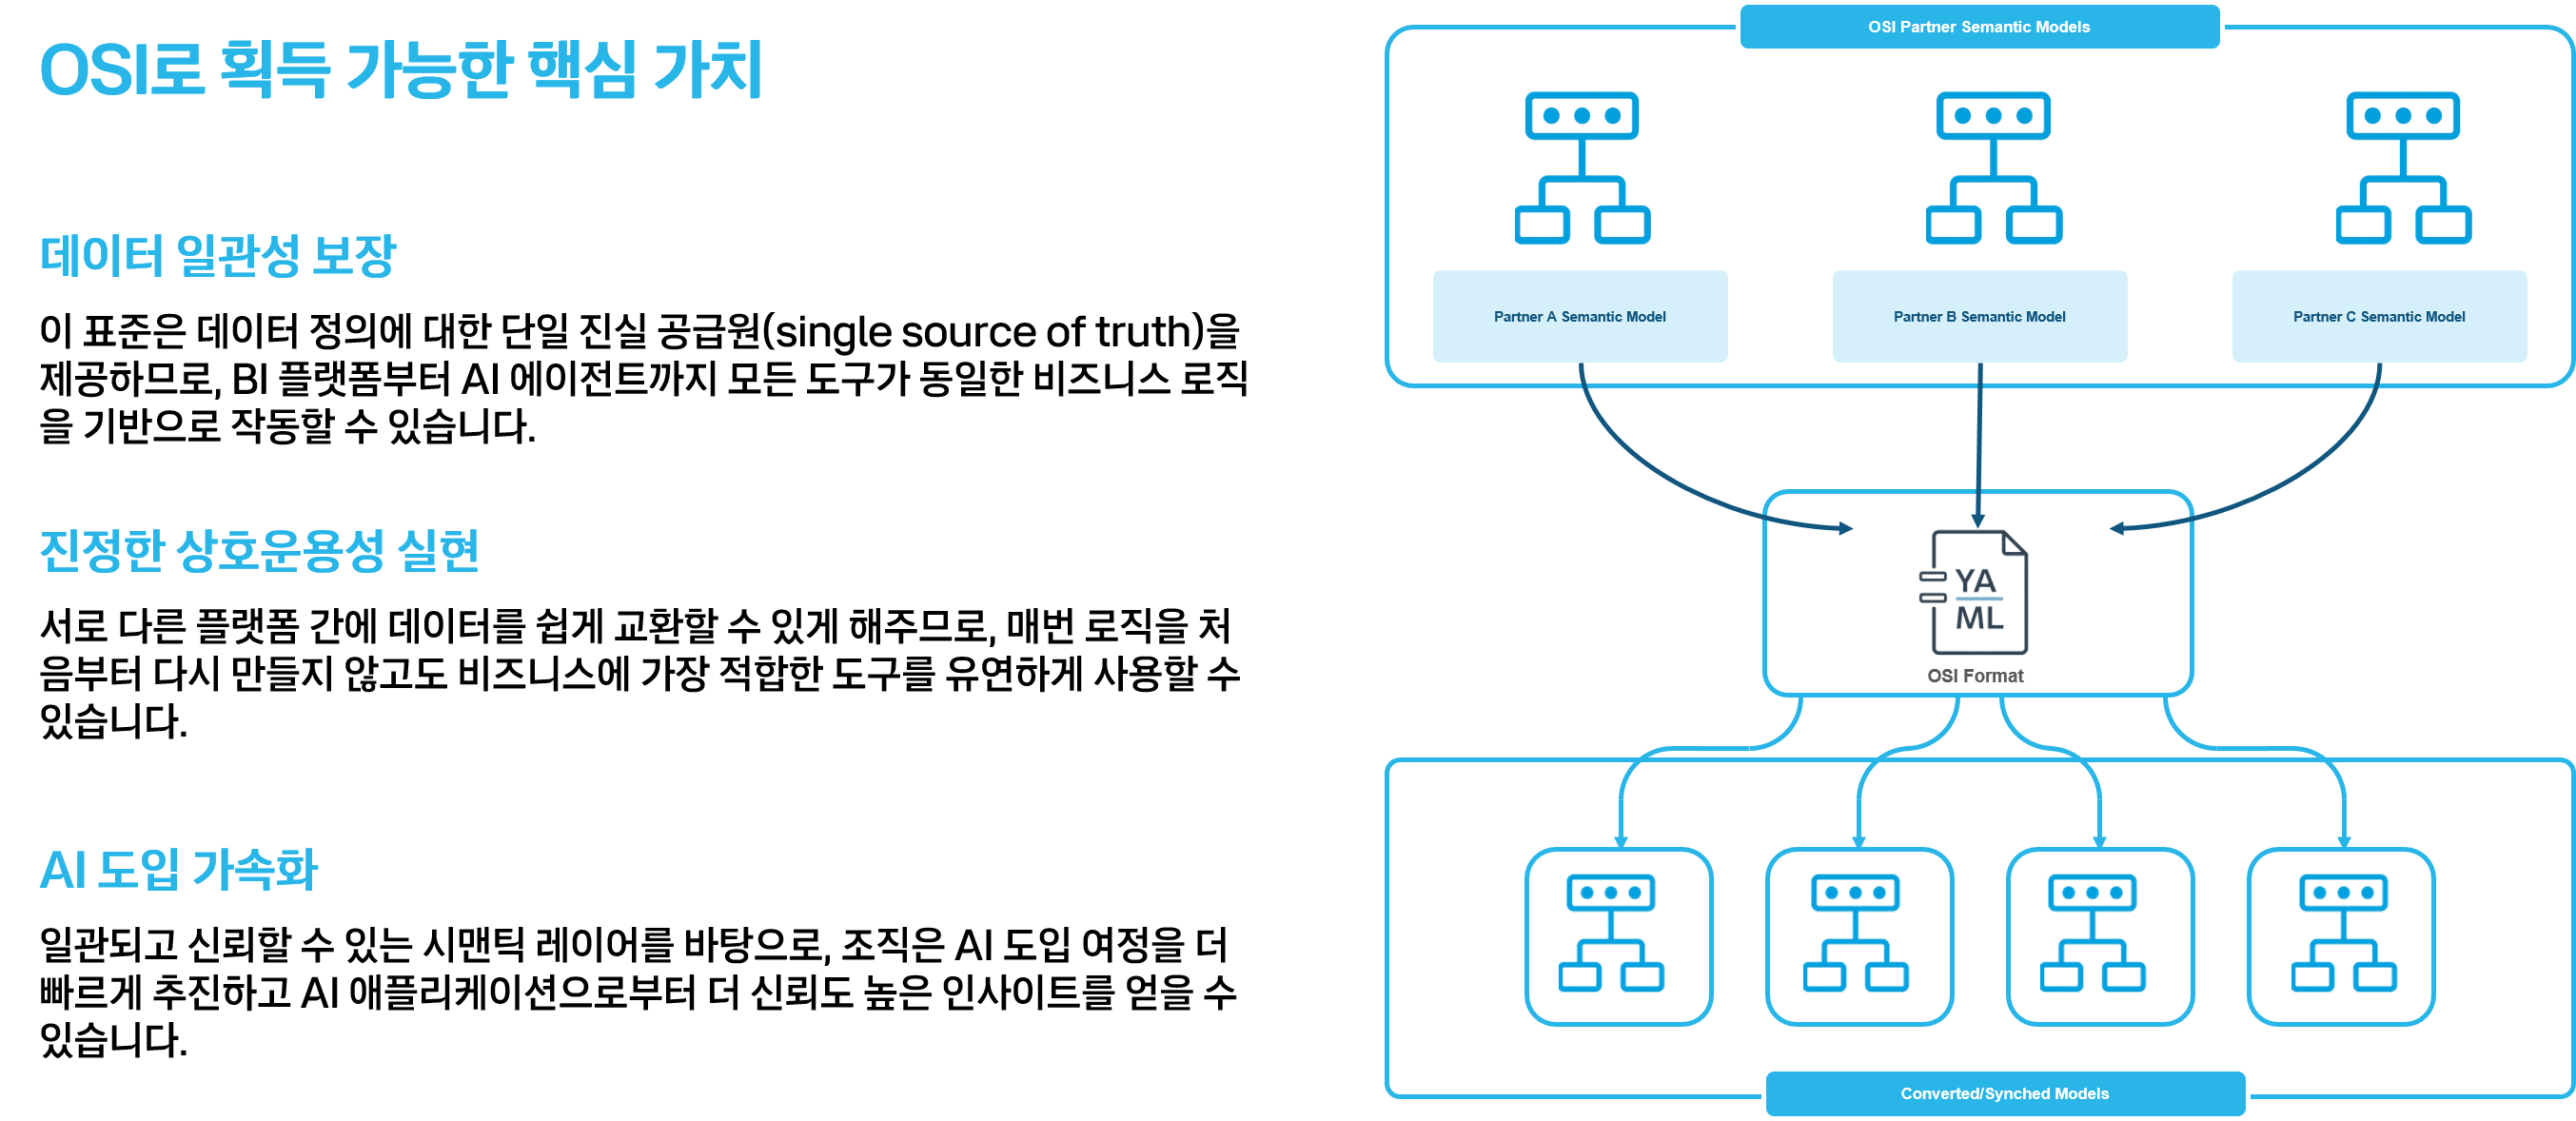
기존 아키텍처에서는 Semantic Layer가 서비스별로 사일로화되고 중복 적재되며, 서비스가 활성화될수록 관리 비효율이 악화되는 악순환이 발생합니다. 오픈 포맷 구조에서는 하나의 원본을 여러 엔진이 공유하므로, 더 좋은 AI 서비스가 등장해도 즉시 교체·적용할 수 있습니다.
이 방향의 업계 표준이 Apache Ossie입니다. 2025년 9월 Snowflake 주도로 Open Semantic Interchange(OSI)가 발족했고, 2026년 6월 Apache 인큐베이터로 편입되며 Apache Ossie(incubating)로 이관되었습니다. 스펙·YAML·미션은 동일합니다. 벤더 중립 YAML로 메트릭·디멘션·관계·컨텍스트를 표준화하며, 창립 16개 조직에서 매우 짧은 기간에 80여 조직으로 400% 성장했습니다. 여러 업체들이 참여하고 있으며 KT가 선택한 Databricks와 Strategy도 포함되어 있습니다. (현 시점에서 Strategy는 정식 지원 중이나 Databricks는 정식 지원 예정)
Iceberg가 "데이터의 공용 규격"이었다면, Apache Ossie는 "의미의 공용 규격"입니다. 우리 관점에서 이것은 지표 정의를 특정 BI 도구에 묶지 않기 위한 장기 안전장치입니다.
결론 — 지금까지의 성과와 남은 과제
이번 여정의 성과는 네 가지로 요약됩니다.
• 플랫폼 한계 해소 — 비즈니스 수용 제한을 걷어내고 동시성 조회 성능을 2배 향상, 이후로도 SaaS 기반의 지속 발전 경로 확보
• BI 서비스 혁신 — 셀프 대시보드/리포트 활성화, 엑셀·Teams 등 업무 접점에서의 편의성 향상
• AI 분석 체계 — Universal AI 단일 진입점, 답변 정제, 복합 답변, 다수 Agent 통합 관리
• AI Ready 데이터 플랫폼 — Best of Breed 구조 최적화와 Semantic Layer 표준화·상호운용성 확보
남은 과제도 분명합니다. AI Ready 플랫폼으로 완성되기 위해, 데이터의 의미를 표준화하고 AI Agent가 정확한 일을 하게 만들고 AI Agent를 활용함으로써 실제 일이 개선되는 사례를 만들고 전파해야 합니다.
기존에는 데이터 분석 자체가 업무였다면 앞으로는 이 플랫폼을 사용함으로써 Agent의 분석 도움을 받아 더 쉽고 빠르게 의사결정을 하고 가치를 만들어 내는 것에 집중할 수 있게 하는 것이 결국 이 플랫폼의 마지막 과제입니다.
감사합니다.