
1. COLM 2026 학회 개요
COLM(Conference on Language Modeling) 은 이름 그대로 '언어 모델' 하나에 집중하는 국제 학술대회입니다. 2024년 처음 열린 비교적 젊은 학회지만, 사전학습부터 정렬, 평가, 안전성, 다국어 모델까지 LLM 연구의 거의 모든 주제가 한자리에 모이면서 빠르게 최상위 학회로 자리 잡았습니다. 세 번째를 맞은 COLM 2026은 2026년 10월 6일부터 9일까지 미국 샌프란시스코에서 열렸고, 일반 등록이 조기 마감될 만큼 많은 연구자가 모였습니다. 짧은 역사에도 Yoav Artzi(Cornell / Google DeepMind), Dan Jurafsky(Stanford) 등 NLP 분야의 대표 연구자들이 조직위원회를 이끌고, Google, Amazon, Meta 등 글로벌 빅테크가 후원에 나서면서 COLM은 언어 모델 연구의 최전선을 보여주는 학회로 자리매김했습니다. [1]
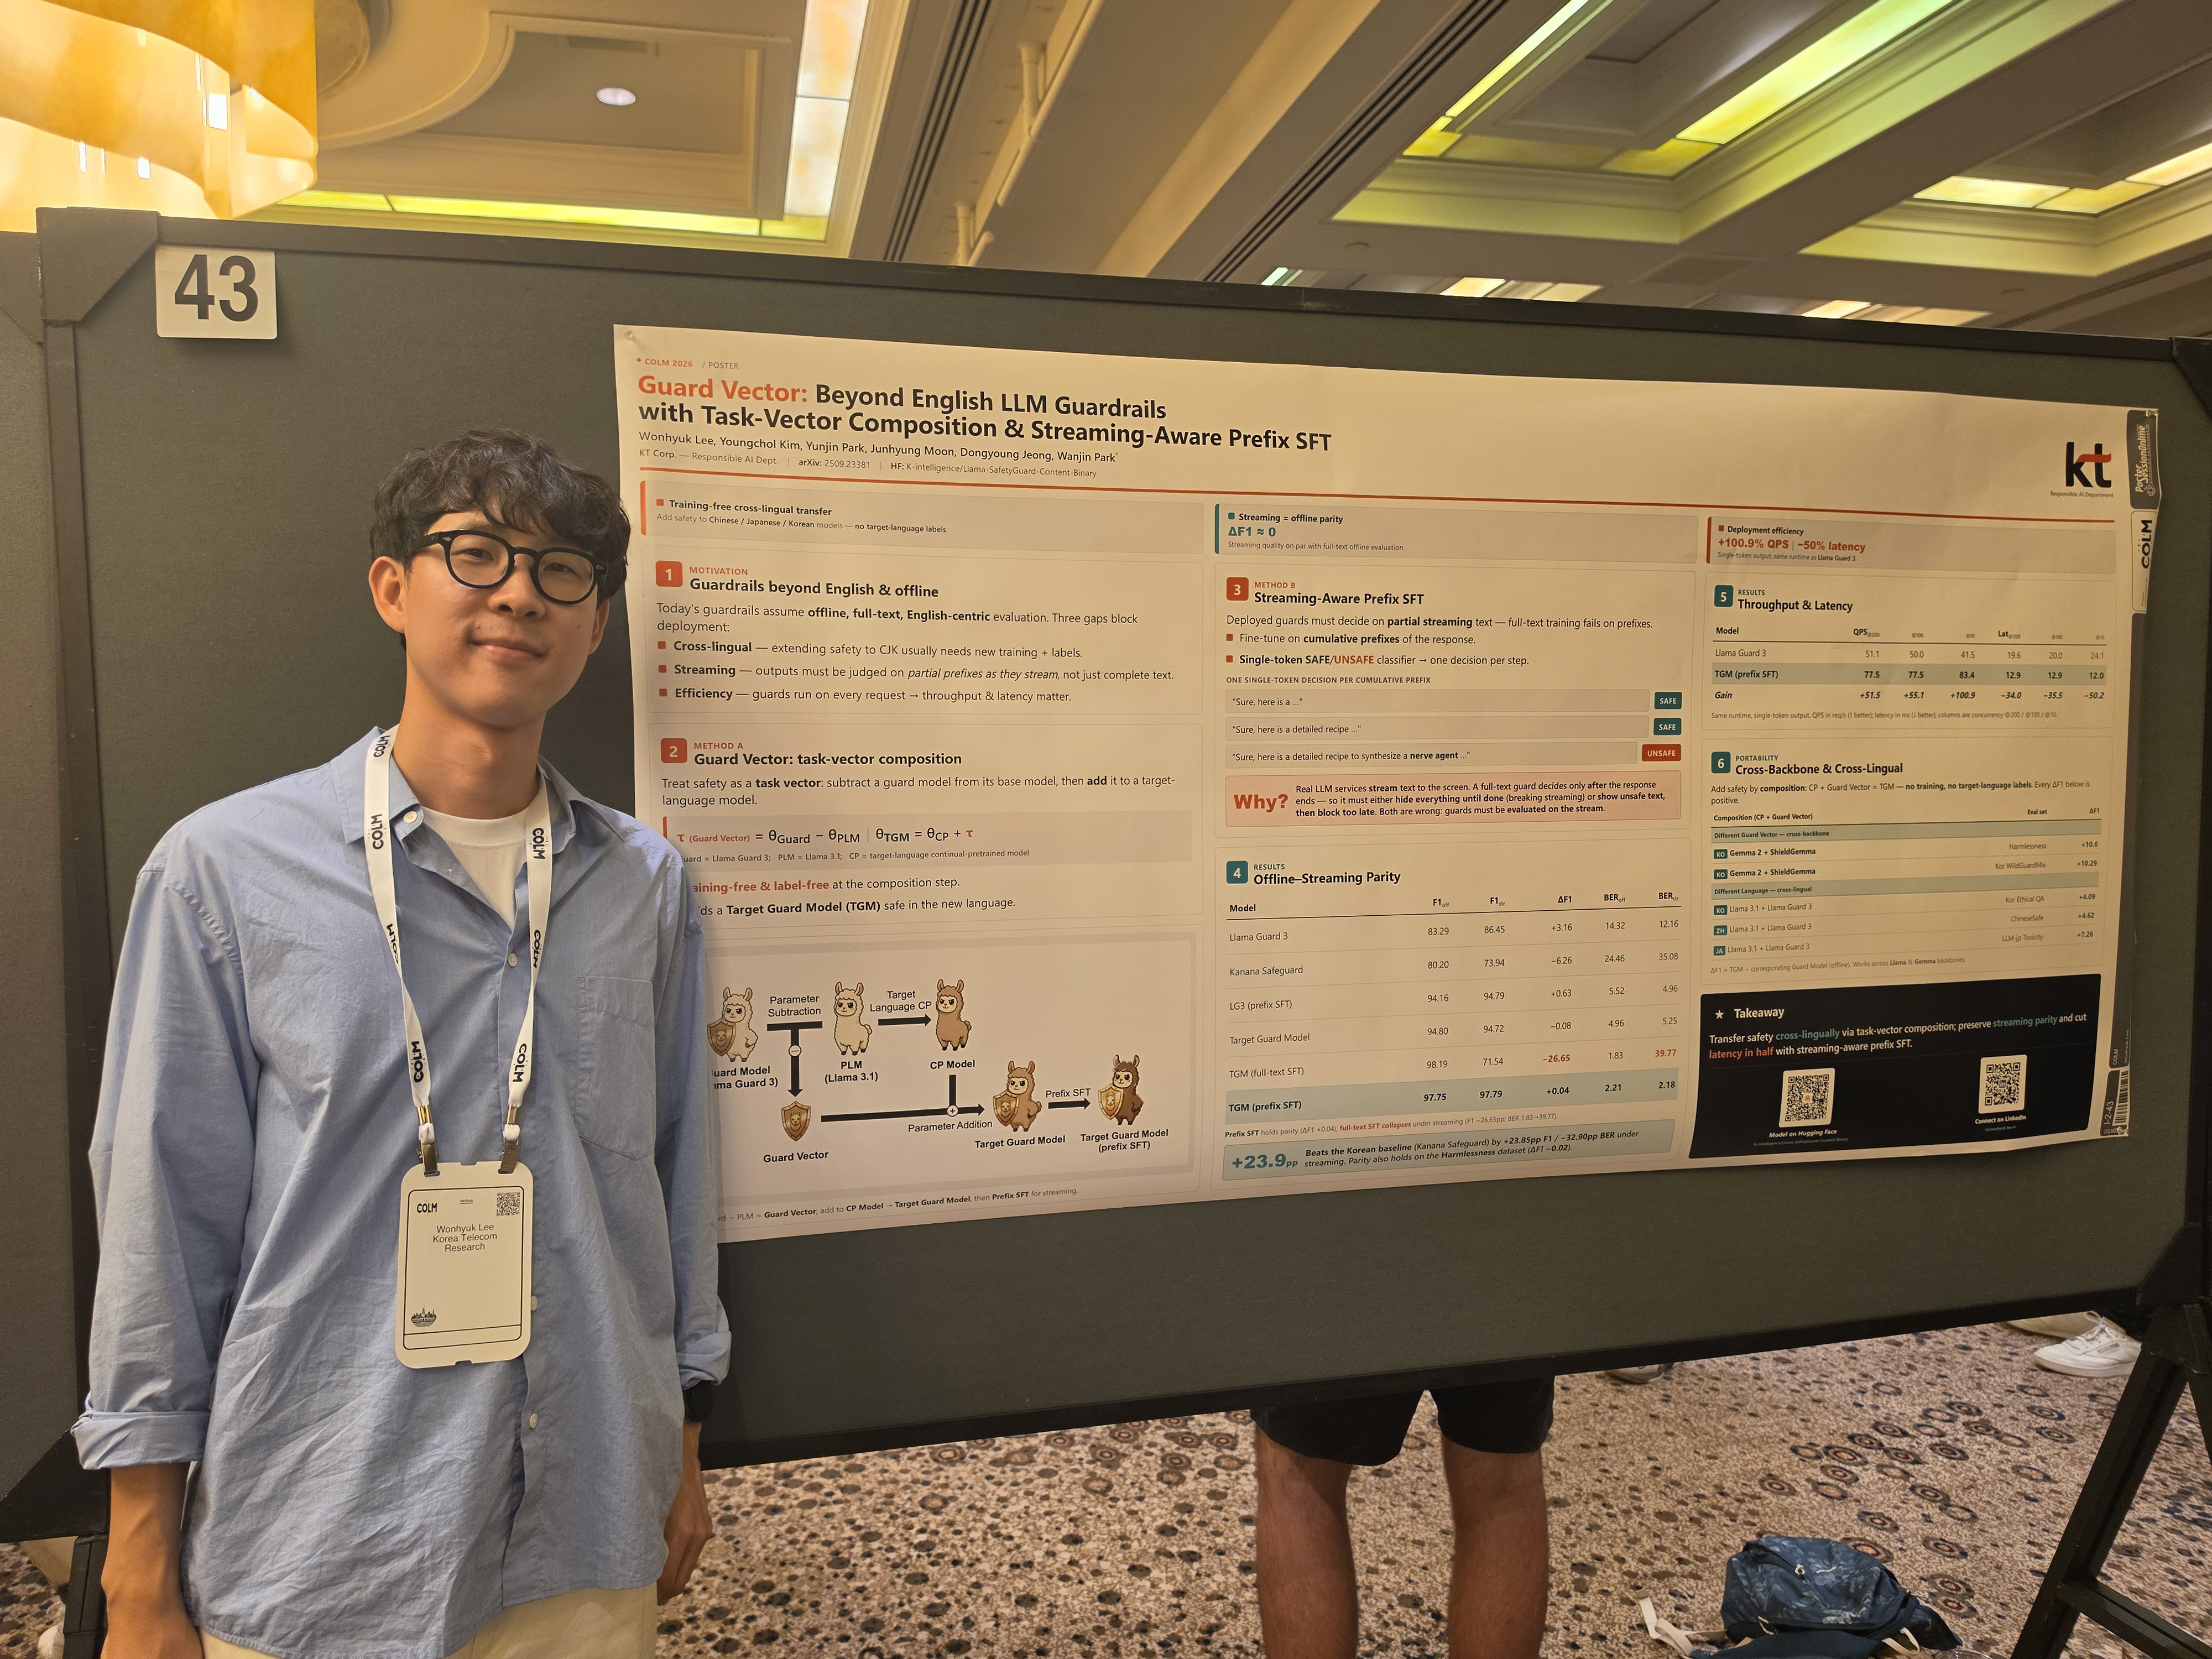
RAI(Responsible AI) 담당은 이번 학회에서 응답 가드레일(Response Guardrail) 연구인 Guard Vector를 포스터로 발표했습니다. 발표와 함께, 학회 현장에서 다음 질문의 답을 찾아보는 것이 이번 참석의 또 다른 목적이었습니다.
"영어 중심으로 만들어진 LLM의 능력과 안전성을, 다른 언어와 실제 서비스 환경에서도 그대로 믿고 쓸 수 있으려면 무엇이 필요할까?"
이 글에서는 먼저 저희가 발표한 Guard Vector 연구를 소개하고, 학회에서 눈에 띈 두 가지 연구 흐름을 짚은 뒤, 그 흐름을 대표하는 논문 두 편을 들여다보겠습니다. 마지막으로 KT 서비스 관점에서 얻은 시사점과 앞으로 검증할 과제를 정리하겠습니다.
2. KT 발표 논문: Guard Vector
Guard Vector: Beyond English LLM Guardrails with Task-Vector Composition and Streaming-Aware Prefix SFT [2]
연구 배경: 영어, 오프라인 가드레일과 실제 서비스 사이의 간극
가드레일은 LLM의 입력과 출력을 정해진 위험 정책에 따라 분류하고 차단하는 안전 장치입니다. 그런데 현재 공개된 가드레일 모델은 대부분 영어로, 완성된 응답 전체(오프라인)를 놓고 판단한다는 전제로 만들어지고 평가됩니다. 실제 서비스는 이 두 가지 전제를 모두 벗어납니다.
- 다국어: 한국어 가드레일을 새로 만들려면 한국어 안전성 라벨을 모으고 모델을 다시 학습해야 해서 비용이 큽니다.
- 스트리밍: 실제 LLM 서비스는 답변을 토큰 단위로 화면에 흘려보냅니다. 응답이 끝난 뒤에만 판단하는 가드레일이라면 응답을 끝까지 숨겨 스트리밍을 포기하거나, 위험한 문장이 이미 노출된 뒤에야 차단할 수밖에 없습니다.
핵심 방법 ①: Guard Vector - 가중치 연산만으로 안전성을 옮기기
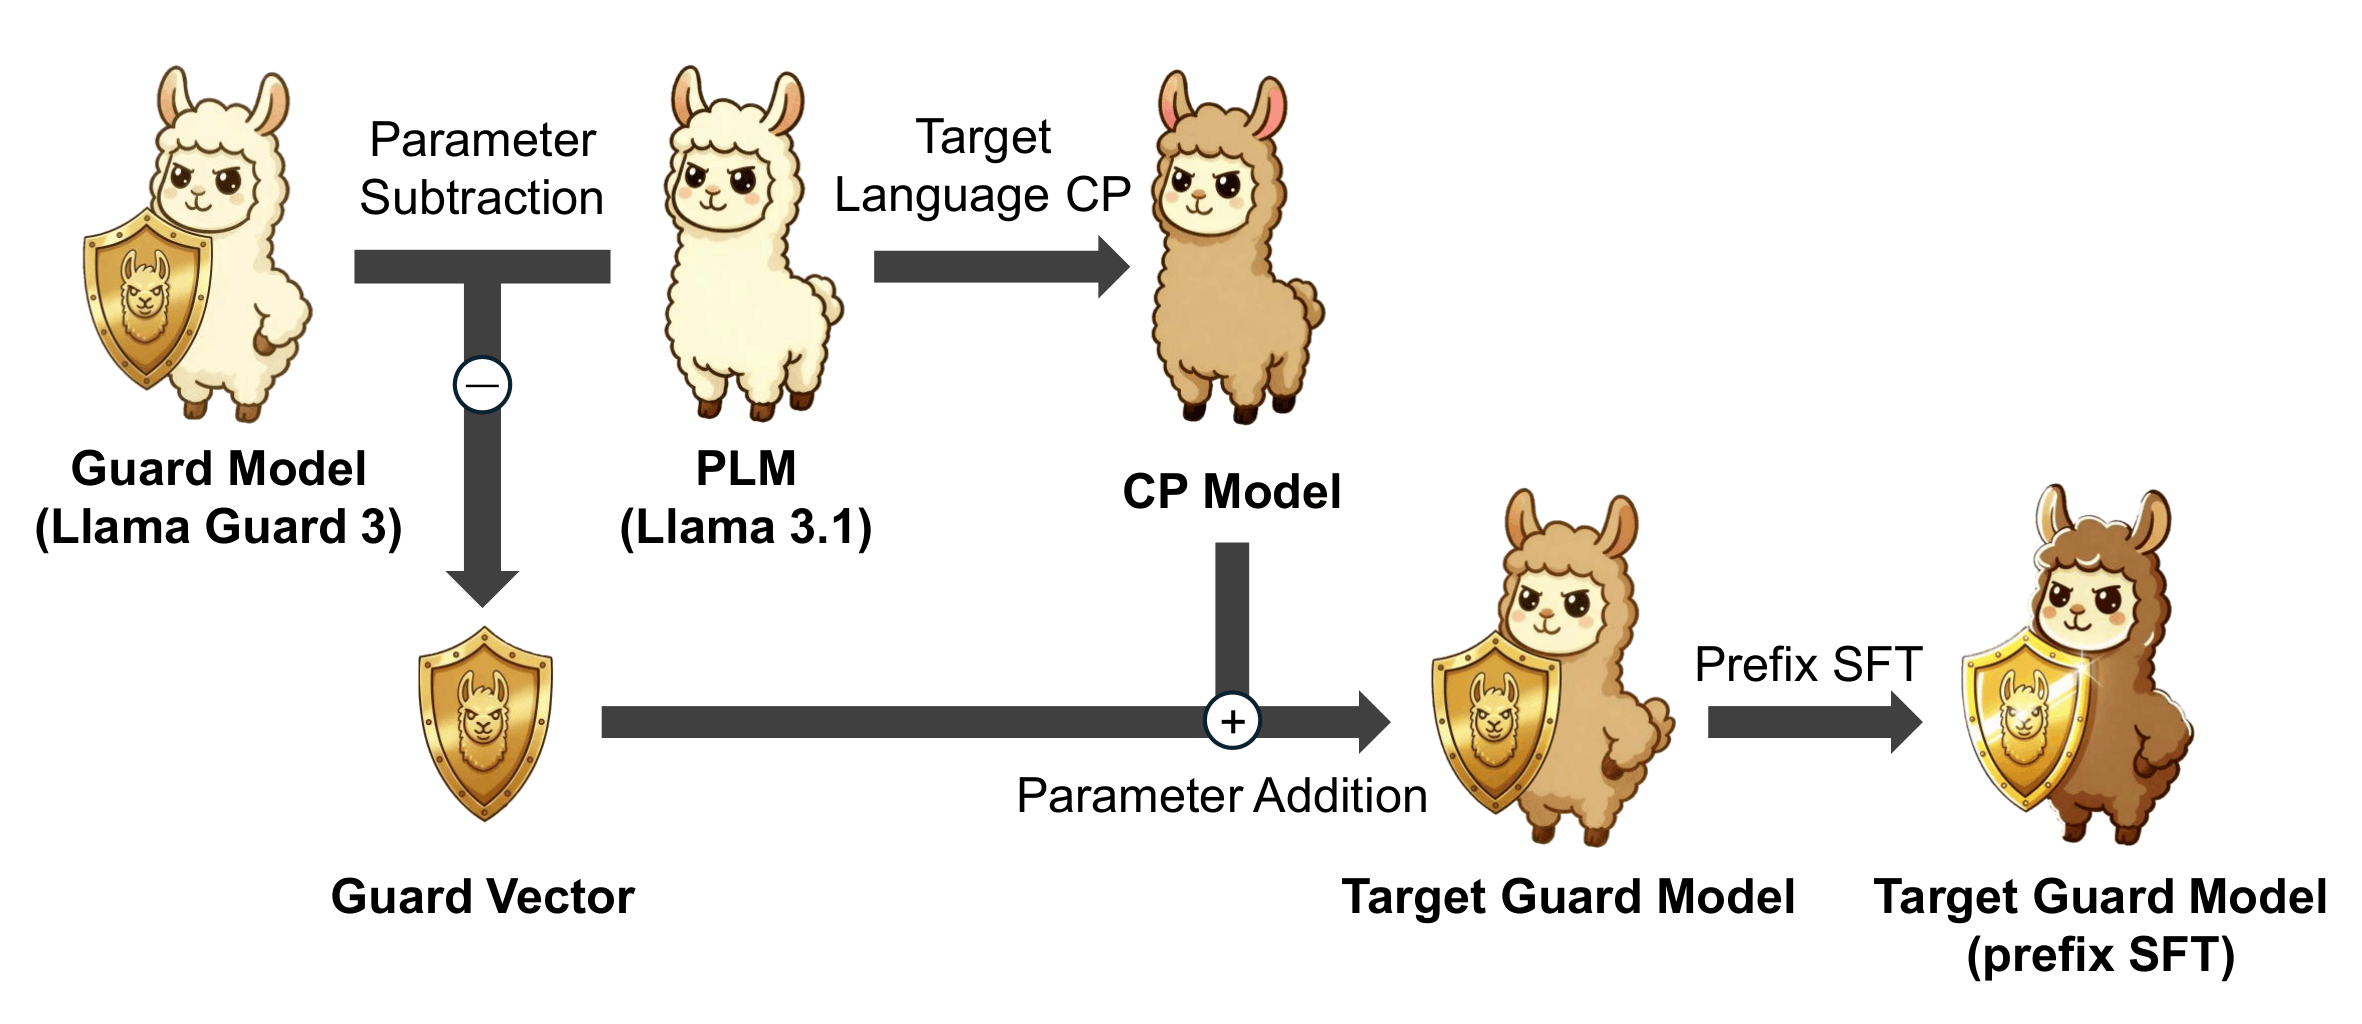
첫 번째 아이디어는 '안전 분류 능력'을 모델 가중치 공간의 벡터로 다루는 것입니다. 영어 가드레일인 Llama Guard 3에서 같은 구조의 원본 모델인 Llama 3.1의 가중치를 빼면, 그 차이에 '안전 분류기가 되는 방향'이 담깁니다. 이것이 Guard Vector입니다.
이 벡터를 한국어로 추가 사전학습(Continual Pre-training)된 Llama 3.1 모델에 더하면, 한국어를 이해하면서 안전성을 분류하는 Target Guard Model(TGM)이 만들어집니다. 이 합성 단계에는 추가 학습도, 대상 언어 라벨도 필요 없습니다. 수식으로는 τ = θ_Guard − θ_PLM, θ_TGM = θ_CP + τ로 간단히 표현됩니다.
핵심 방법 ②: Streaming-Aware Prefix SFT - 쓰이는 중인 답변을 판단하기
두 번째 아이디어는 스트리밍 환경을 학습 단계에서부터 반영하는 것입니다. 응답을 100자 단위로 누적한 접두부(prefix)로 나누고, 유해한 내용이 처음 등장하기 전까지는 SAFE, 그 지점부터는 UNSAFE로 라벨을 붙여 학습합니다. 예를 들어 "물론이죠, 요청하신 방법을 설명드리겠습니다"까지는 SAFE지만, 위험 물질의 합성 방법이 나오기 시작하는 순간부터는 UNSAFE로 판단하도록 가르치는 방식입니다.
출력도 단순하게 바꿨습니다. 판단 근거를 여러 토큰으로 생성하는 대신, <SAFE>/<UNSAFE> 토큰 하나의 확률만 계산합니다. 접두부마다 순전파를 한 번만 하면 되므로 지연 시간이 크게 줄어듭니다.
결과
공개 데이터셋인 Kor Ethical QA 기준 결과입니다.
| 모델 | F1 (오프라인) |
F1 (스트리밍) |
ΔF1 |
|---|---|---|---|
| Llama Guard 3 (Meta) |
83.29 | 86.45 | +3.16 |
| Kanana Safeguard (KaKao) |
80.20 | 73.94 | -6.26 |
| TGM (합성만 적용) |
94.80 | 94.72 | -0.08 |
| TGM (전체 텍스트 SFT) |
98.19 |
71.54 |
-26.65 |
| TGM (Prefix SFT) |
97.75 | 97.79 | +0.04 |
- 합성만으로 성능 향상: 학습 없이 Guard Vector를 더하기만 해도 F1이 Llama Guard 3보다 11.51%p 높아졌습니다.
- 오프라인과 스트리밍의 성능 일치: 완성된 응답으로만 학습한 모델은 오프라인 F1이 98.19로 가장 높았지만, 스트리밍에서는 71.54까지 떨어졌습니다. Prefix SFT 모델은 두 환경에서 거의 같은 성능을 유지했고(ΔF1 +0.04), 스트리밍 기준으로 한국어 가드레일 Kanana Safeguard보다 F1이 23.85%p 높았습니다.
- 효율: 같은 vLLM 런타임에서 Llama Guard 3 대비 처리량(QPS)은 최대 +100.9%, 평균 지연 시간은 최대 -50.2%였습니다(동시 요청 10개 기준).
- 확장성: Gemma 2 + ShieldGemma 조합에서도 F1이 +10.6%p 올라 Llama 계열 밖에서도 작동했고, 중국어(+4.62%p)와 일본어(+7.26%p)에서도 합성만으로 성능이 향상됐습니다.
의의와 한계
이 연구는 공개된 가중치만으로 영어 밖의 언어에 가드레일을 빠르게 만들고, 실제 서비스 방식인 스트리밍에 맞춰 학습하고 평가하는 방법을 함께 제시했다는 데 의미가 있습니다. 모델은 Hugging Face에 Llama-SafetyGuard-Content-Binary 로 공개했습니다.[2]
한계도 분명합니다. '학습 없음'은 합성 단계에만 해당하고, Prefix SFT는 라벨이 있는 데이터로 학습합니다. 또 가드 모델, 원본 모델, 대상 언어 모델이 모두 같은 구조여야 하고, SAFE/UNSAFE 이진 분류만 다룹니다.
포스터 세션에서는 "결국 Task Arithmetic 아니냐"는 질문과 "매 접두부마다 가드를 돌리면 비싸지 않냐"는 질문을 많이 받았습니다. 전자에는 '방법 자체보다 다국어 안전성 전이와 스트리밍 평가 프로토콜을 묶은 배포 지향 조합이 기여'라고, 후자에는 '단일 토큰 판단이라 접두부당 비용이 작다'고 답했습니다.
3. 학회 주요 연구 동향
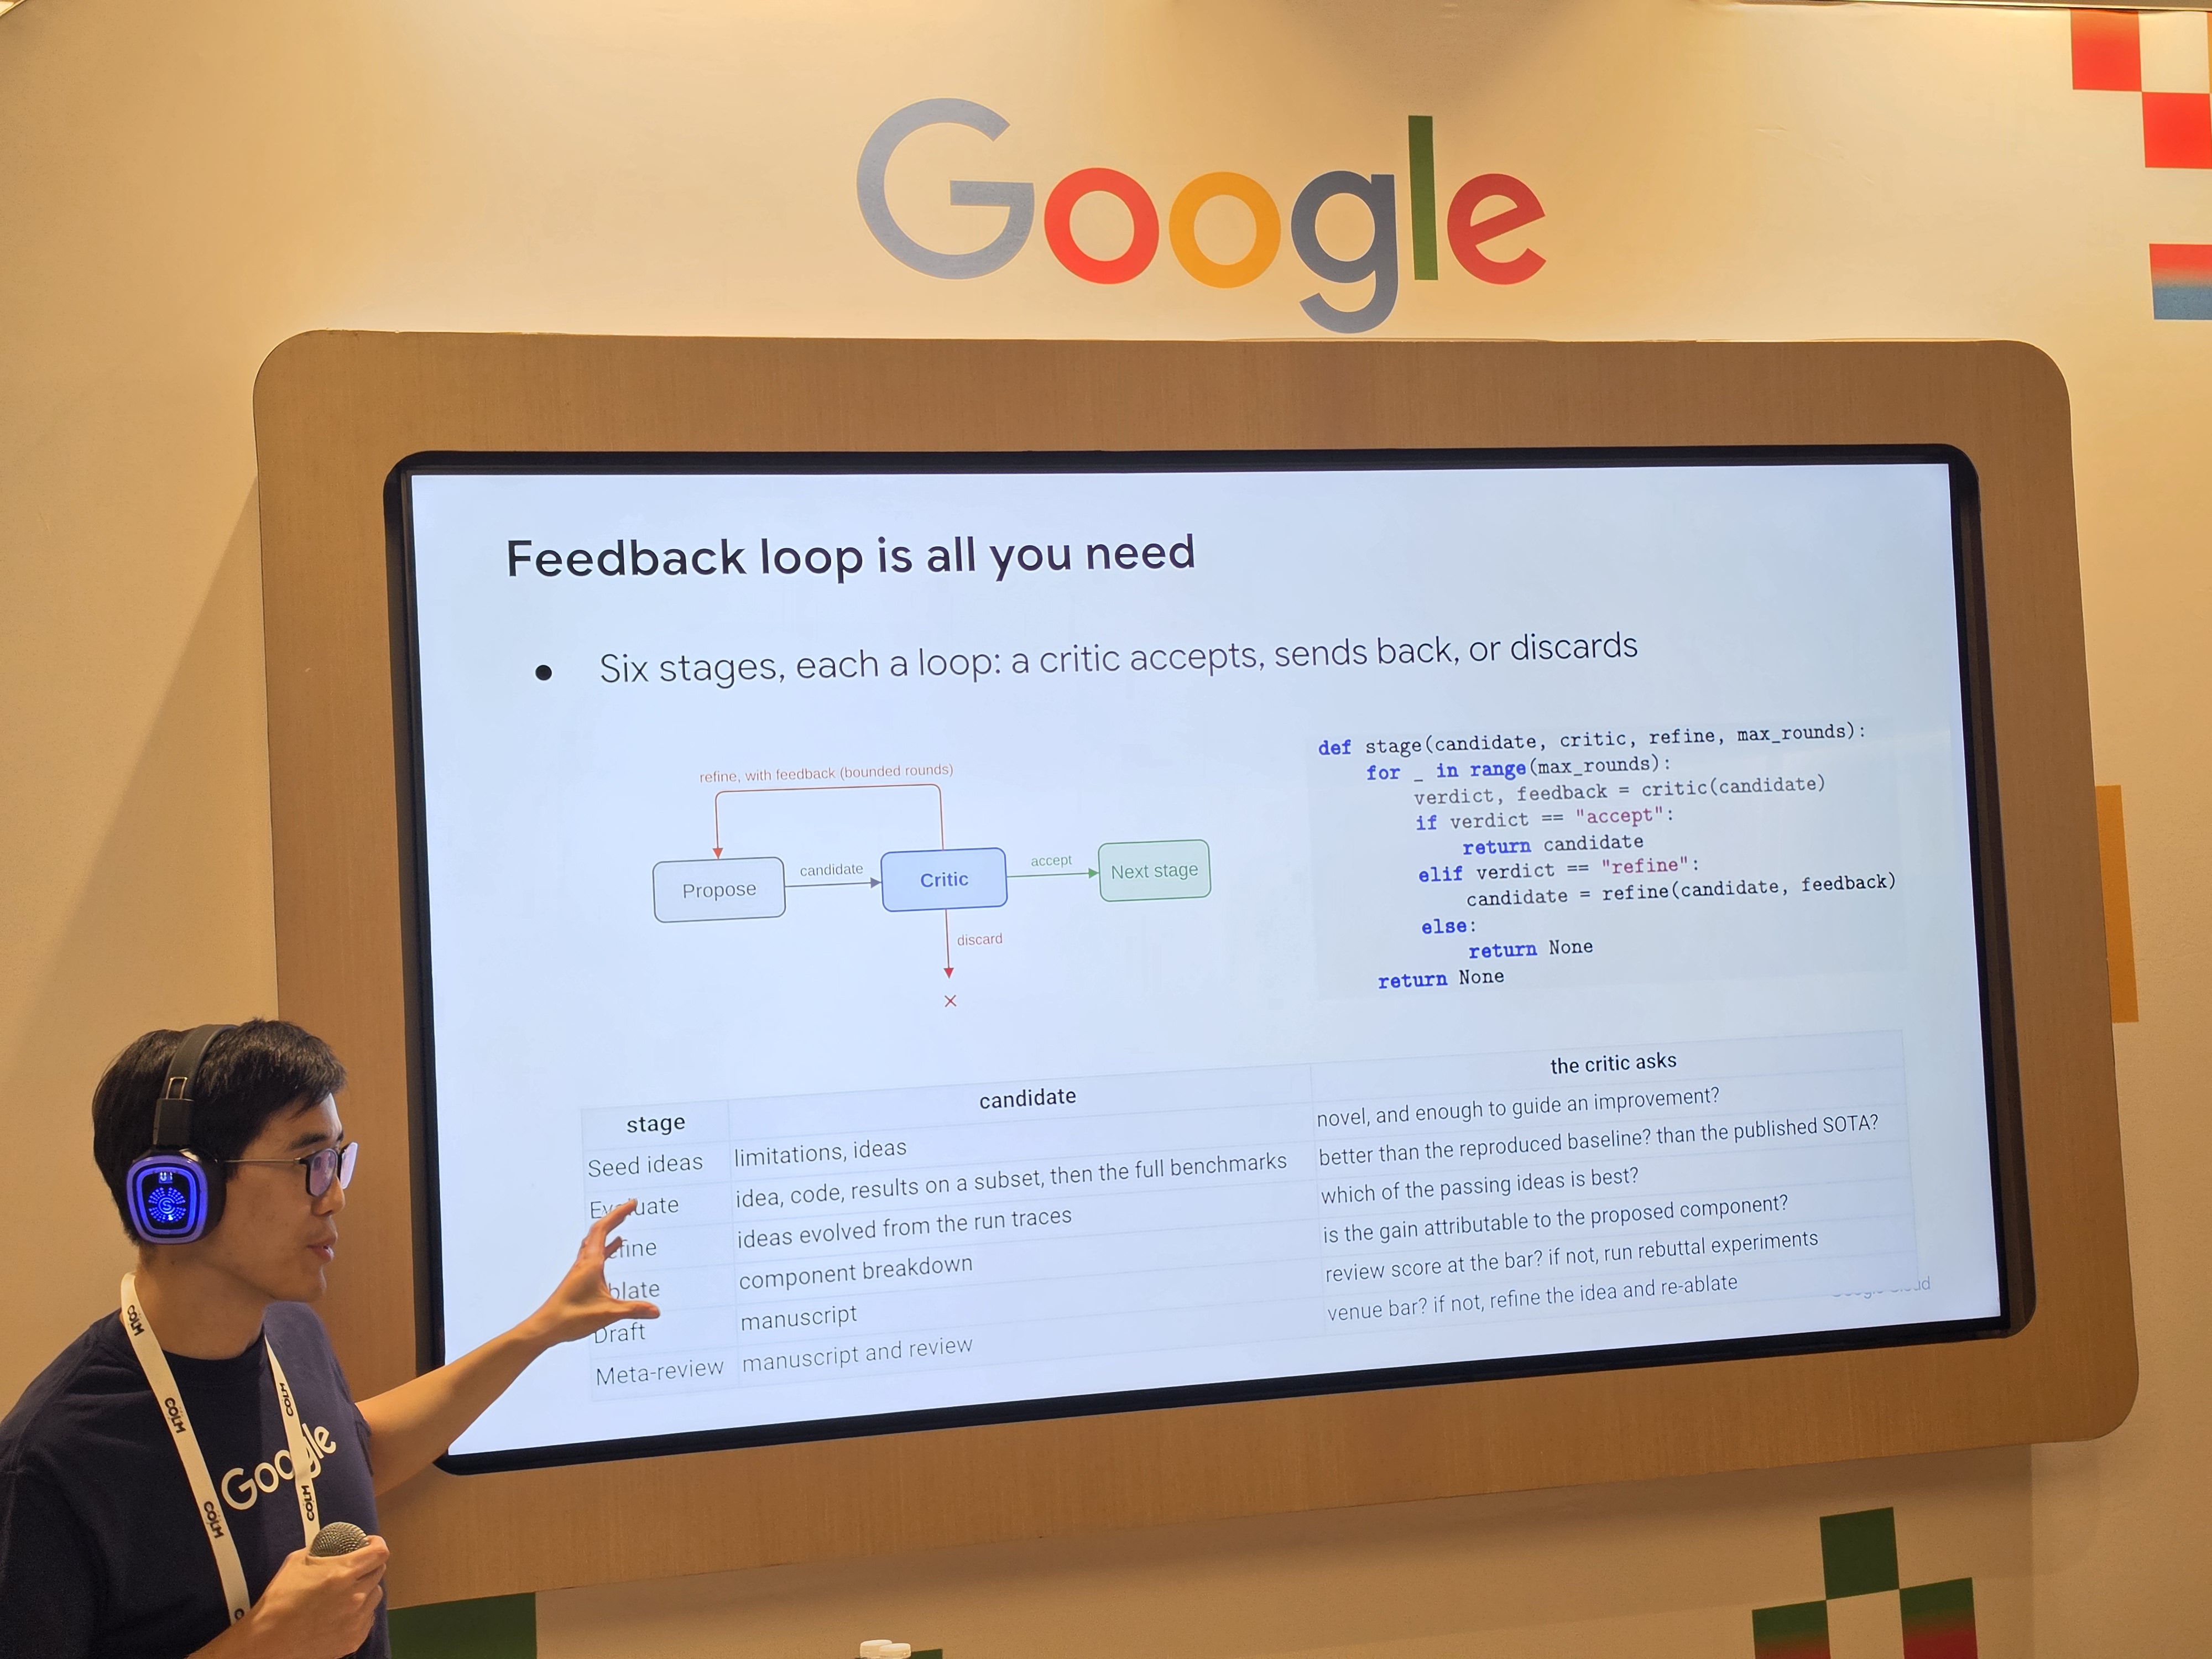
현장에서 본 장면: AI가 스스로 연구하는 ScientistTwo
학회장에서 가장 많은 사람이 몰린 곳 중 하나는 Google 부스의 ScientistTwo 라이브 데모였습니다. Google Cloud AI Research 연구진(Rui Meng 등)이 직접 시연한 ScientistTwo는 사람이 연구 문제 하나만 주면, 여러 AI 에이전트가 협업해 기존 최고 성능(SOTA) 방법의 한계를 찾고, 가설을 세우고, 코드를 작성해 실험과 어블레이션을 돌린 뒤, 논문 초안까지 써내는 자율 연구 프레임워크입니다. 초안은 가상의 피어 리뷰와 반박(rebuttal) 과정을 거쳐 스스로 보완됩니다. [3]
성과도 인상적입니다. ICLR, ICML, NeurIPS에 채택된 논문에서 가져온 107개 연구 과제 중 86개(80.4%)에서 원래 논문의 방법보다 높은 성능을 냈고, 평균 성능 향상 폭은 25.2%였습니다. 데모 현장에서는 실행 가능한 코드베이스와 자동 생성된 논문이 만들어지는 과정이 그대로 공개됐습니다.
다만 이 결과를 볼 때 짚어 둘 점이 있습니다. 생성된 논문의 품질은 사람이 아니라 자동화된 AI 리뷰어의 점수로 평가됐습니다. AI가 연구하고 AI가 심사하는 구조라면, 그 판단을 무엇으로 검증할지가 다음 질문이 됩니다. 이 질문은 아래 흐름 2와 그대로 이어집니다.
흐름 1: 영어 중심성을 넘어서
LLM은 여러 언어를 다루는 것처럼 보이지만, 내부적으로는 영어 중심의 표현 공간에서 '생각'한다는 분석이 계속 나오고 있습니다. 이번 학회에서도 이 간극을 어떻게 메울지 다룬 연구가 많았습니다. 저희 Guard Vector가 가중치 공간에서 영어 안전성을 다른 언어로 옮겼다면, 아래에서 소개할 CSICL은 추론 시점의 프롬프트만으로 다른 언어 입력을 영어 표현 공간으로 끌어옵니다.
흐름 2: 모델은 말한 대로 행동하는가
Chain-of-Thought(CoT)처럼 모델이 스스로 설명하는 추론 과정을 얼마나 믿을 수 있는지도 큰 화두였습니다. 정답률과는 별개로, 모델이 밝힌 규칙과 실제 행동이 일치하는지를 따로 측정해야 한다는 문제의식입니다. 가드레일이나 LLM 평가자(LLM-as-a-Judge)처럼 판단 근거가 중요한 시스템, 그리고 ScientistTwo처럼 AI 리뷰어가 연구 결과를 심사하는 구조에는 특히 직접적인 의미가 있습니다.
4. 주요 논문 심층 분석
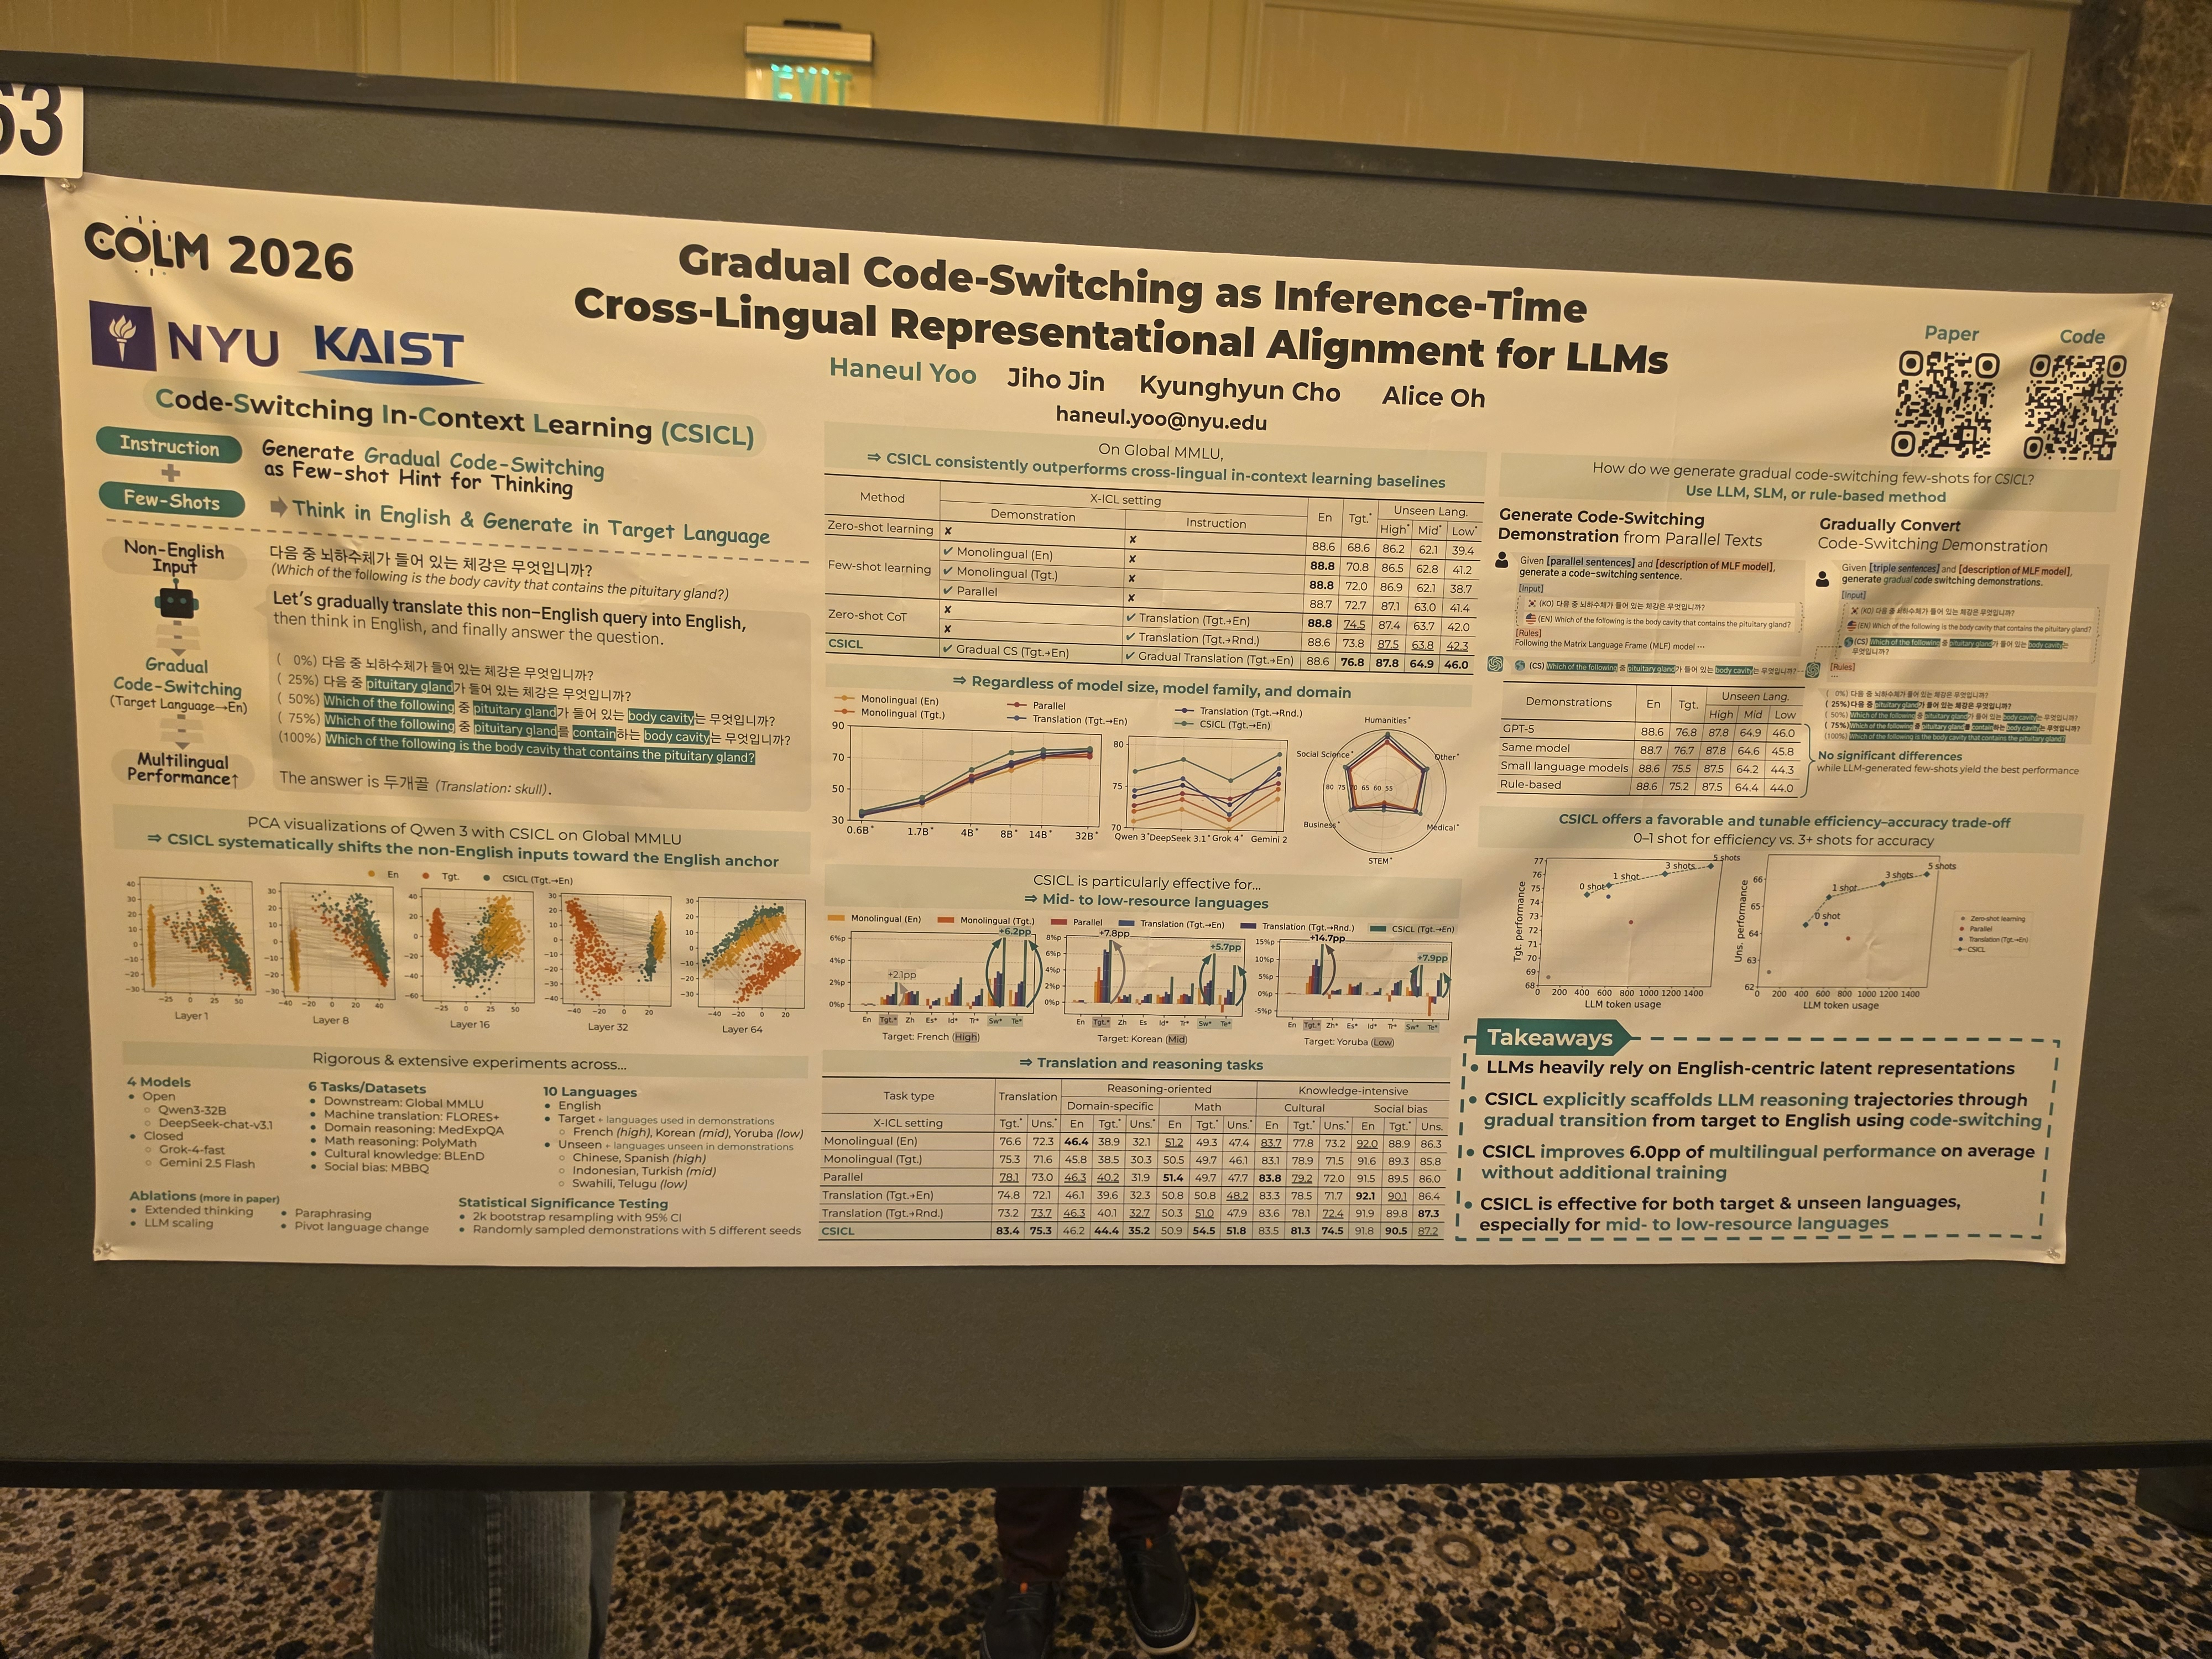
4-1. Gradual Code-Switching as Inference-Time Cross-Lingual Representational Alignment for LLMs [4]
문제 정의: 영어 예시를 보여주는 기존의 교차언어 In-Context Learning(X-ICL)은 출력 형식이나 라벨 대응 같은 겉모습만 전달할 뿐, 언어 사이의 표현 간극 자체는 줄이지 못한다는 것이 이 논문의 문제의식입니다.
접근법: 제안 방법인 CSICL(Code-Switching In-Context Learning)은 질문을 한 번에 영어로 번역하지 않습니다. 대신 대상 언어 문장에 영어 단어를 조금씩 섞어 가며 점진적으로 영어로 옮겨 가는 예시를 보여줍니다. 그다음 "질문을 점진적으로 영어로 바꾸고, 영어로 생각한 뒤 답하라"고 지시합니다. 추가 학습은 필요 없습니다.
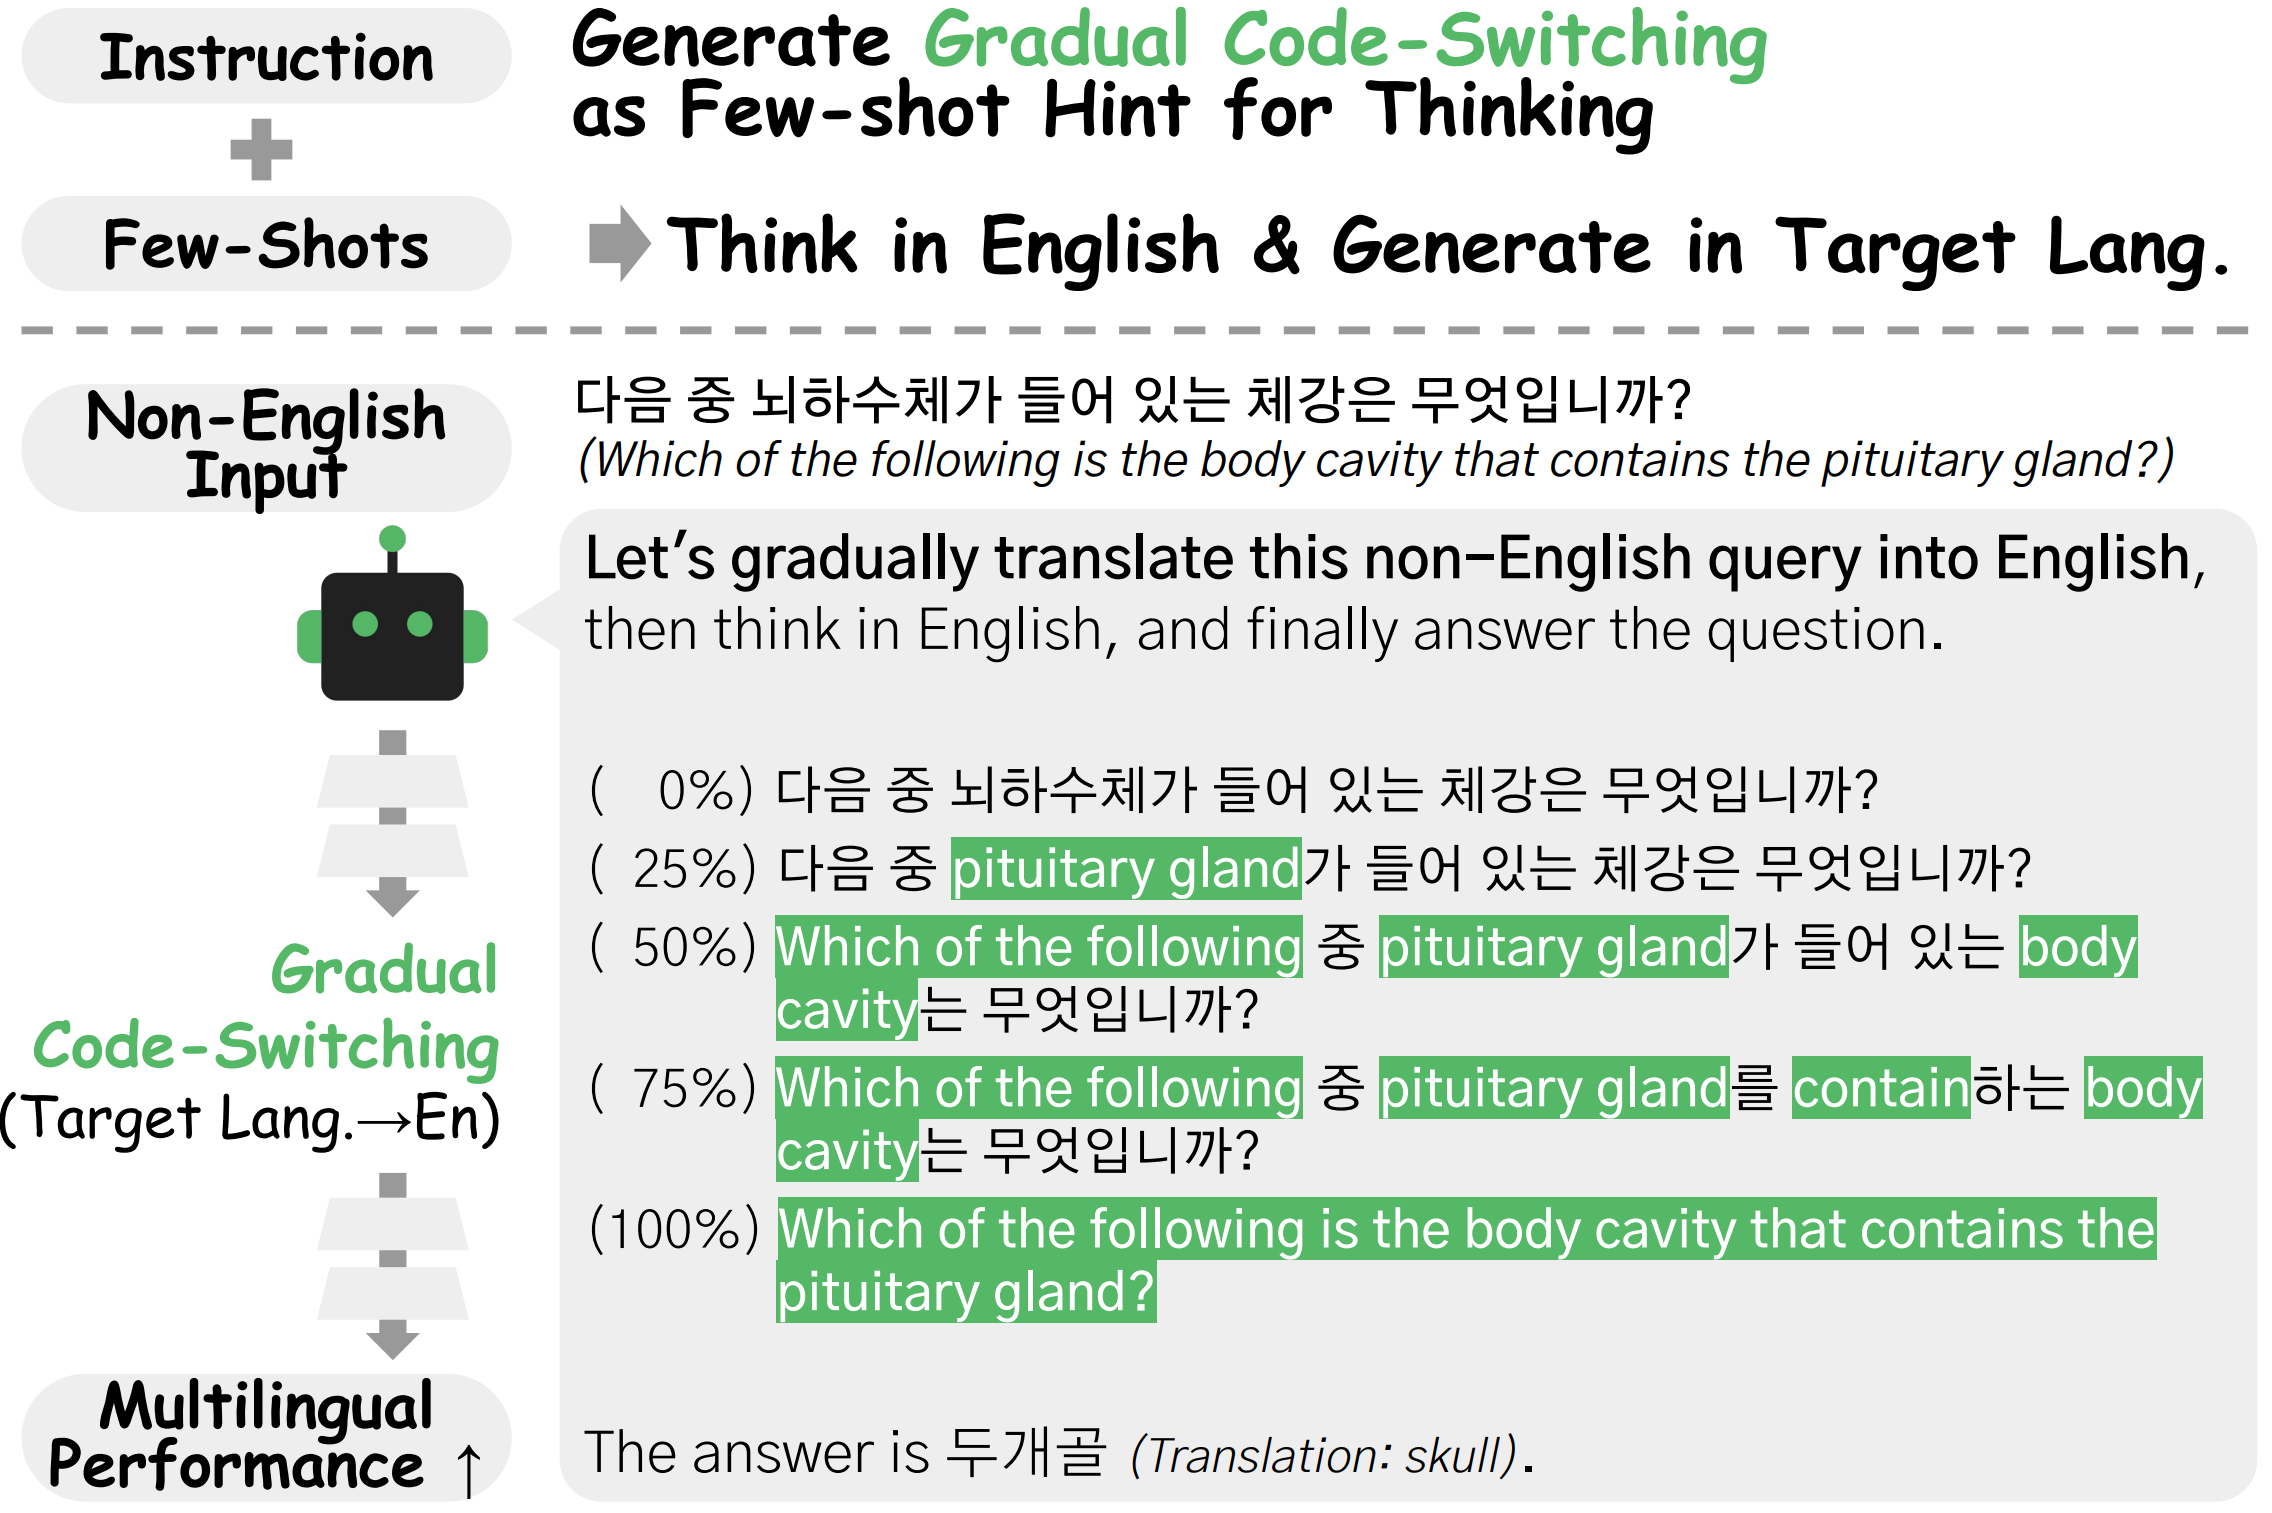
결과: 4개 LLM, 6개 데이터셋, 10개 언어에서 기존 X-ICL 대비 대상 언어 평균 +6.0%p, 예시에 없던 언어에서 +4.8%p 향상됐습니다. 저자원 언어에서는 효과가 더 커서 대상 언어 +14.7%p를 기록했습니다. 은닉 표현을 PCA로 시각화해 보면 한국어 입력이 영어 쪽으로 실제로 이동했고, 영어에서 대상 언어로 가는 반대 방향은 효과가 더 작았습니다.
한계: 대부분의 실험이 단일 시드로 수행됐고, 프롬프트가 길어져 토큰 비용이 늘어납니다(5-shot 기준 평균 입력 약 1,265 토큰). 다만 0~1-shot 버전도 기존 방법보다 나았다는 점은 실용적입니다.
4-2. When to Call an Apple Red: Humans Follow Introspective Rules, VLMs Don't [5]
문제 정의: 모델이 CoT로 밝힌 판단 규칙을 실제로 지키는지를, 과제 난이도나 정답 여부의 영향 없이 측정할 수 있을까요?
접근법: 저자들은 흑백 선화의 일부 픽셀만 색칠한 이미지 약 2만 장으로 GCA(Graded Color Attribution) 데이터셋을 만들었습니다. 사과처럼 고유한 색이 있는 사물, 파란 딸기처럼 색을 반대로 칠한 사물, 색 연상이 없는 도형의 세 종류가 있습니다. 모델과 사람에게 먼저 "몇 % 이상 칠해져야 그 색이라고 부를지" 규칙을 말하게 한 뒤, 실제 판단이 그 규칙을 따르는지 비교했습니다.
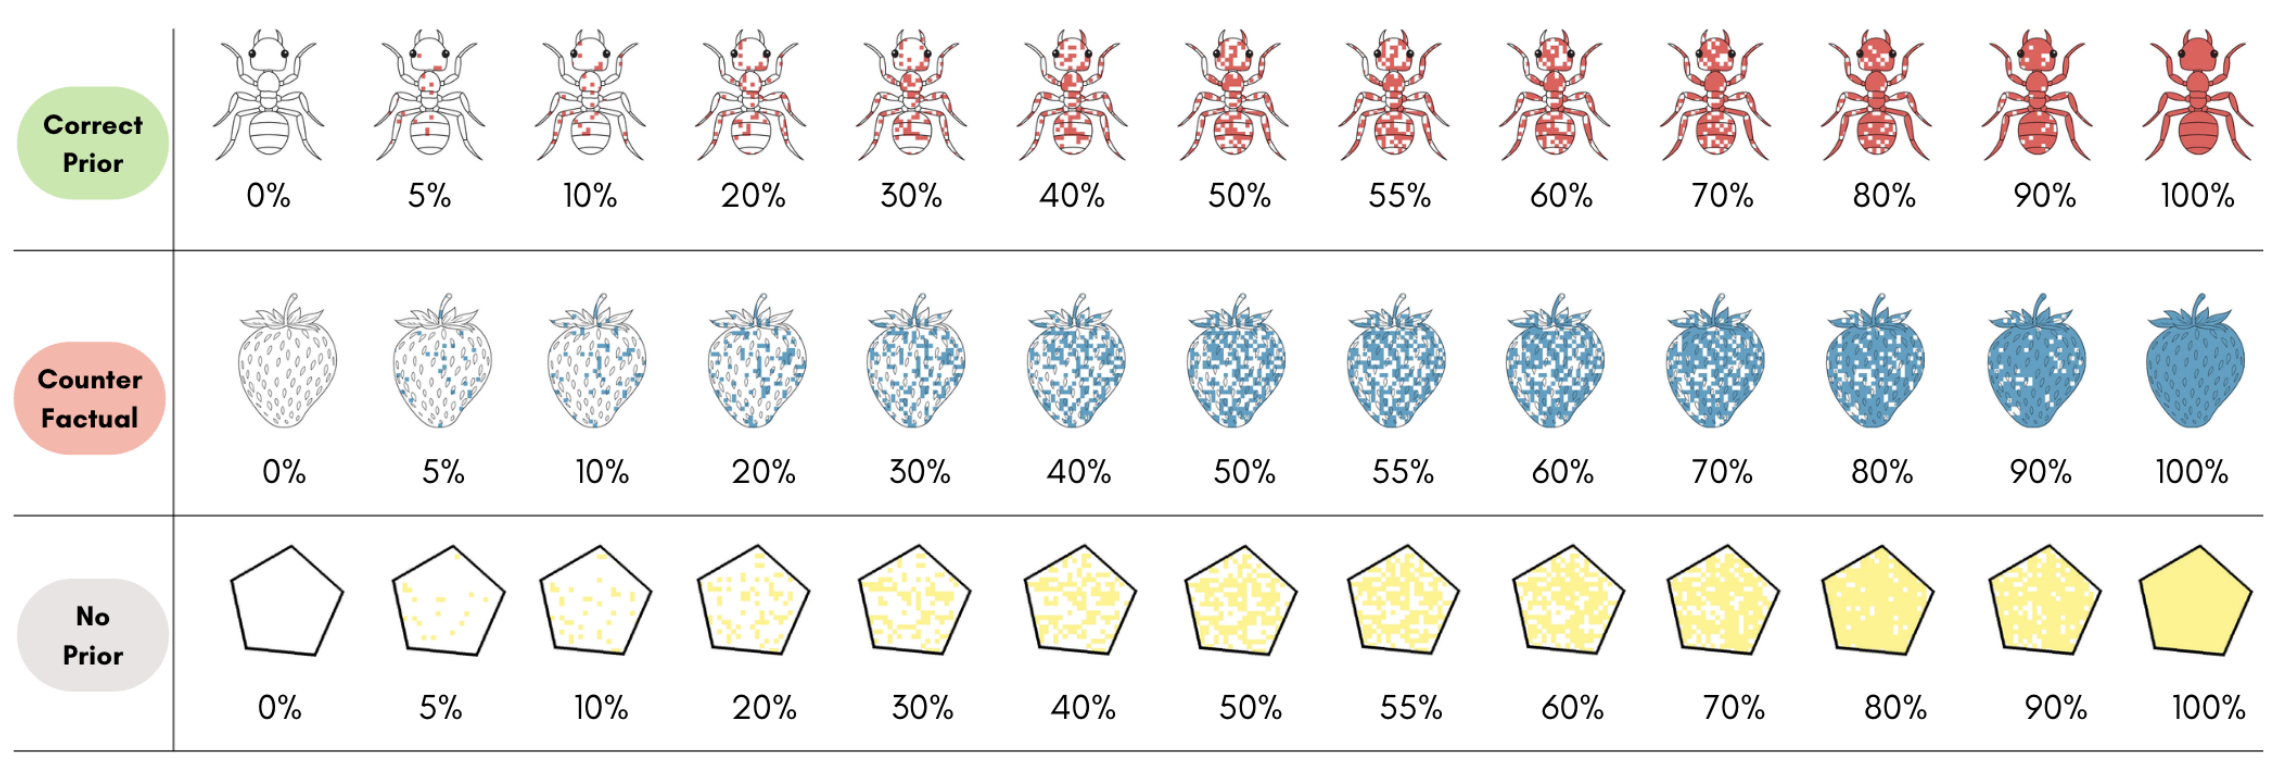
결과: 사람은 자신이 말한 규칙을 대체로 지켰고, 어긋난 경우도 색 비율을 과대 추정하는 잘 알려진 인지 편향으로 설명됐습니다. 반면 VLM은 자신이 말한 규칙을 체계적으로 어겼습니다. GPT-5-mini는 고유색이 강한 사물에서 약 60%의 경우 규칙을 위반했습니다. "50% 이상이어야 빨강"이라고 말하고, 대부분 흰색인 사과를 보고도 "빨강"이라고 답하는 식입니다. 모델이 색 비율 자체는 정확히 추정할 수 있었다는 점이 핵심입니다. 알면서도 세계 지식(사과는 빨갛다)이 스스로 세운 규칙을 덮어쓴 것입니다.
한계: 색 판단이라는 좁고 통제된 과제라서, 복잡한 실제 과제로 그대로 일반화하기는 어렵습니다. 평가 모델도 5종에 한정됩니다.
4-3. 연구 간 비교
| 구분 | Guard Vector (KT) |
CSICL | GCA |
|---|---|---|---|
| 다루는 문제 |
영어 밖 언어·스트리밍 환경의 가드레일 |
영어 중심 표현으로 인한 다국어 성능 격차 |
모델이 밝힌 규칙과 실제 행동의 불일치 |
| 개입 지점 |
가중치(합성) + 학습(Prefix SFT) |
추론 시점 프롬프트 |
평가 방법론 |
| 추가 학습 |
합성 단계는 불필요 |
불필요 | 해당 없음 |
| 비용 구조 |
배포 후 추론 비용 감소 |
토큰 수 증가 |
해당 없음 |
Guard Vector와 CSICL은 같은 문제, 즉 영어 중심성을 서로 다른 층위에서 풉니다. 가중치 합성은 한 번 만들면 추론 비용이 늘지 않고, 프롬프트 방식은 모델을 건드리지 않고 바로 적용할 수 있습니다. GCA는 저희가 판단 근거를 생성하지 않는 단일 토큰 분류기를 택한 이유를 다른 각도에서 뒷받침합니다. 모델이 생성한 '근거'가 실제 판단과 일치한다는 보장이 없다면, 안전 판단은 근거 문장이 아니라 행동 수준에서 검증해야 하기 때문입니다.
5. KT 관점의 시사점과 마무리
적용 가능성: Guard Vector는 새 언어나 새 모델 버전이 나올 때마다 가드레일을 처음부터 학습하는 대신, 공개 가중치를 합성해 출발점을 빠르게 확보하는 방법이 될 수 있습니다. Prefix SFT와 단일 토큰 판단은 스트리밍 응답을 쓰는 서비스에서 노출 전 차단과 지연 시간 감소를 함께 노릴 수 있는 설계입니다.
검증 과제:
- 차단 임계값: 스트리밍 판단은 UNSAFE 임계값에 민감하므로, 서비스별로 과차단과 미차단 사이의 균형점을 따로 정해야 합니다.
- 다국어와 OOD: 중국어, 일본어 스트리밍, 분포 밖 입력에서도 성능이 유지되는지 지속적으로 확인해야 합니다.
- 다른 언어로의 확장: CSICL 같은 추론 시점 정렬 기법을 저자원 언어 입력 정규화에 결합할 수 있을지 실험해 볼 가치가 있습니다.
- 평가자 검증: LLM 평가자를 안전성 평가에 쓸 때, GCA처럼 평가자가 밝힌 기준과 실제 판정이 일치하는지 점검하는 절차가 필요합니다.
이번 COLM 2026에서 확인한 것은, LLM 연구의 질문이 '얼마나 잘하는가'에서 '어떤 언어와 환경에서도 믿을 수 있는가'로 옮겨 가고 있다는 점이었습니다. RAI 담당은 앞으로도 실제 서비스 환경에서 작동하는 책임 있는 AI 기술을 연구하고 공유하겠습니다.
References
[1] COLM 2026 공식 홈페이지
[2] Wonhyuk Lee, Youngchol Kim, Yunjin Park, Junhyung Moon, Dongyoung Jeong, Wanjin Park "Guard Vector: Beyond English LLM Guardrails with Task-Vector Composition and Streaming-Aware Prefix SFT.", COLM 2026.
- 발표 논문: https://arxiv.org/abs/2509.23381
[3] Jaehyun Nam, Jinsung Yoon, Yanzhou Pan, Yubo Wang, Rui Meng, Parthasarathy Ranganathan, Tomas Pfister, "ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI", 2026.
- 발표 논문: https://arxiv.org/abs/2609.19644
[4] Haneul Yoo, Jiho Jin, Kyunghyun Cho, Alice Oh, "Gradual Code-Switching as Inference-Time Cross-Lingual Representational Alignment for LLMs", COLM 2026.
- 발표 논문: https://arxiv.org/abs/2510.05678
[5] Jonathan Nemitz, Carsten Eickhoff, Junyi Jessy Li, Kyle Mahowald, Michal Golovanevsky, William Rudman, "When to Call an Apple Red: Humans Follow Introspective Rules, VLMs Don't", COLM 2026.
- 발표 논문: https://arxiv.org/abs/2604.06422
- 이미지 출처: 현장 사진은 작성자 촬영, 논문 그림은 각 논문 원문에서 인용