들어가며
안녕하세요. Agentic AI Lab에서 AutoModelRouter를 연구하고 개발하는 김경환, 박연수, 백두산, 안종훈, 이성원, 최진국입니다.
요즘 사용할 수 있는 LLM이 정말 많아졌습니다. GPT-6 Astra, Claude Opus 5.5 같은 고성능 모델부터 Gemini 3.8 Flash, Qwen3.8 Flash 같은 가벼운 모델까지 선택지가 넓어졌습니다. 그만큼 "이 질문에는 어떤 모델을 써야 만족할 만한 응답을 얻으면서 비용을 절감할 수 있을까?"라는 고민도 함께 생겼습니다.
이 문제를 해결하기 위해 저희 팀은 AutoModelRouter를 개발하였습니다. AutoModelRouter는 질문을 (작업, 분야, 난이도)로 분류한 뒤, 그 조합에서 성능 대비 비용이 가장 좋은 모델에 질문을 보냅니다. 자세한 내용은 AutoModelRouter에 대해 자세히 소개한 [LLM 응답 품질은 향상시키고, 비용을 최적화하는 Model Router ]를 참고 부탁드립니다.
그런데 AutoModelRouter를 만들고 나니 궁금한 점이 생겼습니다. 우리 Router는 실제로 얼마나 잘할까, 그리고 vLLM Semantic Router, Azure Router처럼 이미 알려진 LLM Router들과 비교하면 어느 정도 성능일지 측정하고 싶었습니다.
LLM Router는 어떻게 평가할까?
최근 학계와 업계 모두 다양한 방법론의 LLM Router를 발표하고 있습니다. GPT-5는 내부의 일반 모델과 Thinking 모델 중 질문에 맞는 모델로 요청을 자동으로 넘기는 라우팅을 핵심 기능으로 넣었고, Microsoft Foundry는 Azure Router를 적용하여 사용자 요청에 따라 모델을 선택하도록 하였습니다. 오픈소스로는 vLLM의 Semantic Router가 제안되었습니다. 그러나 이렇게 다양한 LLM Router마다 평가 방식과 지표가 제각각이라 어느 쪽이 더 나은지 비교하기 어렵다는 문제가 있었습니다.
RouterArena
미국 라이스대 연구팀은 이 문제를 해결하기 위해 RouterArena를 제안하였습니다. RouterArena는 모든 Router를 같은 문제와 같은 기준으로 채점하는 공개 리더보드입니다. 관련 연구는 머신러닝 분야 최우수 국제학술대회인 ICLR 2026 정식 논문으로도 채택되었습니다(논문).
데이터 구성
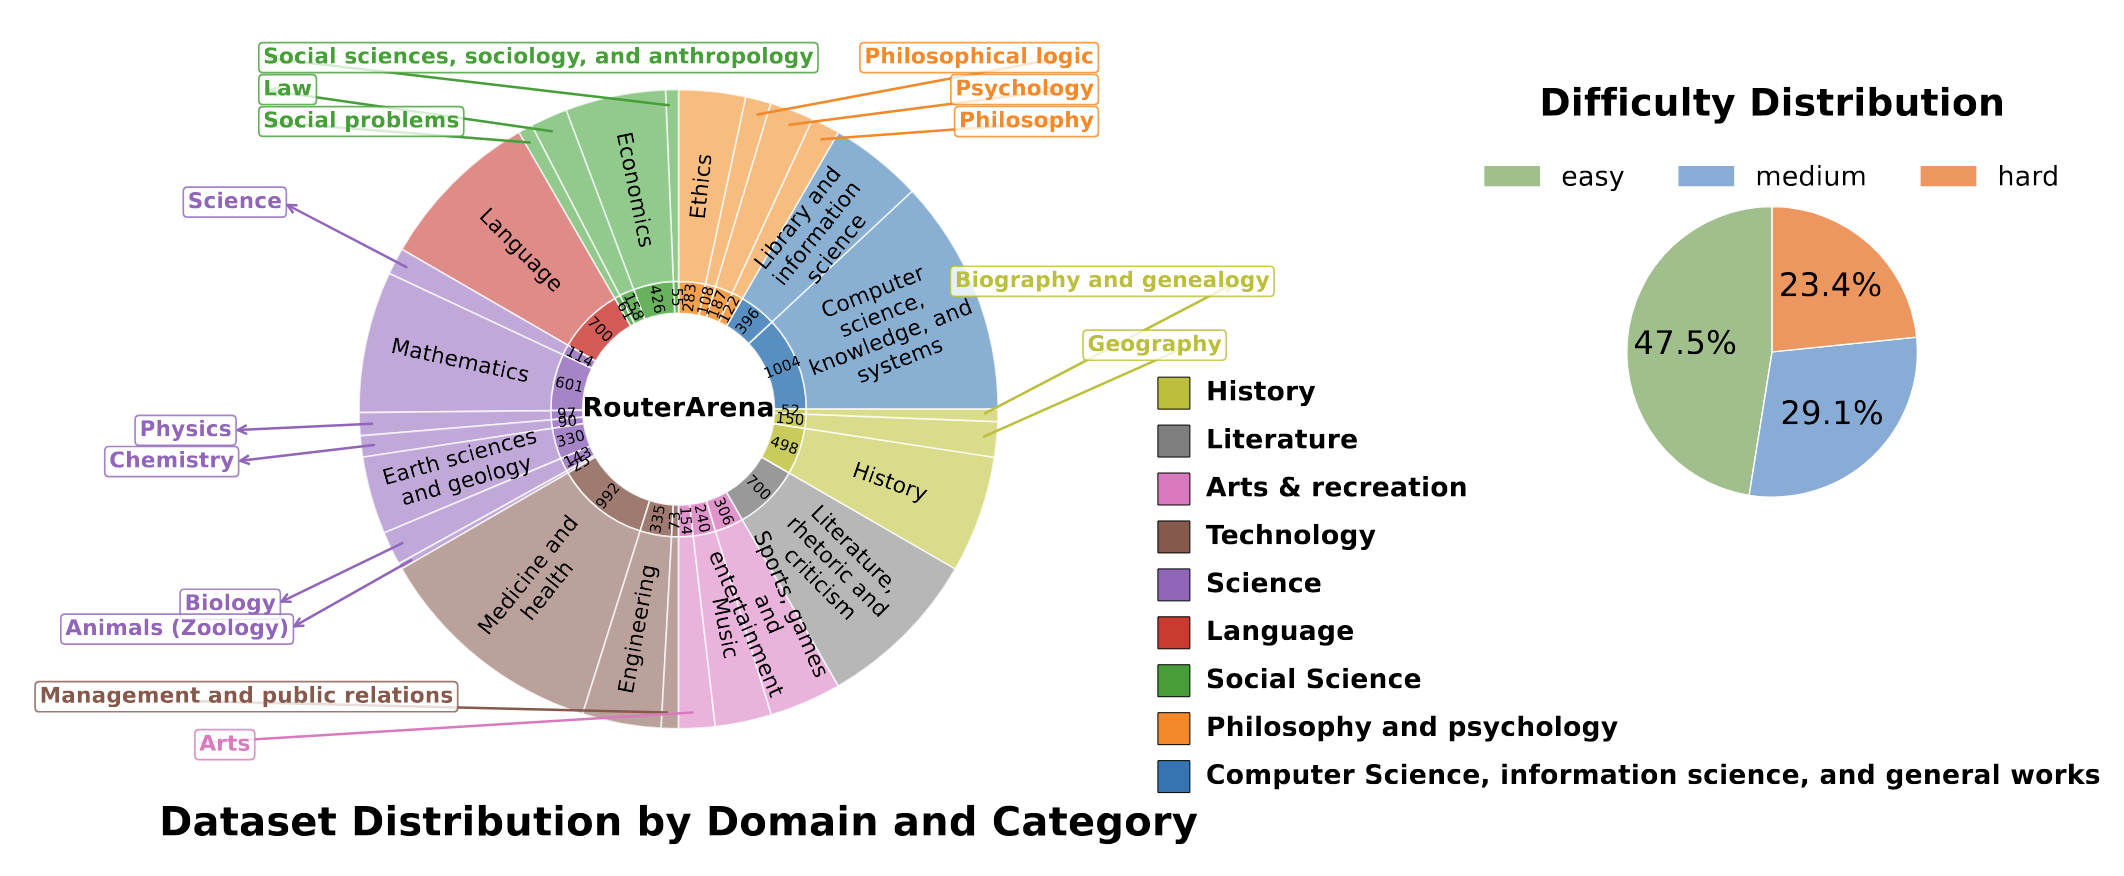
그림 1. RouterArena의 데이터 카테고리 분류 및 난이도 분포
RouterArena의 문제 영역은 도서관 분류법으로 널리 쓰이는 듀이 십진분류를 바탕으로 나뉘어 종교 분야를 제외한 9개의 상위 분야와 44개 하위 분야로 이루어져 있습니다.
문항의 난이도는 쉬움/보통/어려움으로 분류되며, 42개 모델에 같은 문제를 풀게 한 다음 몇 개 모델이 문제의 정답을 맞혔는지로 정했습니다. 20개 이상의 모델이 맞힌 문항은 쉬움, 5~19개 모델이 맞힌 문항은 보통, 4개 이하의 모델만 맞힌 문항은 어려움으로 분류됩니다.
데이터는 기존 LLM 벤치마크에서 문항을 넓게 모으고, 문항이 모자란 분야는 해당 분야의 특화 데이터셋으로 채워 약 6만 2천 개를 먼저 확보했습니다. 그다음 한 출처가 너무 많이 들어가지 않도록 출처마다 약 1,000문항으로 제한했고, 과학과 인문 분야의 비율은 2:1 정도로 맞췄습니다. 마지막으로 임베딩 유사도를 기준으로 거의 같은 문항을 걸러냈습니다.
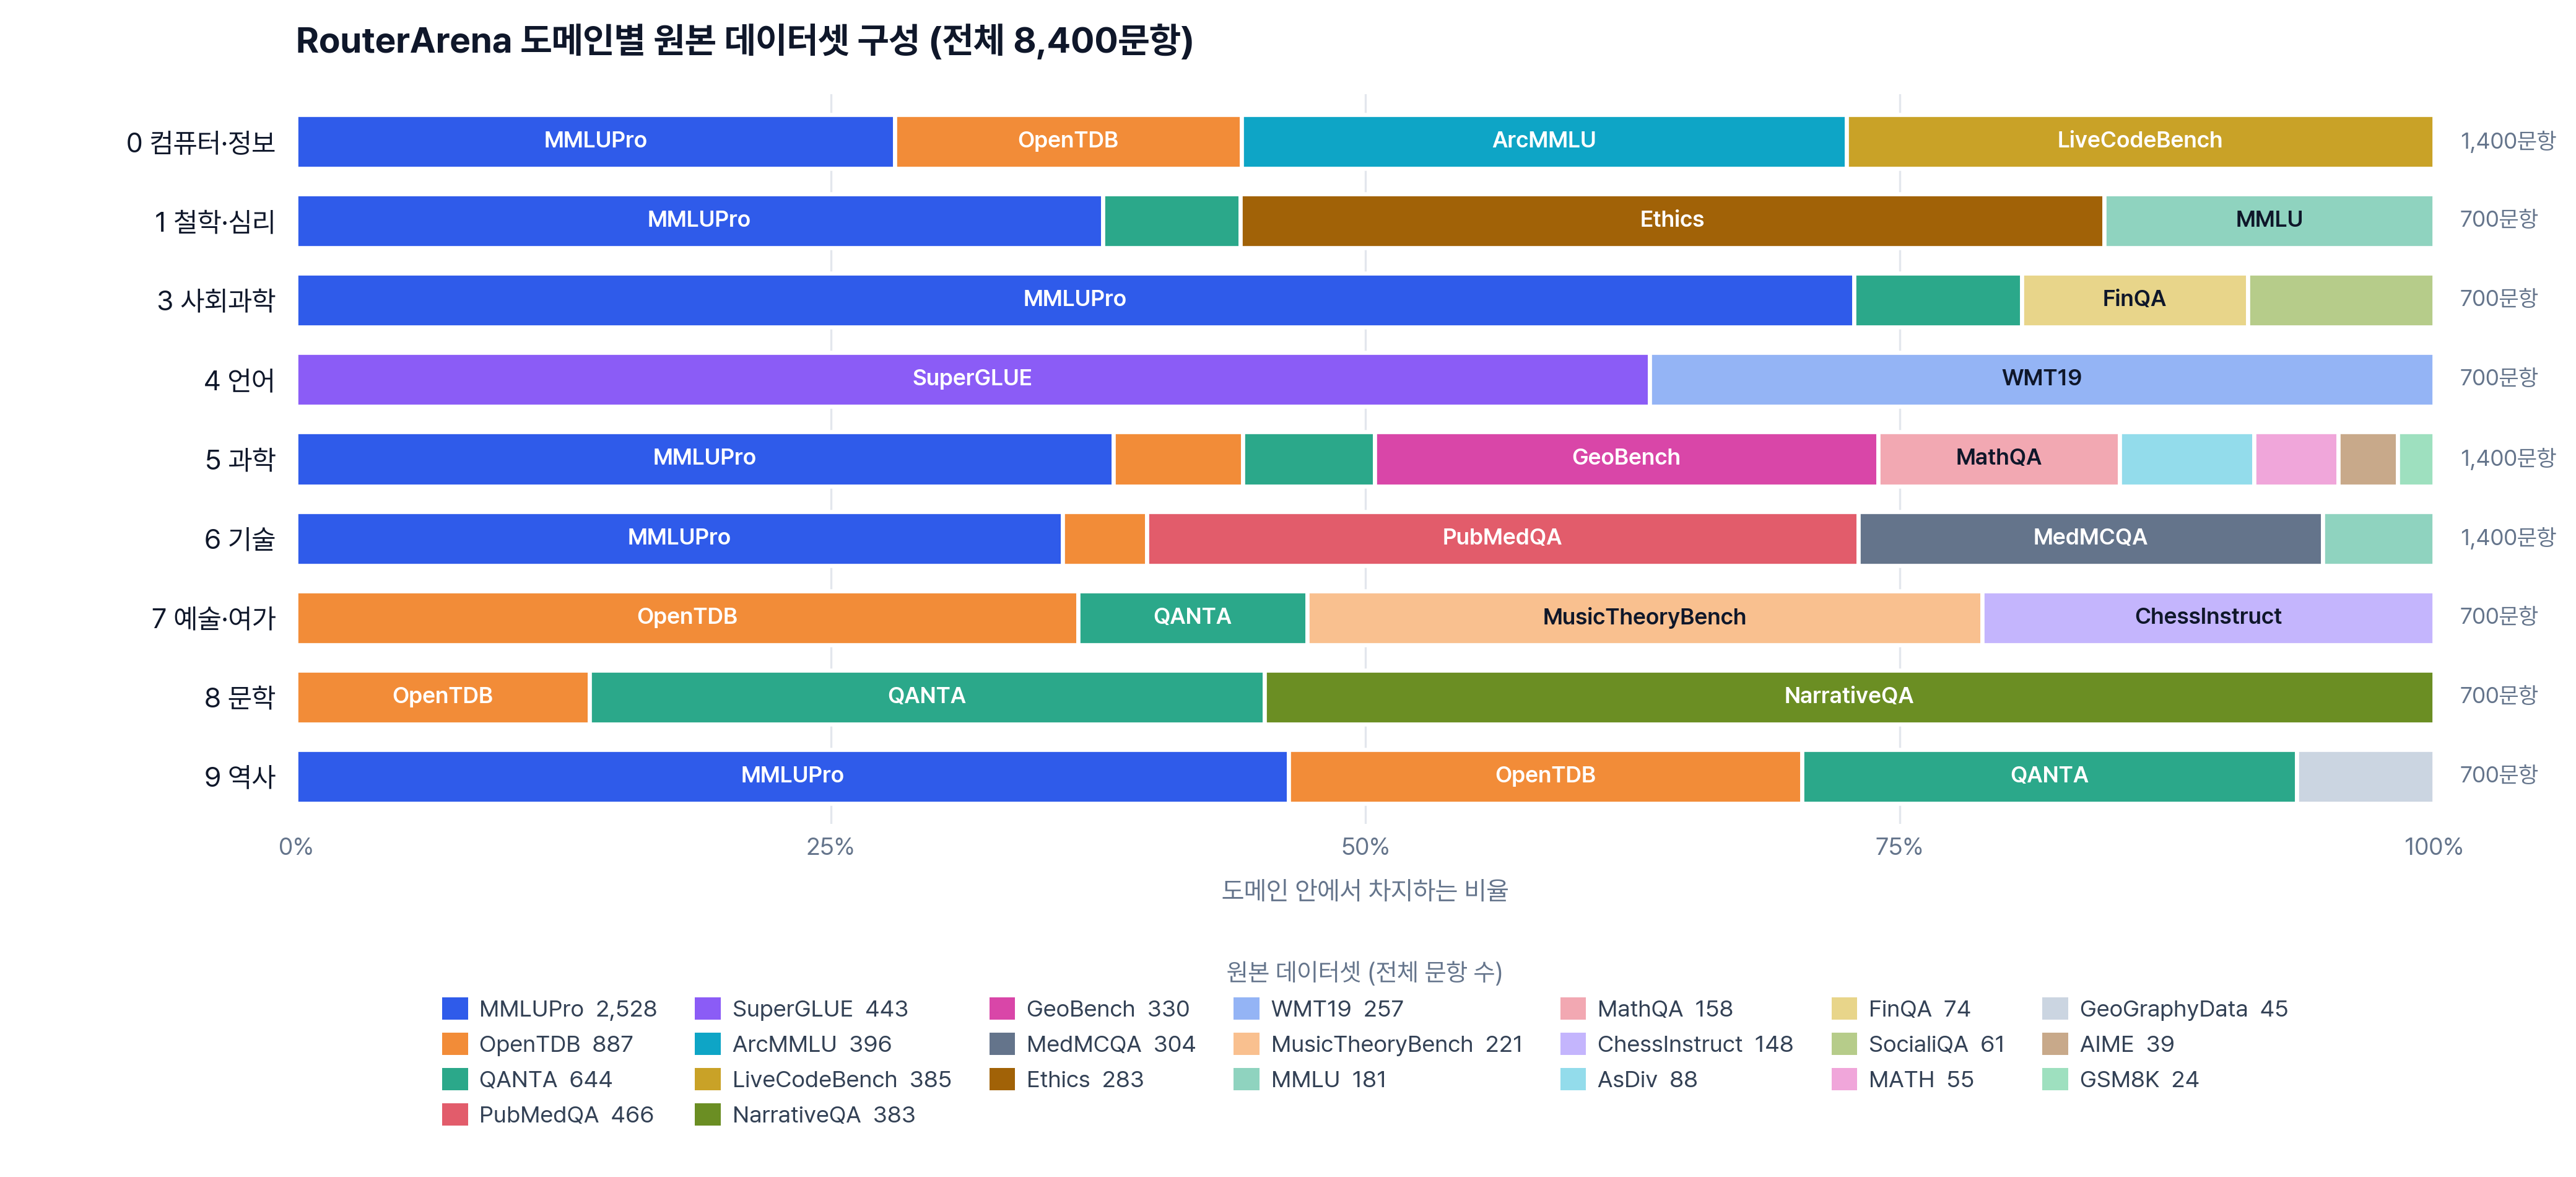
그림 2. 각 분야별 원본 벤치마크 출처 비율
이렇게 고른 총 8,400문항의 출처 구성은 그림 2와 같습니다.
ArenaScore
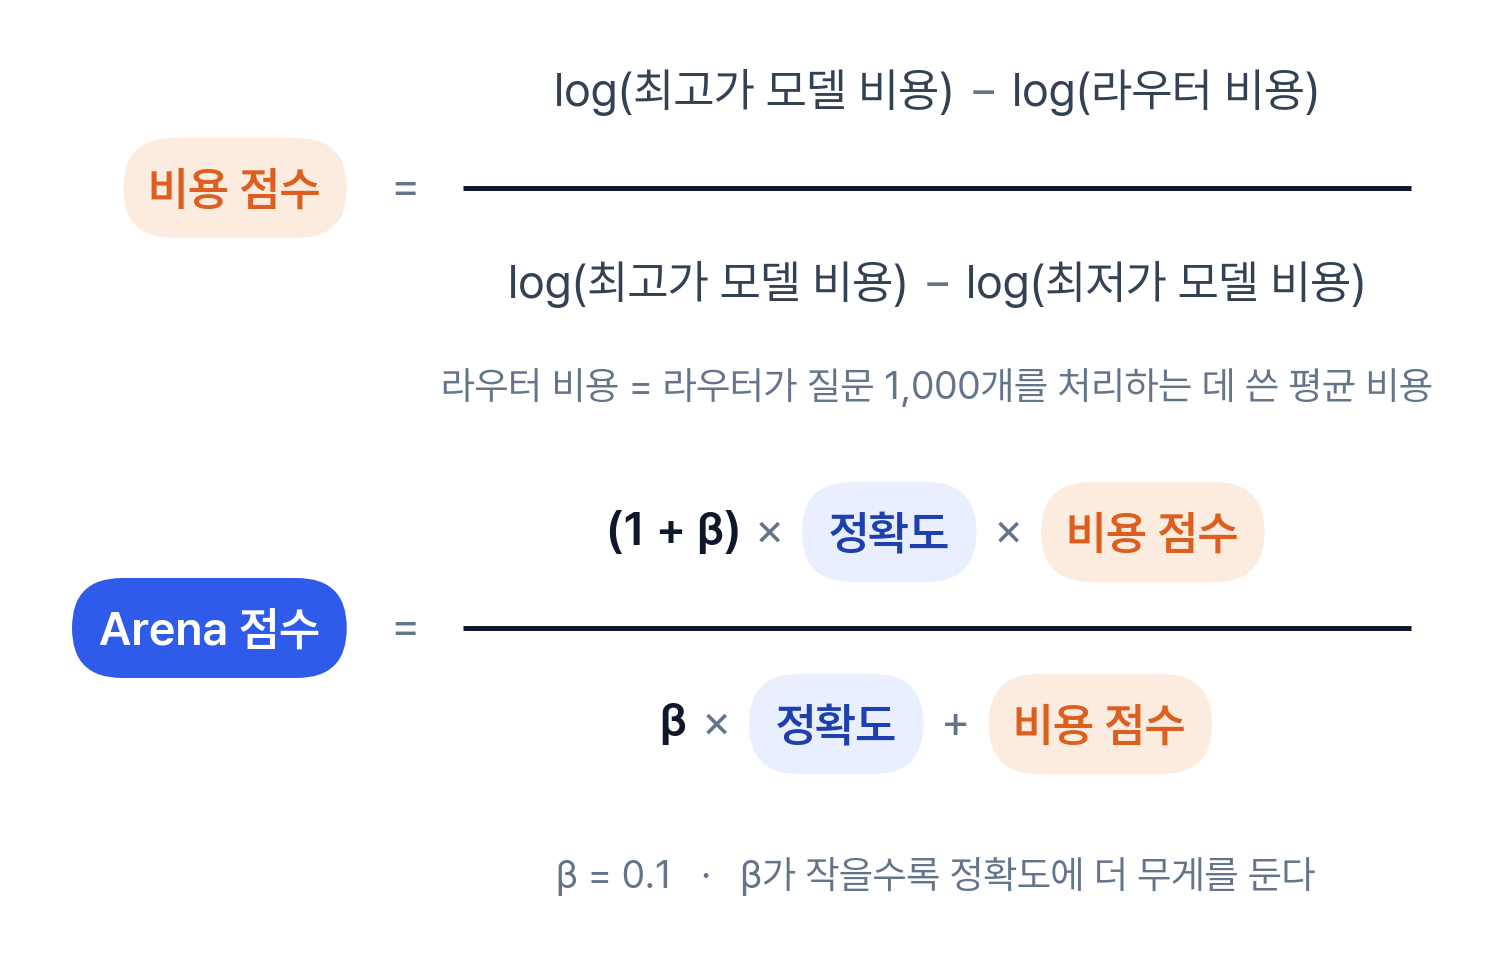
그림 3. ArenaScore 계산 방법
RouterArena는 Router를 정확도와 비용 두 가지 측면에서 평가합니다. 정확도(A)는 전체 문항 중 Router가 고른 모델이 정답을 낸 비율이고, 비용은 실제로 쓴 토큰 수와 가격으로 계산합니다. 비용은 1,000문항을 처리하는 데 드는 비용에 log₂를 취한 뒤, LLM Router 모델 풀에서 가장 저렴한 모델과 가장 비싼 모델의 비용을 양 끝으로 삼아 0~1 사이 값으로 정규화합니다(C). 저렴한 Router일수록 C가 1에 가깝습니다. ArenaScore는 이 두 값의 가중 조화평균으로, ArenaScore = (1+β)·A·C / (β·A + C)입니다. β가 작을수록 정확도의 비중이 커지는데, RouterArena는 비용이 조금 더 들더라도 정확한 Router가 더 가치 있다고 보고 기본값을 β = 0.1로 두었습니다.
AutoModelRouter의 RouterArena 풀이법
연습용 문제는 따로 만들기
AutoModelRouter는 연습 문제를 후보 모델들에게 미리 풀게 하고, 그 결과로 어떤 질문에 어떤 모델을 쓸지 규칙을 만듭니다. 그런데 RouterArena는 평가 문제를 학습이나 라우팅 조정에 쓰면 실격으로 처리합니다. 실제로 이 규칙을 어겨 리더보드에서 내려간 사례도 있습니다.
그래서 저희는 연습 문제를 따로 만들었습니다. RouterArena가 문제를 가져온 원본 벤치마크들로 돌아가서, RouterArena가 쓰지 않은 문제 중에서 1,976개를 새로 골랐습니다. 이를 위해 원본 40개 소스마다 전체 문제 수에서 RouterArena가 쓴 문제 수를 빼서, 실제로 쓸 수 있는 문제가 얼마나 남았는지 먼저 확인했습니다.
평가 문제와 글자까지 똑같은 문제는 제외했고, all-MiniLM-L6-v2 모델로 잰 임베딩 유사도가 0.85 이상인 문제도 함께 제외했습니다. 평가 문제가 연습 문제에 섞여 들어가 점수가 부풀려지는 일을 막기 위해서입니다.
또한 (작업, 분야, 난이도) 분포가 RouterArena 평가 문제와 비슷해지도록 문제를 골라, 실제 평가와 최대한 닮은 조건을 만들었습니다.
해당 데이터는 A-Autonomous Tech팀 Github에서 확인 하실 수 있습니다(링크 ).
운 좋은 1등을 걸러내기
AutoModelRouter는 질문을 (작업, 분야, 난이도) 라벨로 나누고, 라벨 조합마다 가장 잘하는 모델을 정해 둡니다.
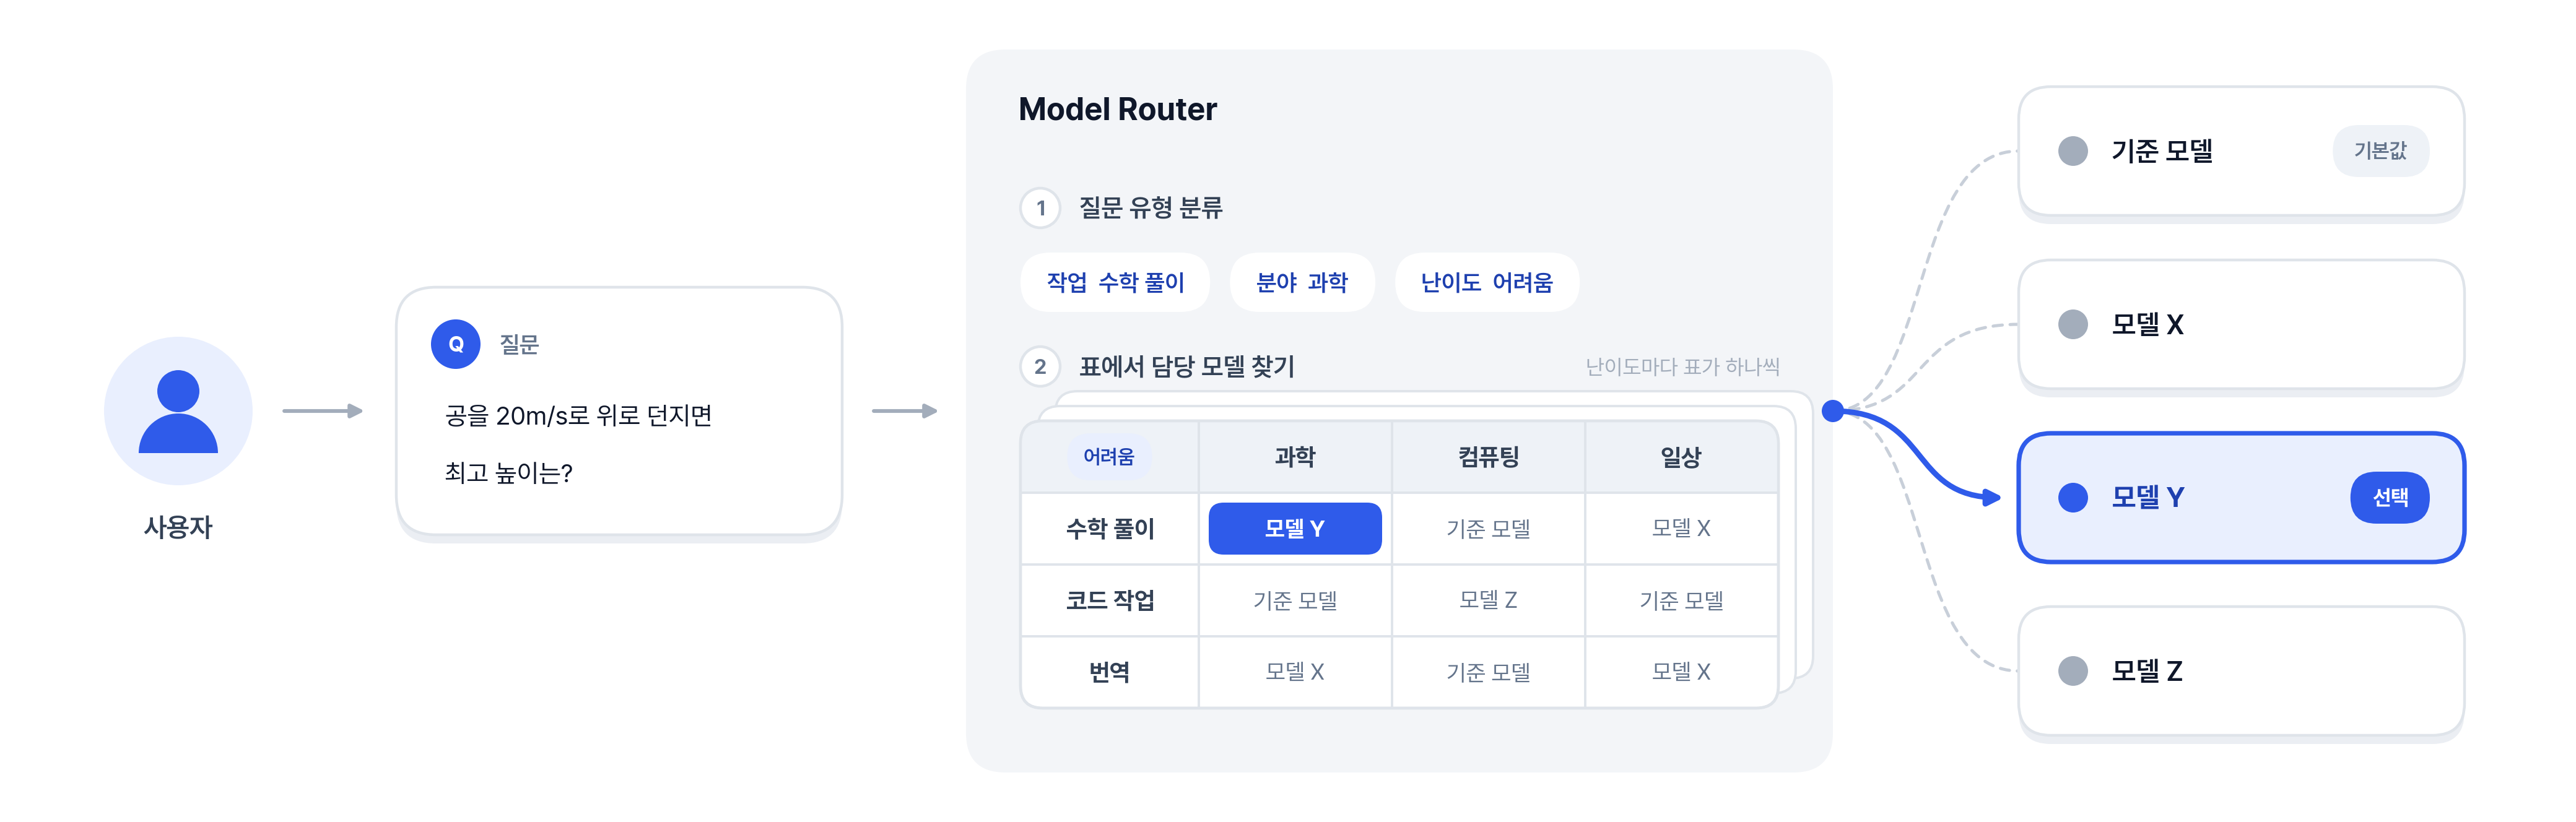
그림 4. 사용자 요청 기반 라우팅 과정
여기서 잘하는 모델은 연습 문제 결과로 정합니다. 라벨 조합마다 후보 모델들의 연습 문제 정답률과 비용으로 ArenaScore를 계산하고, 가장 높은 모델에 그 라벨의 질문을 맡깁니다. 예를 들어 (수학 풀이, 과학, 어려움) 라벨의 연습 문제에서 ArenaScore가 가장 높았던 모델이 실제 (수학 풀이, 과학, 어려움) 질문을 맡는 방식입니다.
그러나 여기에는 생각하지 못한 함정이 있었습니다. 연습 문제가 적으면 정답률이 운에 크게 흔들린다는 점입니다.
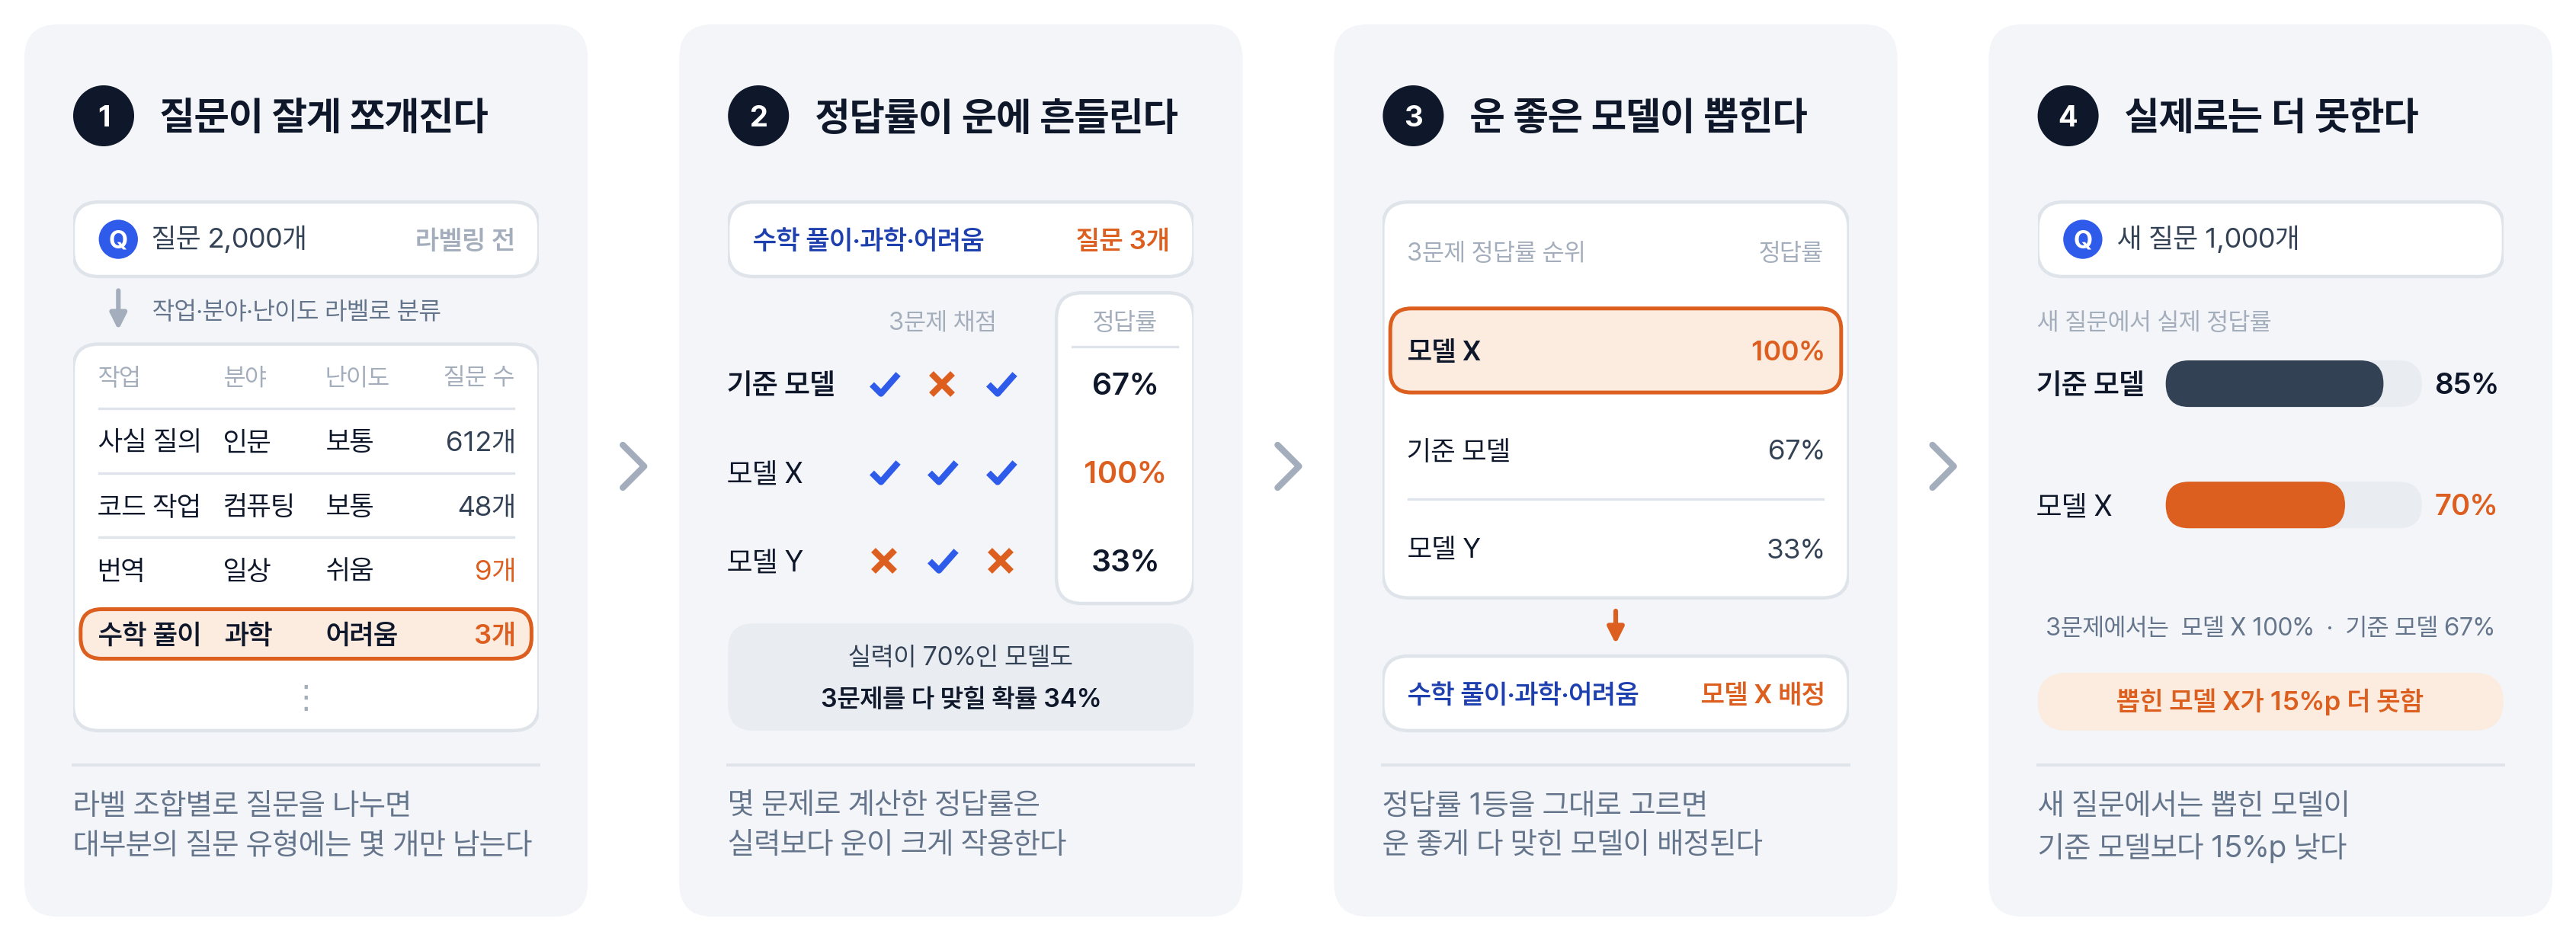
그림 5. 운에 의해 모델이 선택되는 과정
연습 문제가 2,000개여도 (작업, 분야, 난이도) 라벨로 잘게 나누다 보면 어떤 칸에는 문제가 굉장히 적게 남을 수 있습니다. 그림 5에서 (수학 풀이, 과학, 어려움) 라벨의 문제는 3개라고 가정했을 때 모델 X가 3문제를 모두 맞히면 정답률 100%로 1등이 되고, 이 칸은 모델 X가 맡게 됩니다.
하지만 이 결과만으로 모델 X가 해당 라벨의 문제를 실제로 잘 푼다고 보기는 어렵습니다. 실제로 (수학 풀이, 과학, 어려움) 라벨에서 평균 70% 정확도를 가진 모델도, 예시가 3문제뿐이라면 세 문제를 모두 맞힐 확률이 34%나 됩니다. 즉 세 번 중 한 번은 운만으로 만점이 나올 수 있다는 뜻입니다.
이처럼 적은 연습 문제에서 우연히 1등한 모델을 선택하면, 실제 (수학 풀이, 과학, 어려움) 질문이 들어왔을 때 결과가 뒤집힐 수 있습니다. 연습에서는 1등이던 모델 X가 운 좋게 1등한 모델이기에 실제 데이터에서는 오히려 성능이 떨어지는 것입니다.
확실할 때만 바꾸기
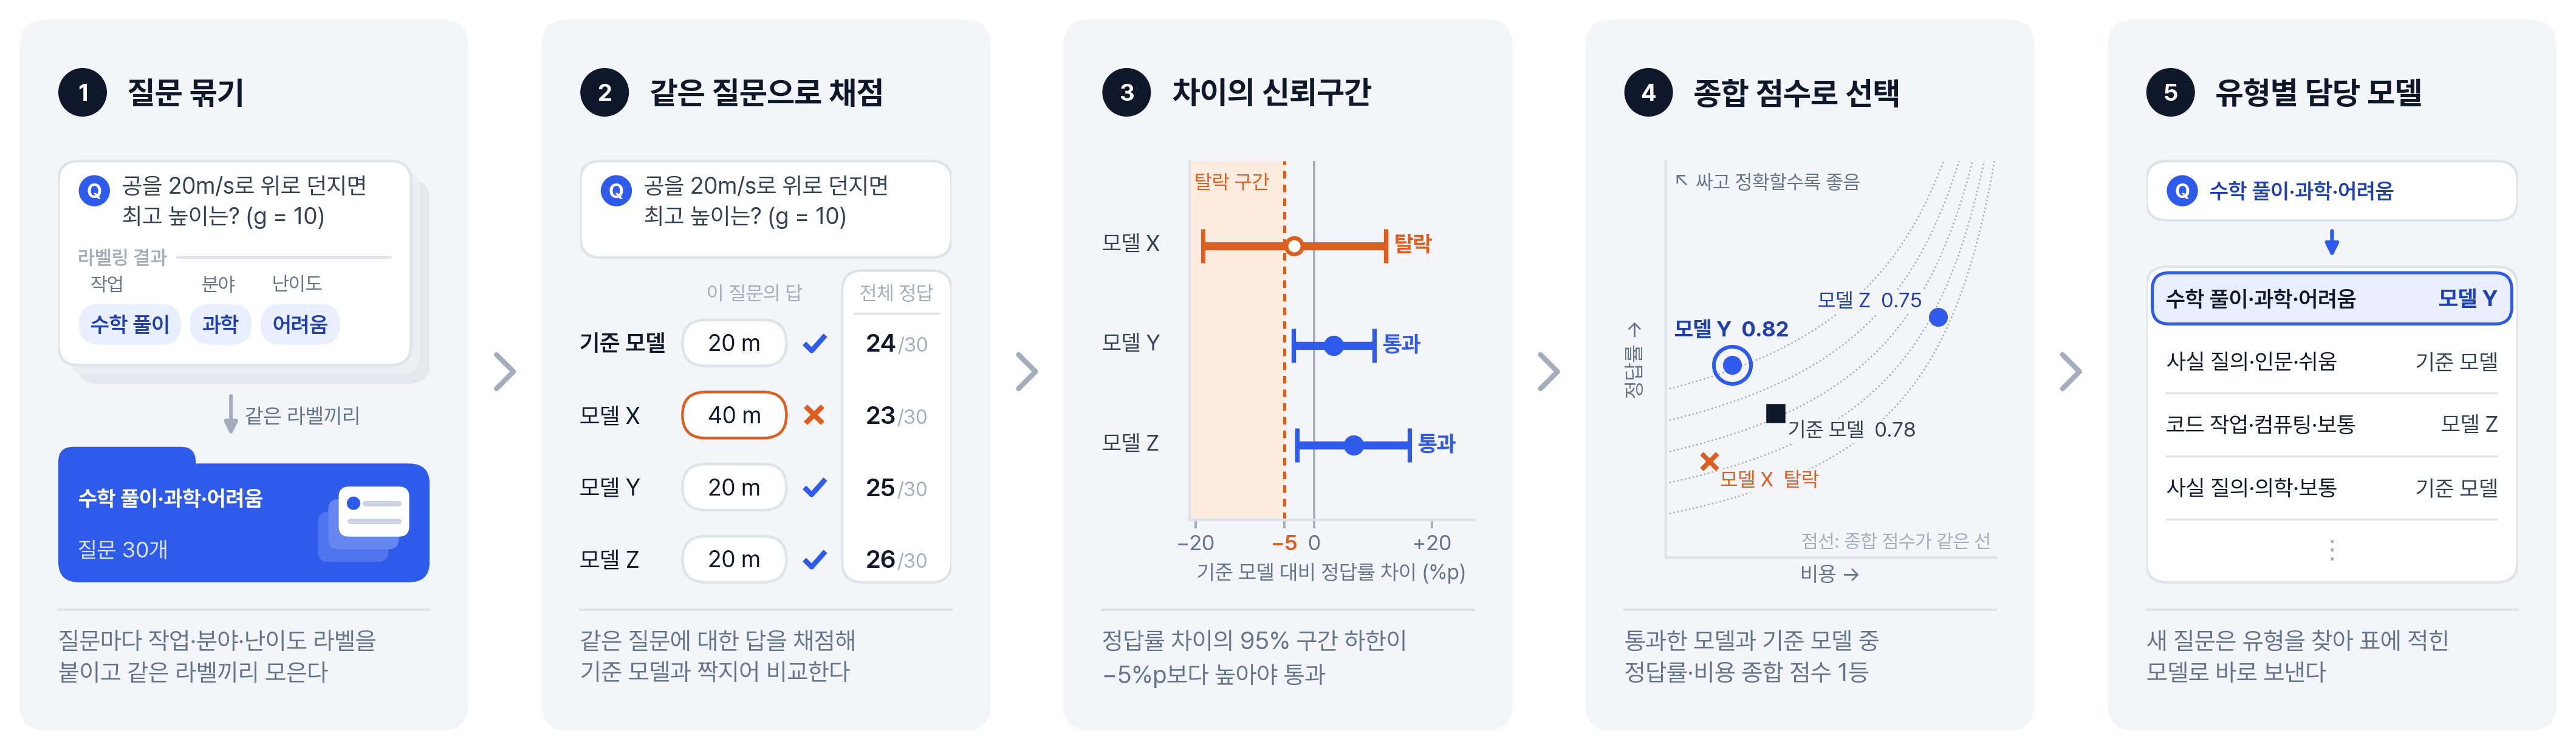
그림 6. 신뢰구간 기반 모델 선택 과정
운으로 점수를 잘 받는 모델을 걸러내기 위해 모델을 선택하는 규칙을 바꿨습니다. 그림 6.은 이 과정을 설명합니다. 각 (작업, 분야, 난이도)는 기본적으로 기준 모델이 맡고, 다른 모델로 바꾸려면 두 가지 조건을 모두 통과해야 합니다. 먼저 해당 (작업, 분야, 난이도)의 연습 문제가 20개 이상이어야 합니다. 20개가 되지 않는다면 성능을 보장할 수 있는 기준 모델을 선택합니다. 20개 이상이라면 같은 문제로 기준 모델과 비교했을 때, 정답률 차이의 95% 신뢰구간 아래쪽 끝이 −3%p보다 높아야 합니다. 최악의 경우에도 기준 모델보다 3%p 넘게 뒤처지지 않는다는 근거가 있을 때만 바꾸는 것입니다.
두 조건을 통과한 모델이 여럿이면 그중 정확도와 비용을 함께 본 ArenaScore가 가장 높은 모델을 고르고, 통과한 모델이 없으면 그 칸은 기준 모델이 그대로 맡습니다.
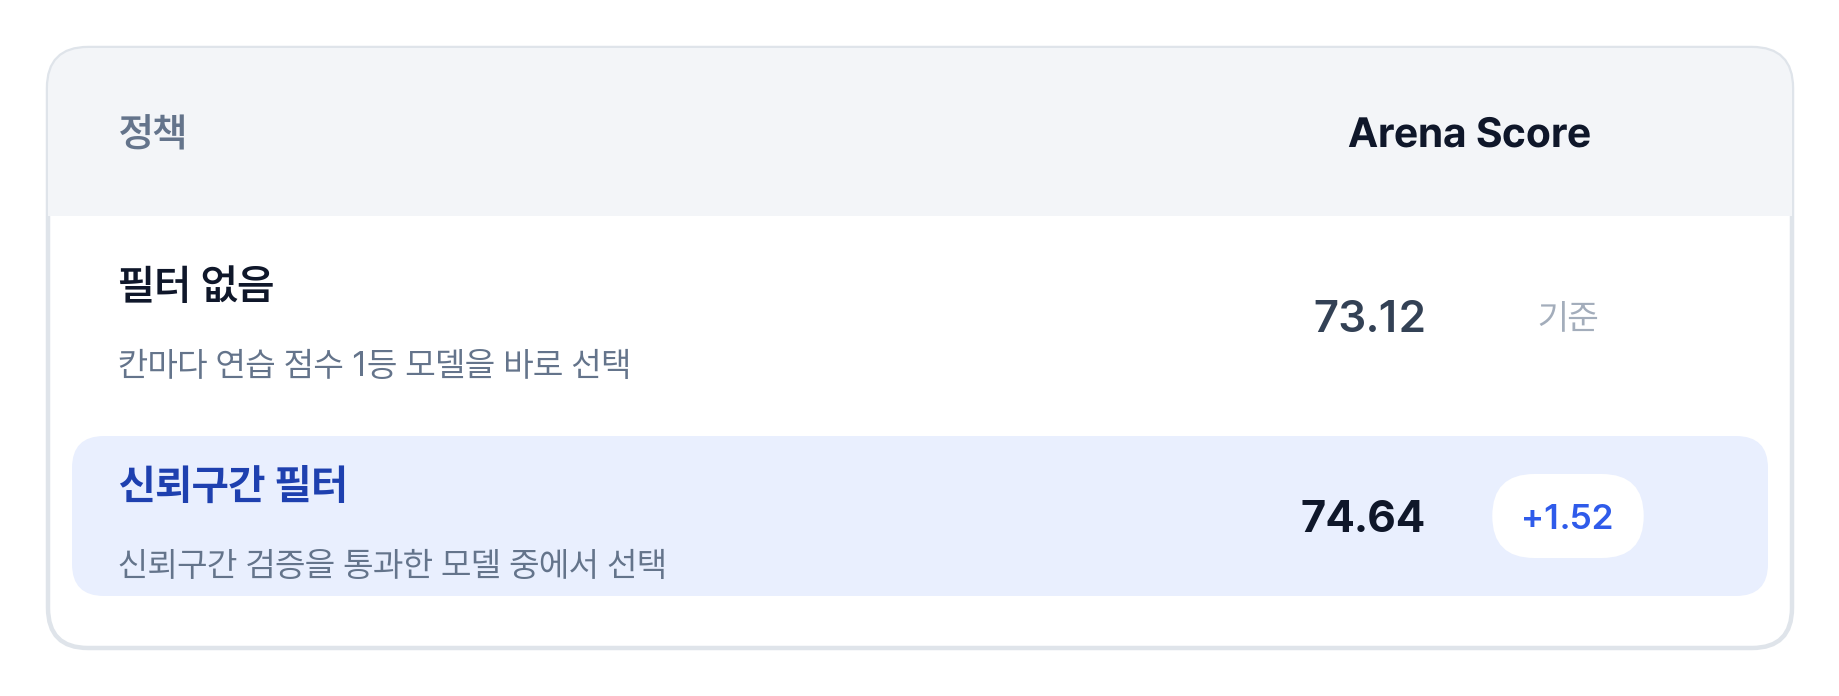
표 1. 신뢰구간 필터를 적용했을 때와 그렇지 않았을 때의 ArenaScore 차이
표 1.는 모델 선택 방식에 따른 ArenaScore 비교입니다.
신뢰구간 필터는 연습 문제 문항이 20개 이상인 라벨 분류에서, 기준 모델 대비 정답률 차이의 95% 신뢰구간 하한이 −3%p보다 큰 후보만 남기고, 그 중 ArenaScore가 가장 높은 모델을 선택하도록 하였습니다. 조건을 만족하는 후보가 없는 경우, 기준 모델에 할당하였습니다. 두 정책 모두 같은 후보 모델, 분류 체계를 사용했으며, 점수는 RouterArena 전체 문항 8,400개에서 측정했습니다. 이 8,400문항 결과는 신뢰구간 필터의 효과를 측정하는 데에만 사용했고, 리더보드 제출은 이 실험과 별도로 진행했습니다.
신뢰구간 필터 없이 라벨별로 연습 문제 ArenaScore가 가장 높은 모델을 그대로 선택한 정책은 73.12점인 반면 신뢰구간 필터를 적용한 정책은 74.64점으로 1.52점 높았습니다. 신뢰구간으로 우연히 좋은 점수를 받은 모델을 제외하자 손실이 사라지고 더 높은 ArenaScore를 얻을 수 있었습니다.
결과
AutoModelRouter는 [DeepSeek-v4-flash, DeepSeek-v4-pro, Gemma-4-31b-it, Gemini-3-flash-preview, Qwen3-235b-a22b-2507] 다섯 개 모델을 후보로, 그중 Gemma-4-31b-it을 기준 모델로 사용하여 결과를 제출했고, 최종 ArenaScore 76.3점으로 2026년 10월 26일 기준 RouterArena 리더보드에서 1위를 달성하였습니다(링크).
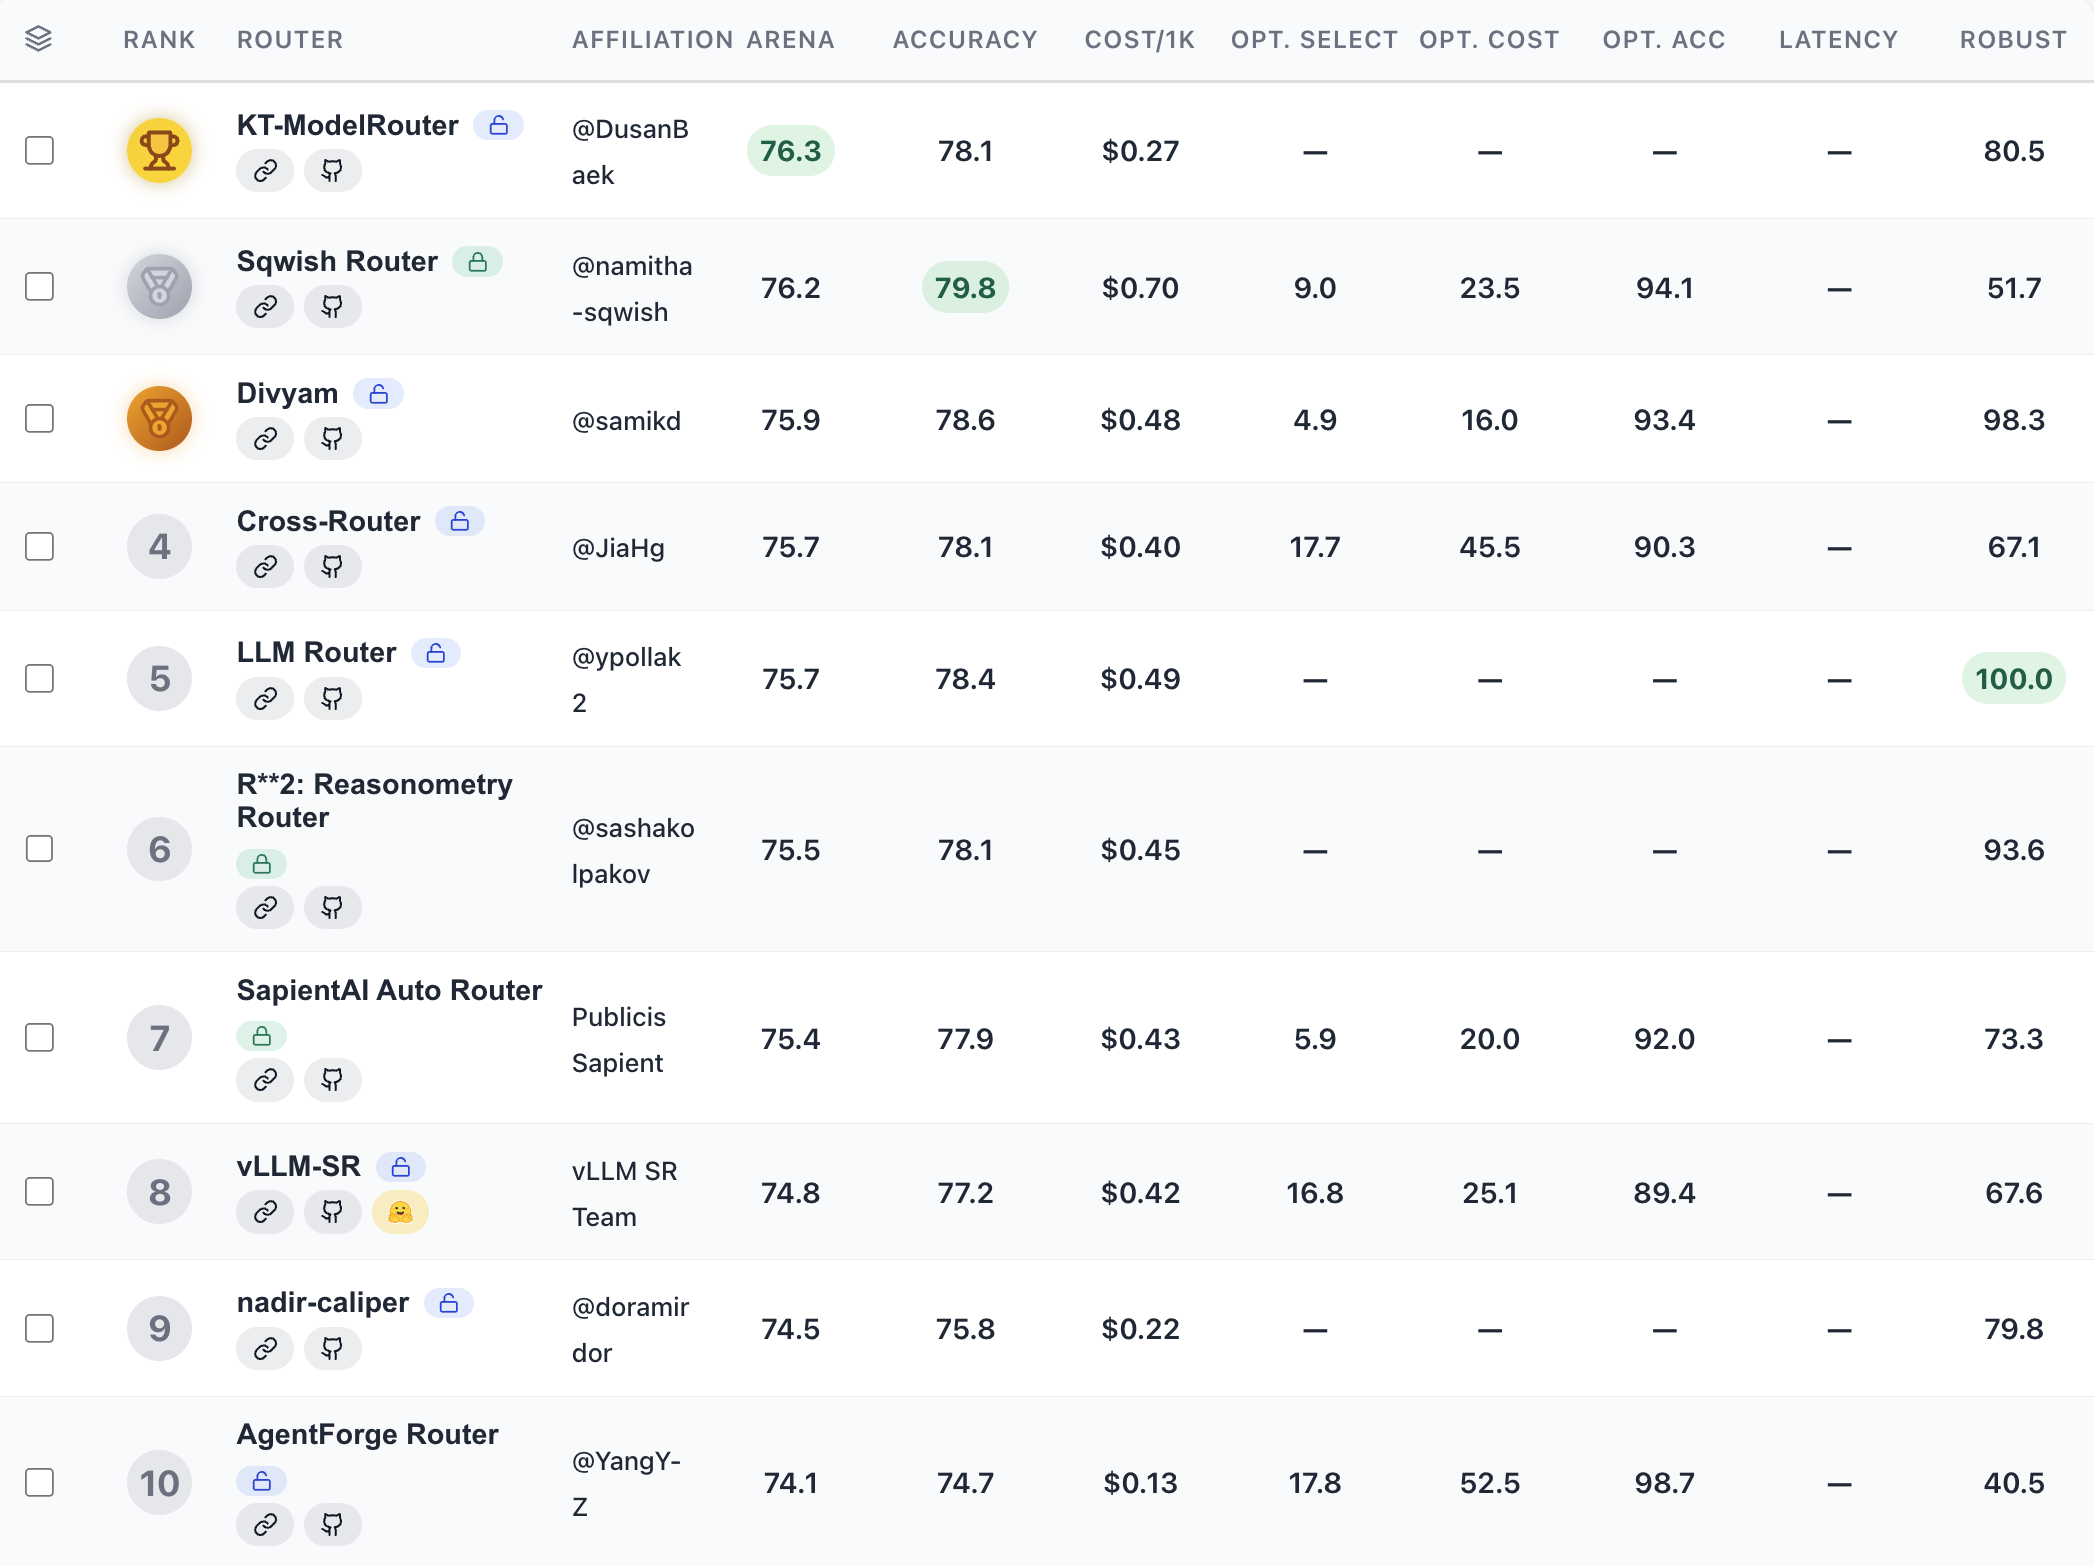
그림 7. 2026년 10월 26일 기준 RouterArena 공식 리더보드 1위 달성
눈여겨볼 부분은 비용입니다. 정확도는 2위 SqwishRouter보다 조금 낮지만, 비용이 절반에도 못 미쳐 종합 점수에서 앞섰습니다. 같은 후보 모델 중 가장 좋은 모델 하나만 쓴 경우와 비교하면, 정확도는 비슷하게 유지하면서 비용을 약 44% 줄였습니다.
다양한 분야와 난이도를 평가한 환경에서 최상위권 성능을 확인했다는 점에서 의미 있는 성과였습니다.
마치며
AutoModelRouter는 이제 KT의 Token Factory에서 실제 서비스로 사용할 수 있습니다. Token Factory는 여러 AI 모델을 한곳에서 연결하고 토큰 사용량과 비용을 관리하는 플랫폼입니다. AutoModelRouter는 그 안에서 요청마다 알맞은 모델을 골라 주는 모델 라우팅 기능을 맡습니다. 간단한 질문은 가볍고 저렴한 모델로, 어려운 질문은 고성능 모델로 보내 응답 품질은 지키면서 고객의 토큰 비용을 절감하는 것이 목표입니다.
앞으로는 단순 채팅/질의응답뿐 아니라 긴 작업을 처리해야 하는 코딩 작업과 도구를 쓰는 에이전트 작업까지 범위를 넓혀, 실행 성공률과 응답 속도까지 함께 고려하는 LLM Router로 발전시키려고 합니다.
RouterArena에서 확인한 경쟁력이 실제 서비스에서도 이어질 수 있도록, Token Factory 안에서 AutoModelRouter를 꾸준히 고도화해 나갈 계획입니다.